Семантические триплеты
Семантические триплеты из текстов конкурентов: какие факты приводят лидеры выдачи и каких нет на вашей странице - «субъект - связь - объект» с цитатой, в чём они сходятся и где расходятся.
- Факты топа
- Цитата у каждого
- Чего нет на странице
Как работает
Факты, в которых конкуренты единодушны
Впишите запрос
И регион; по желанию - свои конкуренты и своя страница.
Нейросеть вынимает факты
Из каждой страницы топа - тройками с дословной цитатой.
Программа склеивает
Общие факты, условия компаний, расхождения - и чего нет на вашей странице.
Что получите
Опора для текста - факты, а не догадки
Итог
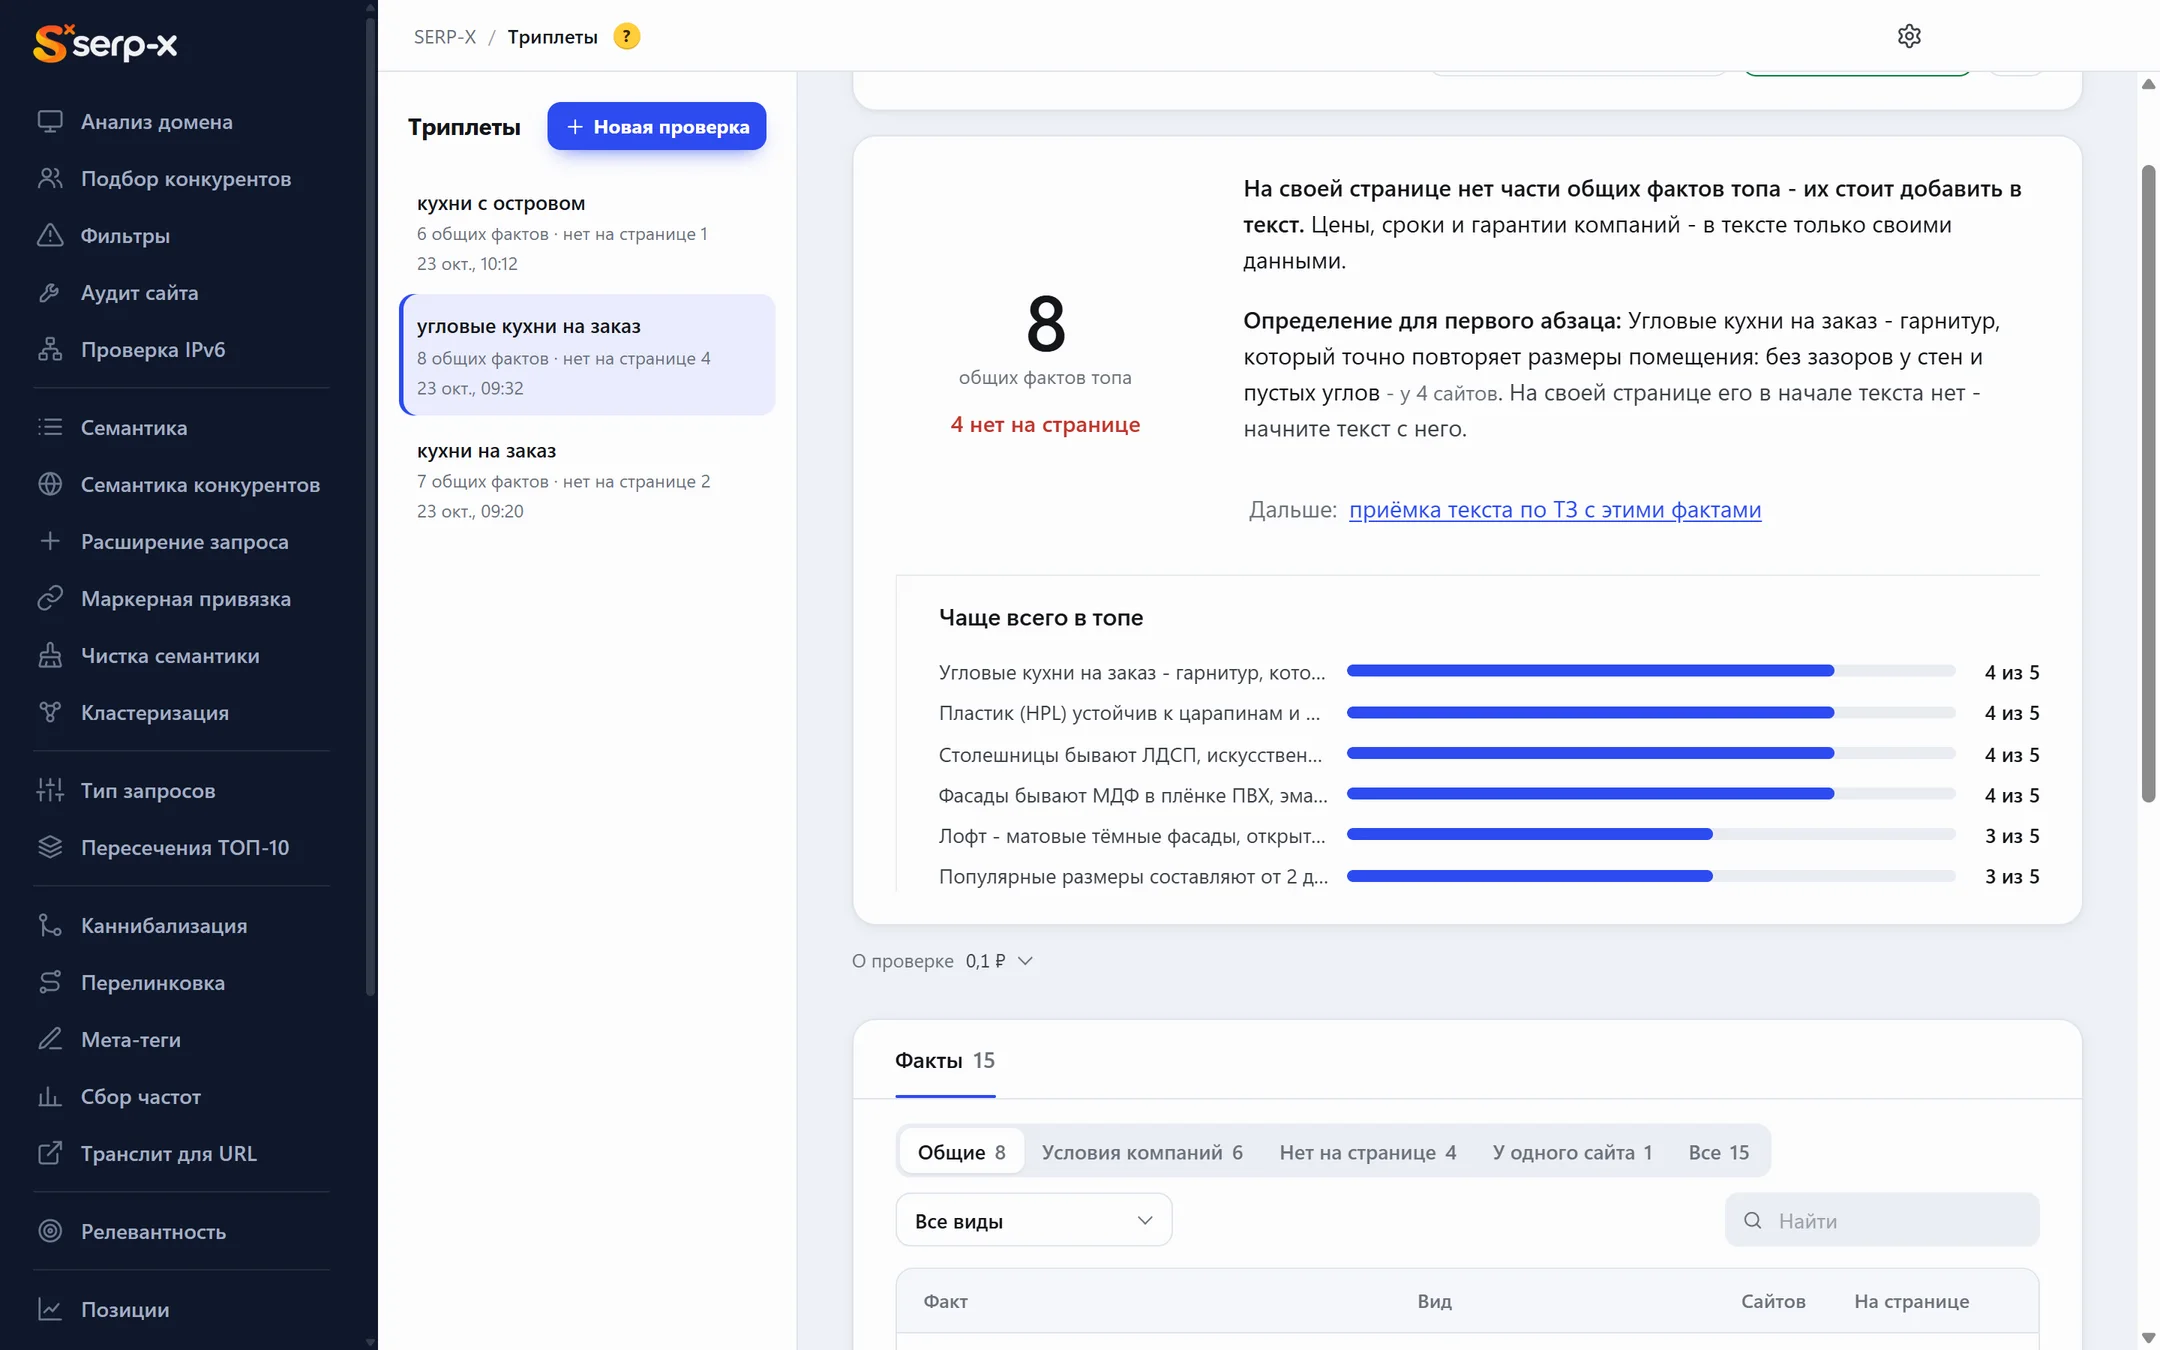
Сколько общих фактов в топе, сколько нет на странице и определение для первого абзаца.
- Самые частые факты
- Определение - готовое
- Дальше - приёмка по ТЗ
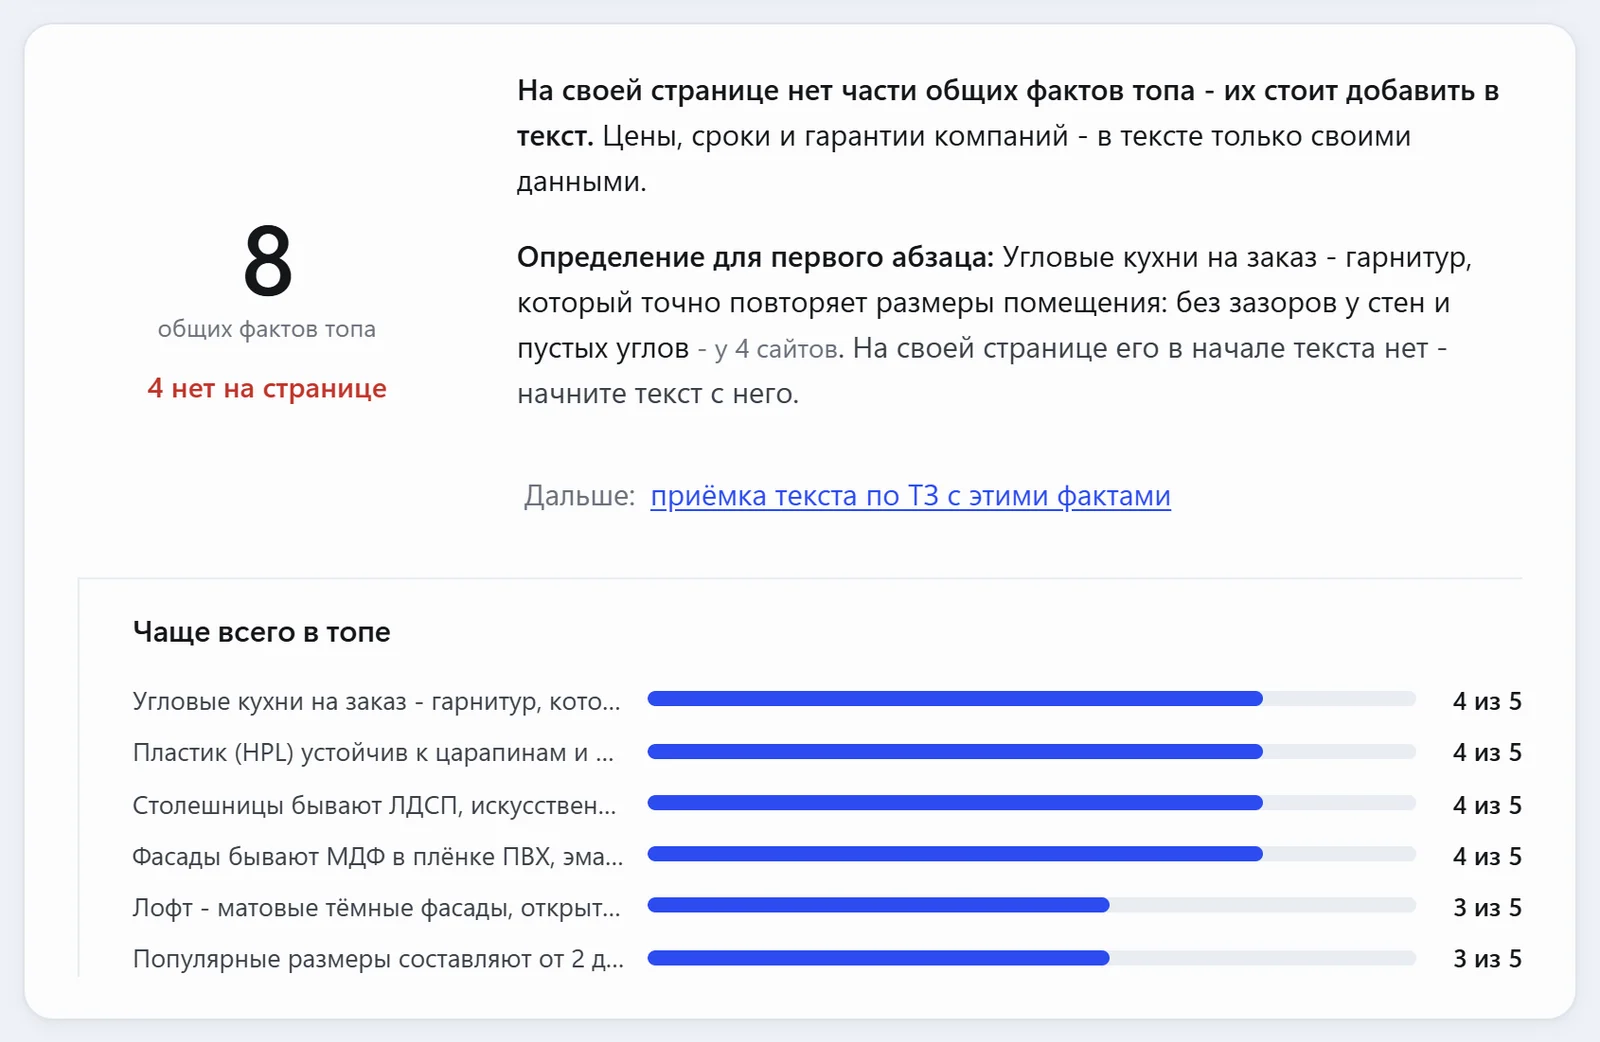
Общие факты
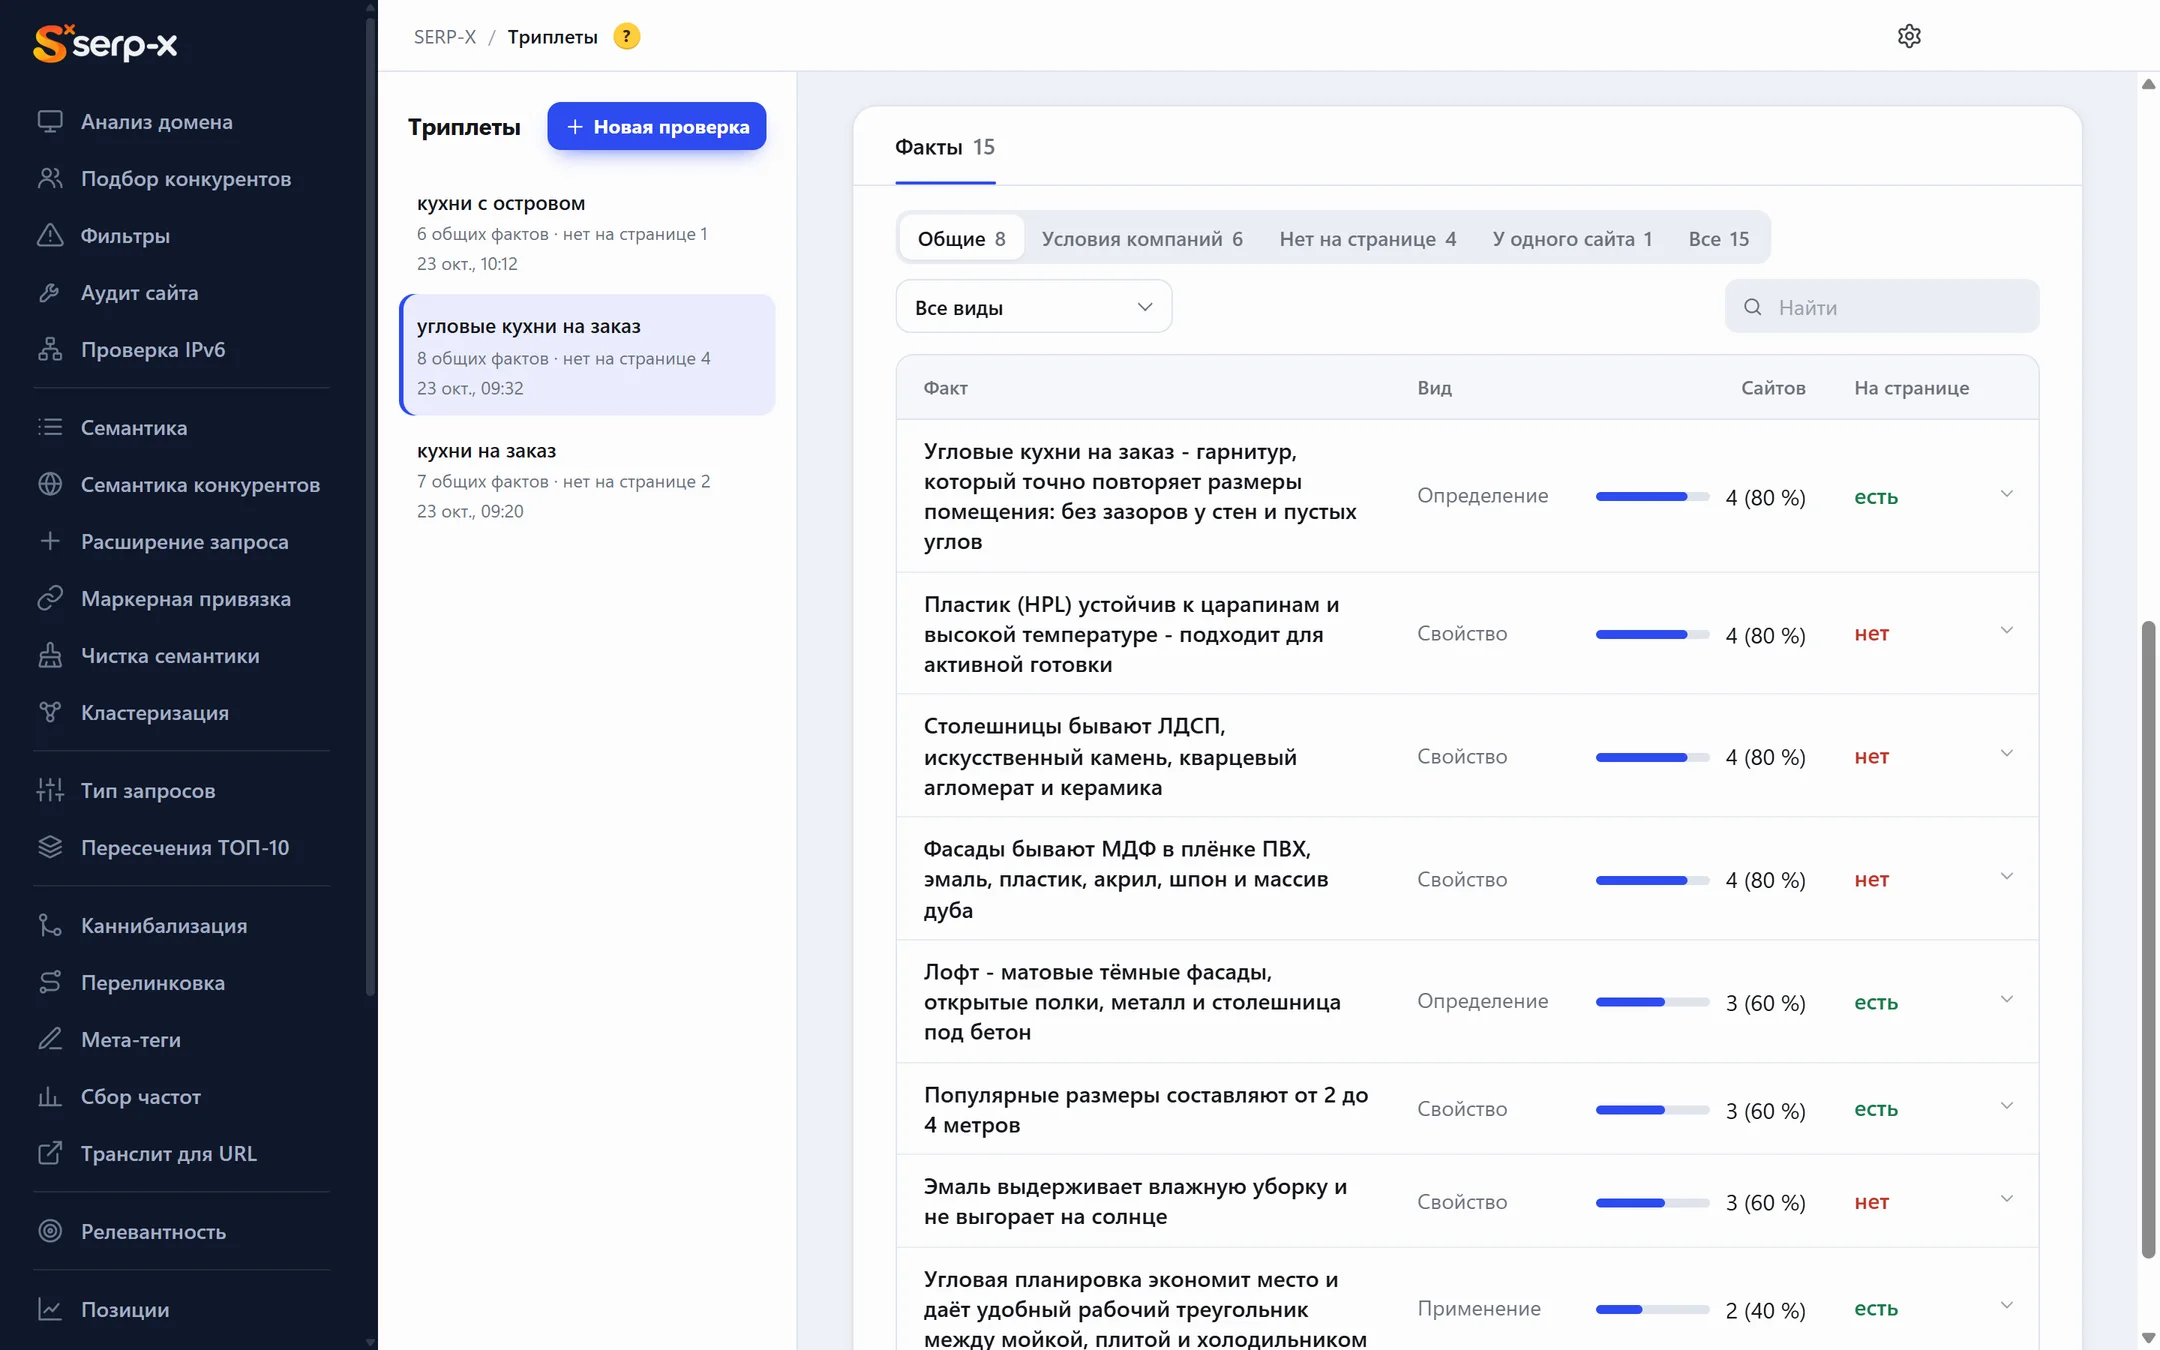
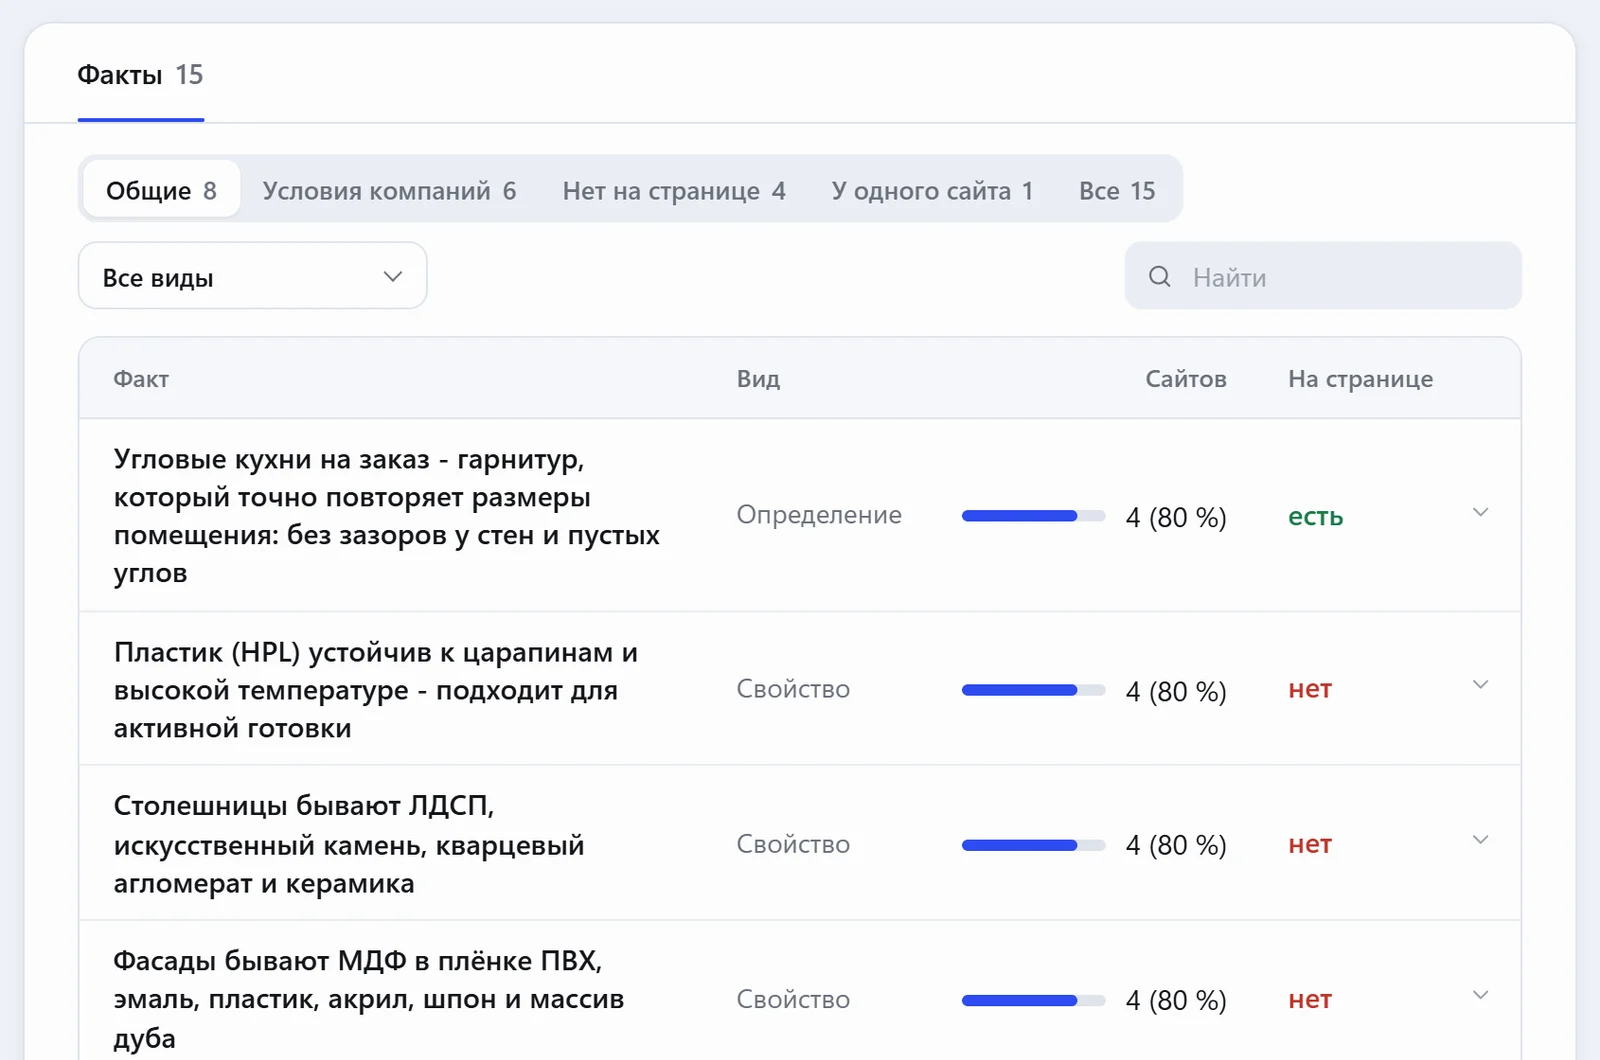
Факт, вид (определение, свойство, применение), у скольких сайтов есть и есть ли на странице.
- Отборы по видам
- Условия компаний - отдельно
- В строке - цитаты сайтов
Нет на странице
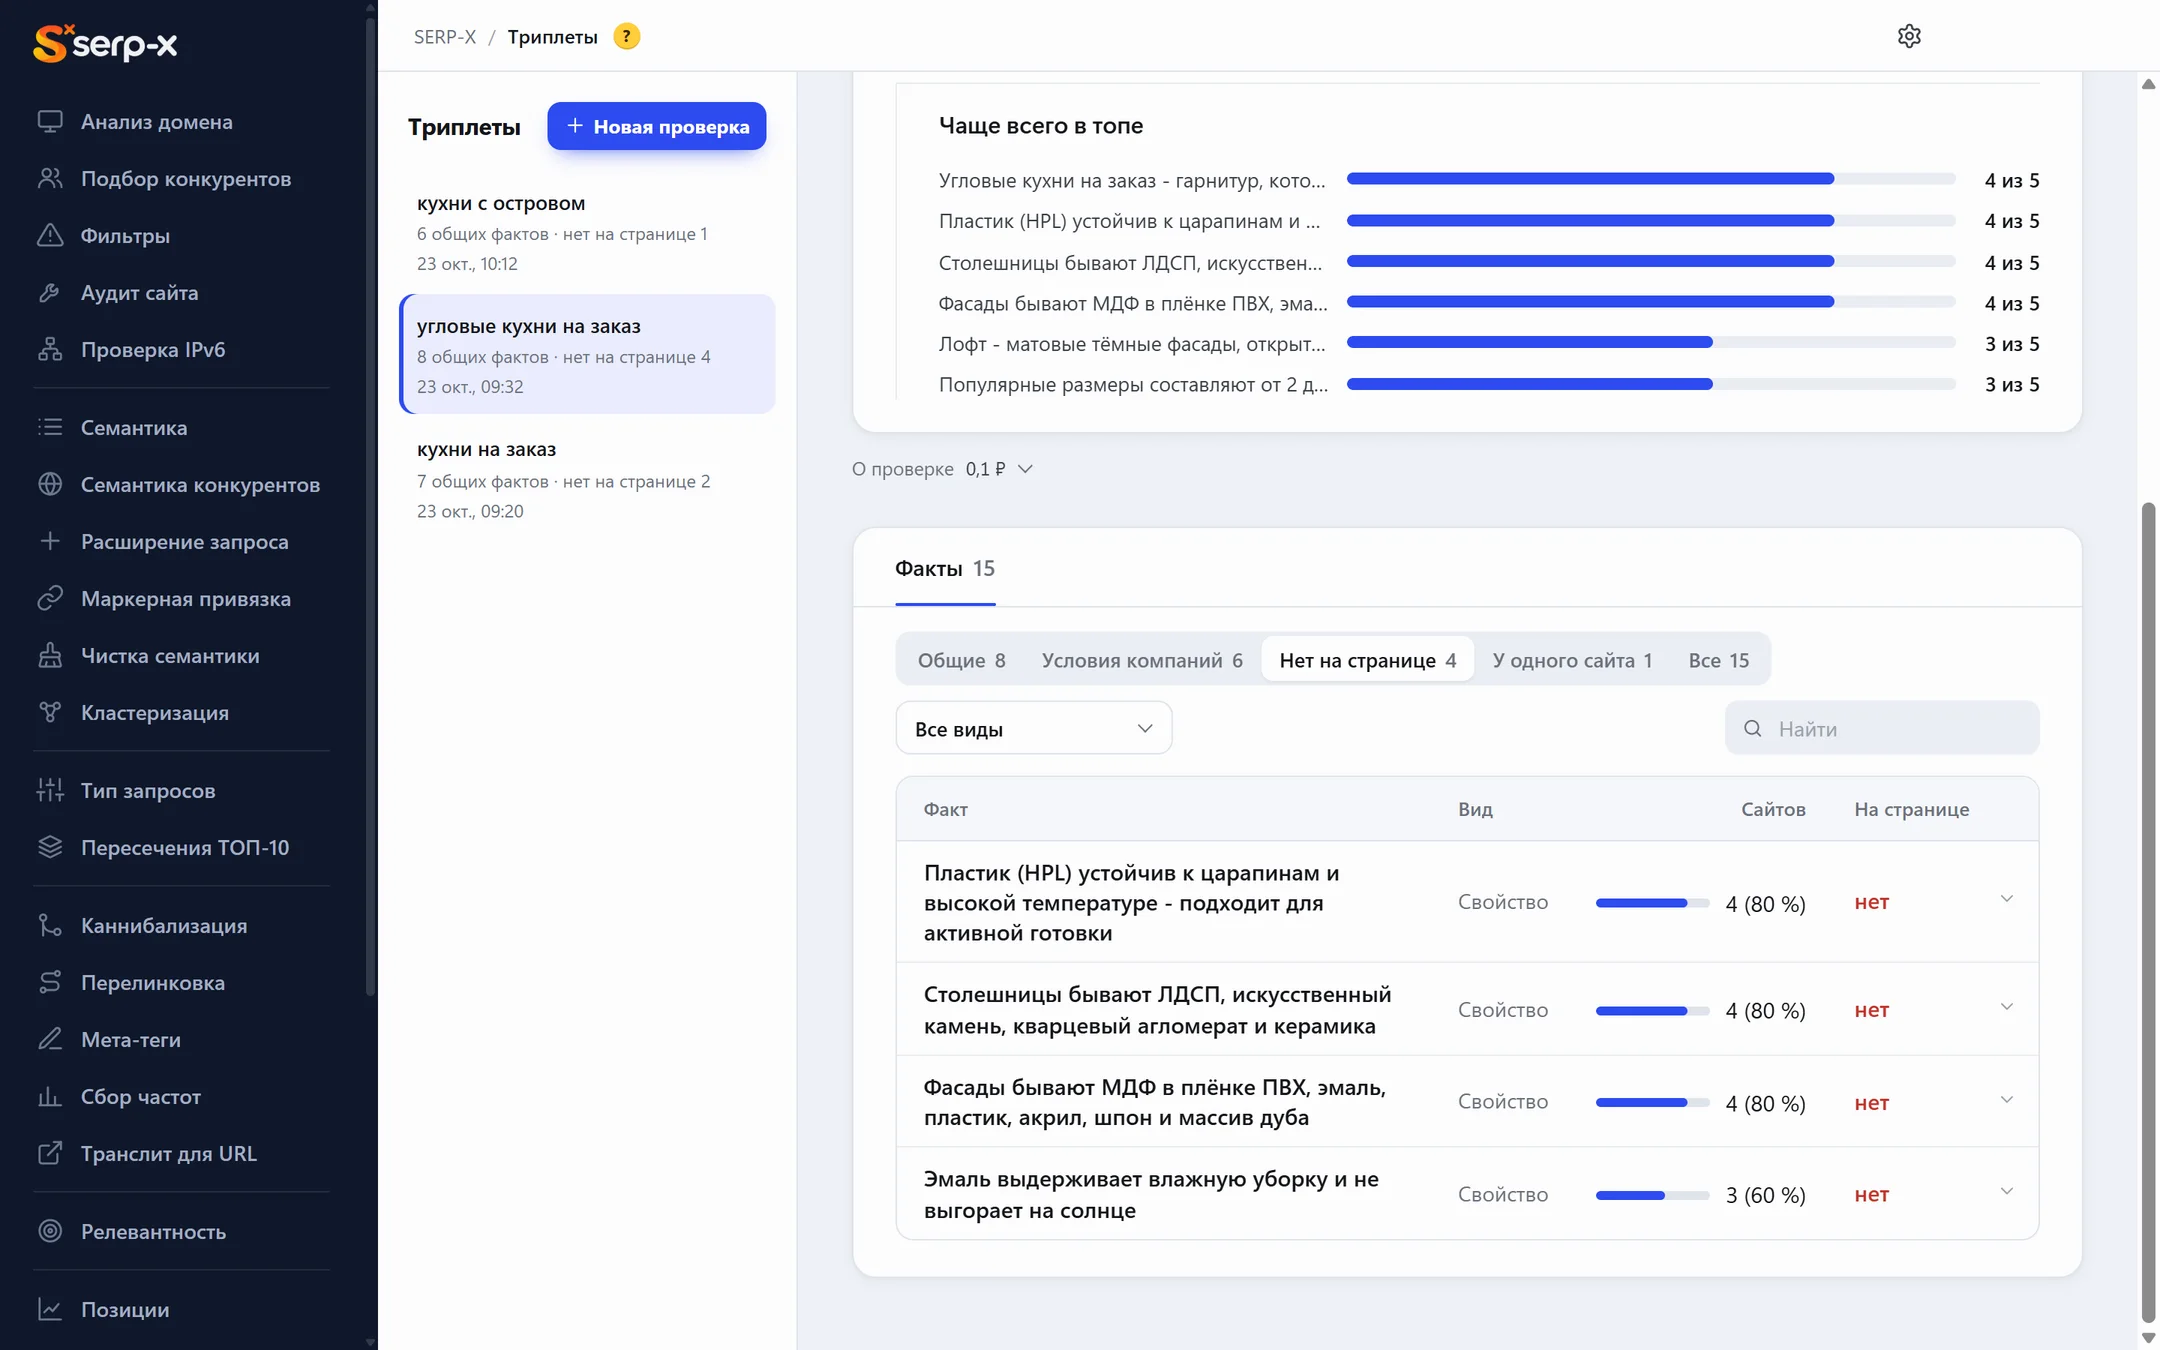
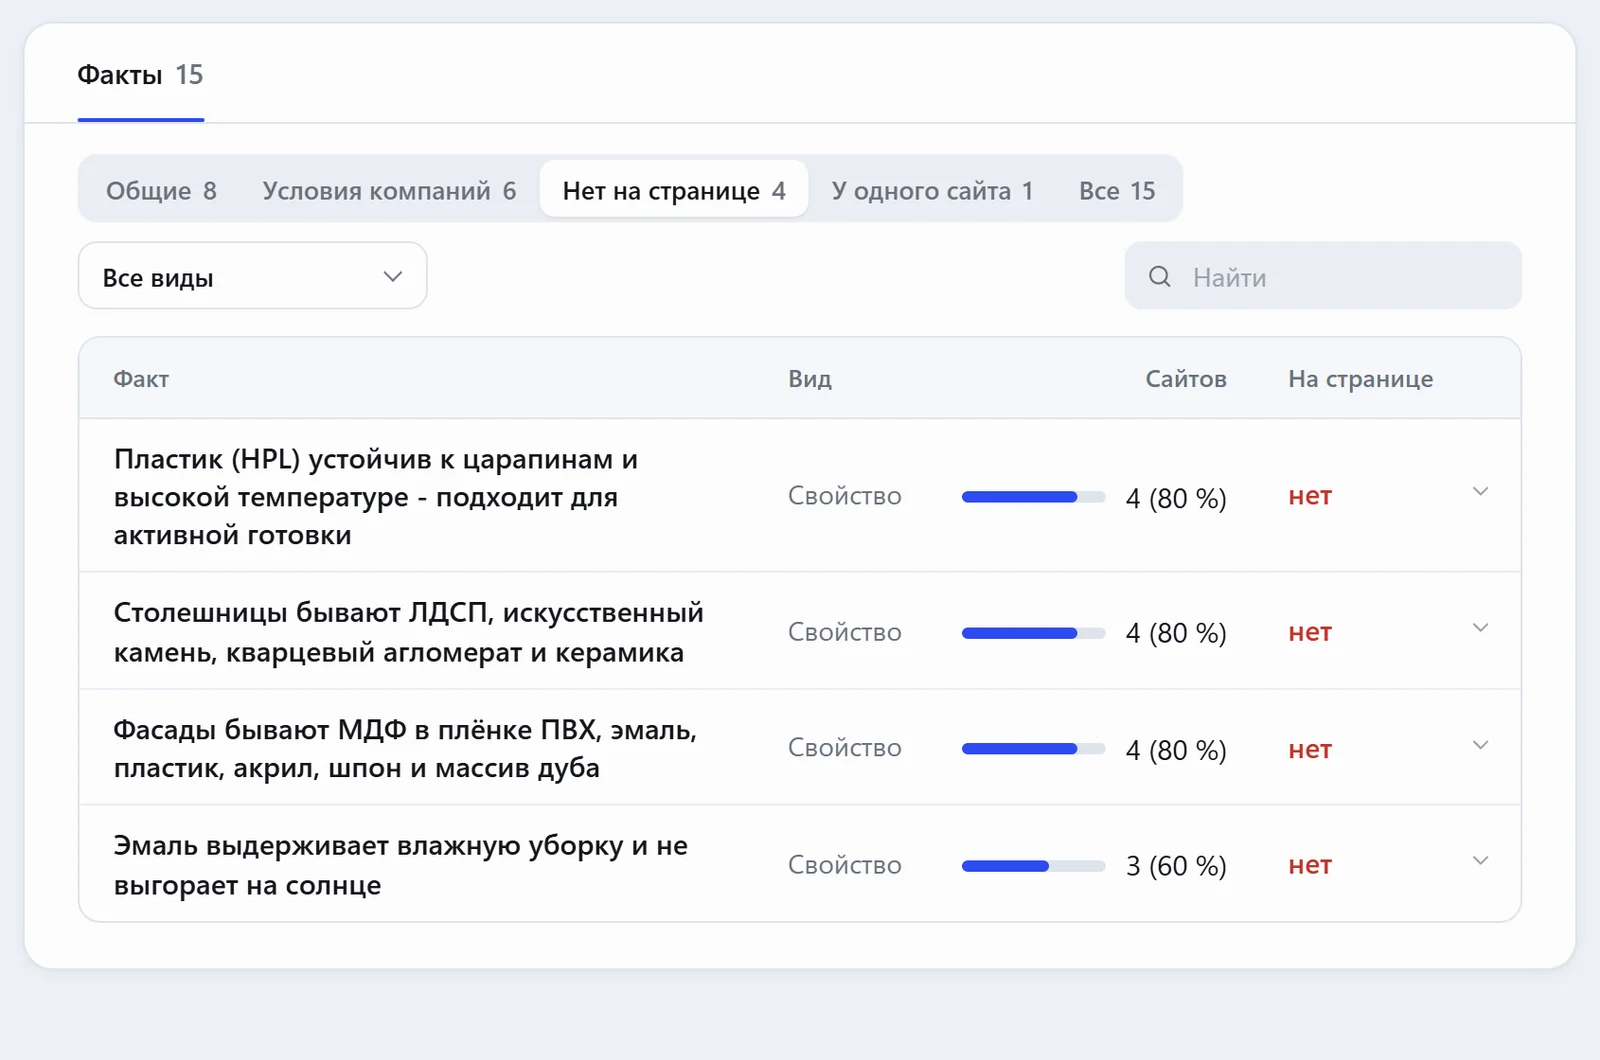
Утверждения, которые есть почти у всех конкурентов, а на вашей странице их нет, - что дописать первым.
- Сколько сайтов пишут
- Цитаты для проверки
- Excel и ТЗ
Преимущества
Почему удобно собирать факты в SERP-X
Тройками
Субъект, связь, объект и условие - факт виден целиком.
С цитатой
Каждый факт сверен с текстом сайта - не выдумка нейросети.
Общее и расхождения
Что пишут все, а где сайты спорят - проверить.
Чего нет у вас
Утверждения конкурентов, которых нет на вашей странице.
В ТЗ и доработку
Факты сами попадают в задание и в доработку.
Excel
Факты, сайты и цитаты.
Подробно
Семантические триплеты: что это и как писать текст фактами
Семантические триплеты - способ записать факт тремя элементами: субъект, предикат и объект. «Байкал - глубина - 1642 м», «Пётр I - основал - Санкт-Петербург». Из таких атомарных утверждений строятся графы знаний поисковых систем, а нейросети, разбирая текст, ищут в нём именно такие связи между сущностями.
Ниже - откуда взялась модель «субъект - предикат - объект», как её используют поиск и языковые модели, как переписать абзац в формат триплетов и чего от этого подхода ждать не стоит.
Субъект, предикат, объект: из чего состоит триплет
Субъект - сущность, о которой идёт речь: человек, компания, товар, место, понятие. Предикат - связь или свойство: «основал», «весит», «подходит для», «входит в». Объект - другая сущность или значение: число с единицей измерения, дата, название.
Главное правило семантических триплетов - один триплет описывает один факт. Предложение «Акриловая эмаль выдерживает влажную уборку и подходит для кухни» содержит два утверждения: «эмаль - выдерживает - влажную уборку» и «эмаль - подходит для - кухни». Чем проще связь, тем легче машине её извлечь и сопоставить с другими источниками.
У многих фактов есть условие: «при температуре до 40 °C», «для помещений с высокой проходимостью», «в Москве». Условие - часть факта: без него утверждение может стать неверным. В лингвистике похожий принцип известен давно: подлежащее, сказуемое и дополнение передают смысл предложения на самом простом уровне.
Примеры триплетов на обычных предложениях
- «Эльбрус - самая высокая вершина России, его высота 5642 м» → «Эльбрус - высота - 5642 м» и «Эльбрус - является - высшей точкой России».
- «Язык Python создал Гвидо ван Россум» → «Python - автор - Гвидо ван Россум».
- «Ламинат 33 класса выдерживает высокую нагрузку, поэтому его кладут в офисах» → «ламинат 33 класса - подходит для - офисов» с условием «высокая проходимость».
- «Рожковая кофемашина готовит эспрессо под давлением около 9 бар» → «рожковая кофемашина - готовит - эспрессо» и «эспрессо - готовится под давлением - около 9 бар».
В каждом случае субъект назван полностью, связь выражена глаголом или свойством, а значение конкретно. Такой формат легко сравнивать между источниками: сразу видно, кто указывает 9 бар, а кто 15, и чьё значение относится к другому показателю.
RDF, граф знаний и семантическая паутина
Формальный стандарт для триплетов - RDF (Resource Description Framework), модель описания данных консорциума W3C. В RDF субъект и предикат задаются идентификаторами (URI), а объект - другим ресурсом или простым значением. Набор триплетов образует граф: узлы - сущности, рёбра - связи между ними. Для выборки из таких баз есть язык SPARQL, а классы и свойства описывают онтологии.
На этой модели держится концепция семантической паутины (Semantic Web), которую предложил Тим Бернерс-Ли: данные в вебе должны быть понятны не только людям, но и машинам. В поиске идея воплотилась в графах знаний. Google запустил Knowledge Graph в 2012 году, у Яндекса есть своя база знаний, на которой строятся объектные ответы - карточки о людях, местах и организациях рядом с результатами поиска. Wikidata хранит утверждения в той же логике: элемент, свойство, значение и уточнения к нему.
Связанные термины, которые встречаются рядом с триплетами: сущность (entity), граф знаний (knowledge graph), онтология, семантическая сеть, извлечение отношений из текста на естественном языке.
Как поисковые системы и нейросети используют семантические триплеты
Поисковая система разбирает текст на сущности и связи, чтобы понять, о чём страница, и сопоставить её с графом знаний. Если текст называет те же сущности и связи, что и надёжные источники, его проще связать с темой. Если противоречит им без объяснения, доверия к нему меньше.
Большие языковые модели, на которых работают ответы Алисы, «Обзор от ИИ» Google и чат-боты, при подготовке ответа опираются на найденные страницы. Абзац, где каждое предложение - законченное утверждение с конкретным значением, легче понять и процитировать, чем текст из размытых формулировок. Поэтому семантические триплеты в тексте полезны и для обычной выдачи, и для нейросетевых ответов.
Отдельная задача - согласованность. Когда десятки источников приводят одно и то же значение, машине проще принять его как устойчивый факт. Когда значения расходятся, приходится выбирать источник, которому больше доверия, и страница с ошибкой проигрывает.
Как текст превращается в граф знаний
- Распознавание сущностей. Алгоритм находит в тексте названия людей, компаний, товаров, мест, даты и числа.
- Связывание с базой знаний. Каждую сущность нужно сопоставить с объектом: «Ягуар» - животное или марка автомобилей. Здесь помогают соседние слова и тема всей страницы.
- Извлечение связей. Из предложения выделяется предикат: «основал», «входит в», «стоит».
- Нормализация. Значения приводятся к единому формату: единицы измерения, даты, написание названий.
- Слияние. Новые триплеты сравниваются с уже известными: совпадения укрепляют факт, расхождения требуют более надёжного источника.
На каждом шаге возможна ошибка, и чем запутаннее текст, тем таких ошибок больше. Ясные формулировки помогают не только читателю, но и машине.
Как найти сущности и связи в абзаце
- Выписать сущности: о чём или о ком каждое предложение.
- Для каждой сущности найти связи: что она делает, из чего состоит, для чего подходит, какой у неё вес или цена.
- Заменить местоимения и абстрактные слова названиями: «ламинат 33 класса», а не «он» или «наш продукт».
- Добавить конкретные значения: числа с единицами, даты, сроки, условия.
- Разбить длинные предложения так, чтобы в каждом осталось одно-два утверждения.
- Определение поставить в первый абзац: «X - это Y, который Z».
Пример. Было: «Этот великий город на Неве, основанный первым российским императором, по праву считается культурной столицей». Стало: «Санкт-Петербург стоит на Неве. Город основал Пётр I в 1703 году. Санкт-Петербург называют культурной столицей России». Из первого варианта машине нужно восстановить три связи, из второго они читаются напрямую. Текст при этом не обязан звучать сухо: простой порядок слов и точные названия - не то же самое, что телеграфный стиль.
Как понять, хватает ли триплетов на странице
Норм нет: число фактов зависит от темы и объёма страницы. Ориентир - конкуренты из ТОП-10. Если почти все называют одни и те же свойства, сроки или условия, а у вас их нет, страница выглядит неполной. Если конкуренты расходятся в значениях, стоит найти первоисточник и объяснить разницу в тексте. Сравнивать удобнее не ключевые слова, а утверждения: названы ли главные свойства товара или услуги, есть ли сроки, условия и ограничения.
Начинать лучше со страниц, которые уже близко к ТОП-10, с коммерческих страниц, где важны условия - цены, сроки, гарантии, - и со статей, которые отвечают на вопрос определением. Создание текста с нуля по фактам конкурентов тоже даёт результат: копирайтер получает не набор ключевых слов, а список утверждений, которые нужно раскрыть.
Как убедиться, что машина поняла абзац
Простой способ - попросить языковую модель выписать из абзаца все утверждения в виде «субъект - предикат - объект» и сравнить их с тем, что вы хотели сказать. Если модель потеряла условие, перепутала сущности или не нашла главного факта, читатель, скорее всего, тоже споткнётся в этом месте.
Второй способ - сравнить свою страницу с конкурентами из ТОП-10: какие утверждения есть у большинства из них и отсутствуют у вас. Эту задачу и решает инструмент SERP-X, о котором ниже.
Частые ошибки в текстах с триплетами
- Потерянное условие: «служит до 50 лет при правильном монтаже» превращается в «служит 50 лет».
- Местоимения через абзац: «он», «этот материал», «наше решение» вместо названия.
- Разные имена одной сущности без связи между ними: ламинат, покрытие, напольный материал в соседних предложениях.
- Числа без единиц: «держит до 300» - килограммов, градусов или циклов.
- Противоречия внутри страницы: в одном разделе гарантия 3 года, в другом - 5 лет.
Чего семантические триплеты не гарантируют
- Сами по себе не поднимают страницу: спрос, структура, ссылки, поведение пользователей и техническое состояние никуда не деваются.
- Не заменяют пользу: набор сухих утверждений без объяснений читать тяжело.
- Не работают с выдуманными данными: ложный факт, повторённый уверенно, вредит доверию к ресурсу.
- Не равны микроразметке: schema.org описывает данные в коде, а триплеты в тексте - то, что видит читатель. Полезно и то, и другое.
- Не всегда извлекаются точно: нейросеть может ошибиться в связи, поэтому факт важно сверять с цитатой из источника.
Как SERP-X собирает семантические триплеты
Впишите запрос и регион; по желанию - адреса своих конкурентов и свою страницу. Нейросеть HydraAI вынимает из каждой страницы лидеров выдачи утверждения в виде «субъект → связь → объект» с условием и дословной цитатой, а SERP-X склеивает одинаковые по смыслу. Каждый факт сверен с текстом источника, поэтому выдумка нейросети в результат не попадает.
В итоге видно, какие факты повторяются у многих конкурентов, где значения расходятся, какие условия относятся к конкретным компаниям и чего нет на вашей странице. Для первого абзаца предлагается готовое определение. В таблице у каждого факта - вид (определение, свойство, применение), число конкурентов, у которых он есть, и цитаты. Отборы - повторяющиеся факты, условия компаний, расхождения и то, чего нет на странице; таблица выгружается в Excel. Факты сами попадают в ТЗ на новую страницу и в доработку в «Релевантности», а написанный текст можно принять по ТЗ с этими фактами.
Вопросы
Частые вопросы
Что такое триплет?
Факт в виде «субъект → связь → объект»: «эмаль → выдерживает → влажную уборку». Так факты удобно сравнивать между сайтами.
Зачем факты в тексте?
Поисковики и нейросети ищут в тексте ответы-факты. Если их пишет весь топ, а у вас их нет, страница выглядит неполной.
Что такое «условия компаний»?
Цены, сроки, гарантии конкретных компаний - их в своём тексте пишут только своими данными.
Сколько стоит?
Копейки за запрос - факты вынимает и склеивает нейросеть HydraAI.
Чем триплет отличается от микроразметки?
Микроразметка описывает данные в коде страницы для поисковых систем, триплет - утверждение в самом тексте, которое видит читатель. На хорошей странице есть и то, и другое, и они не противоречат друг другу.
Что такое RDF?
Resource Description Framework - стандарт W3C для описания данных тройками «субъект - предикат - объект». На этой модели построены графы знаний и идея семантической паутины.
Работают ли семантические триплеты в Яндексе?
Яндекс, как и Google, ведёт базу знаний об объектах и разбирает тексты на сущности и связи. Чёткие утверждения помогают ему понять страницу, но результат в выдаче по-прежнему зависит от многих факторов.
Что делать, если факты конкурентов противоречат друг другу?
Найти первоисточник: стандарт, инструкцию производителя, официальные данные. В тексте привести верное значение, а если расхождение частое - объяснить, откуда оно берётся.
Ещё в разделе «Проверка страницы»
Триплеты - в программе SERP-X
Все инструменты в одной программе для Windows. Начать можно бесплатно.