Сбор семантического ядра по конкурентам
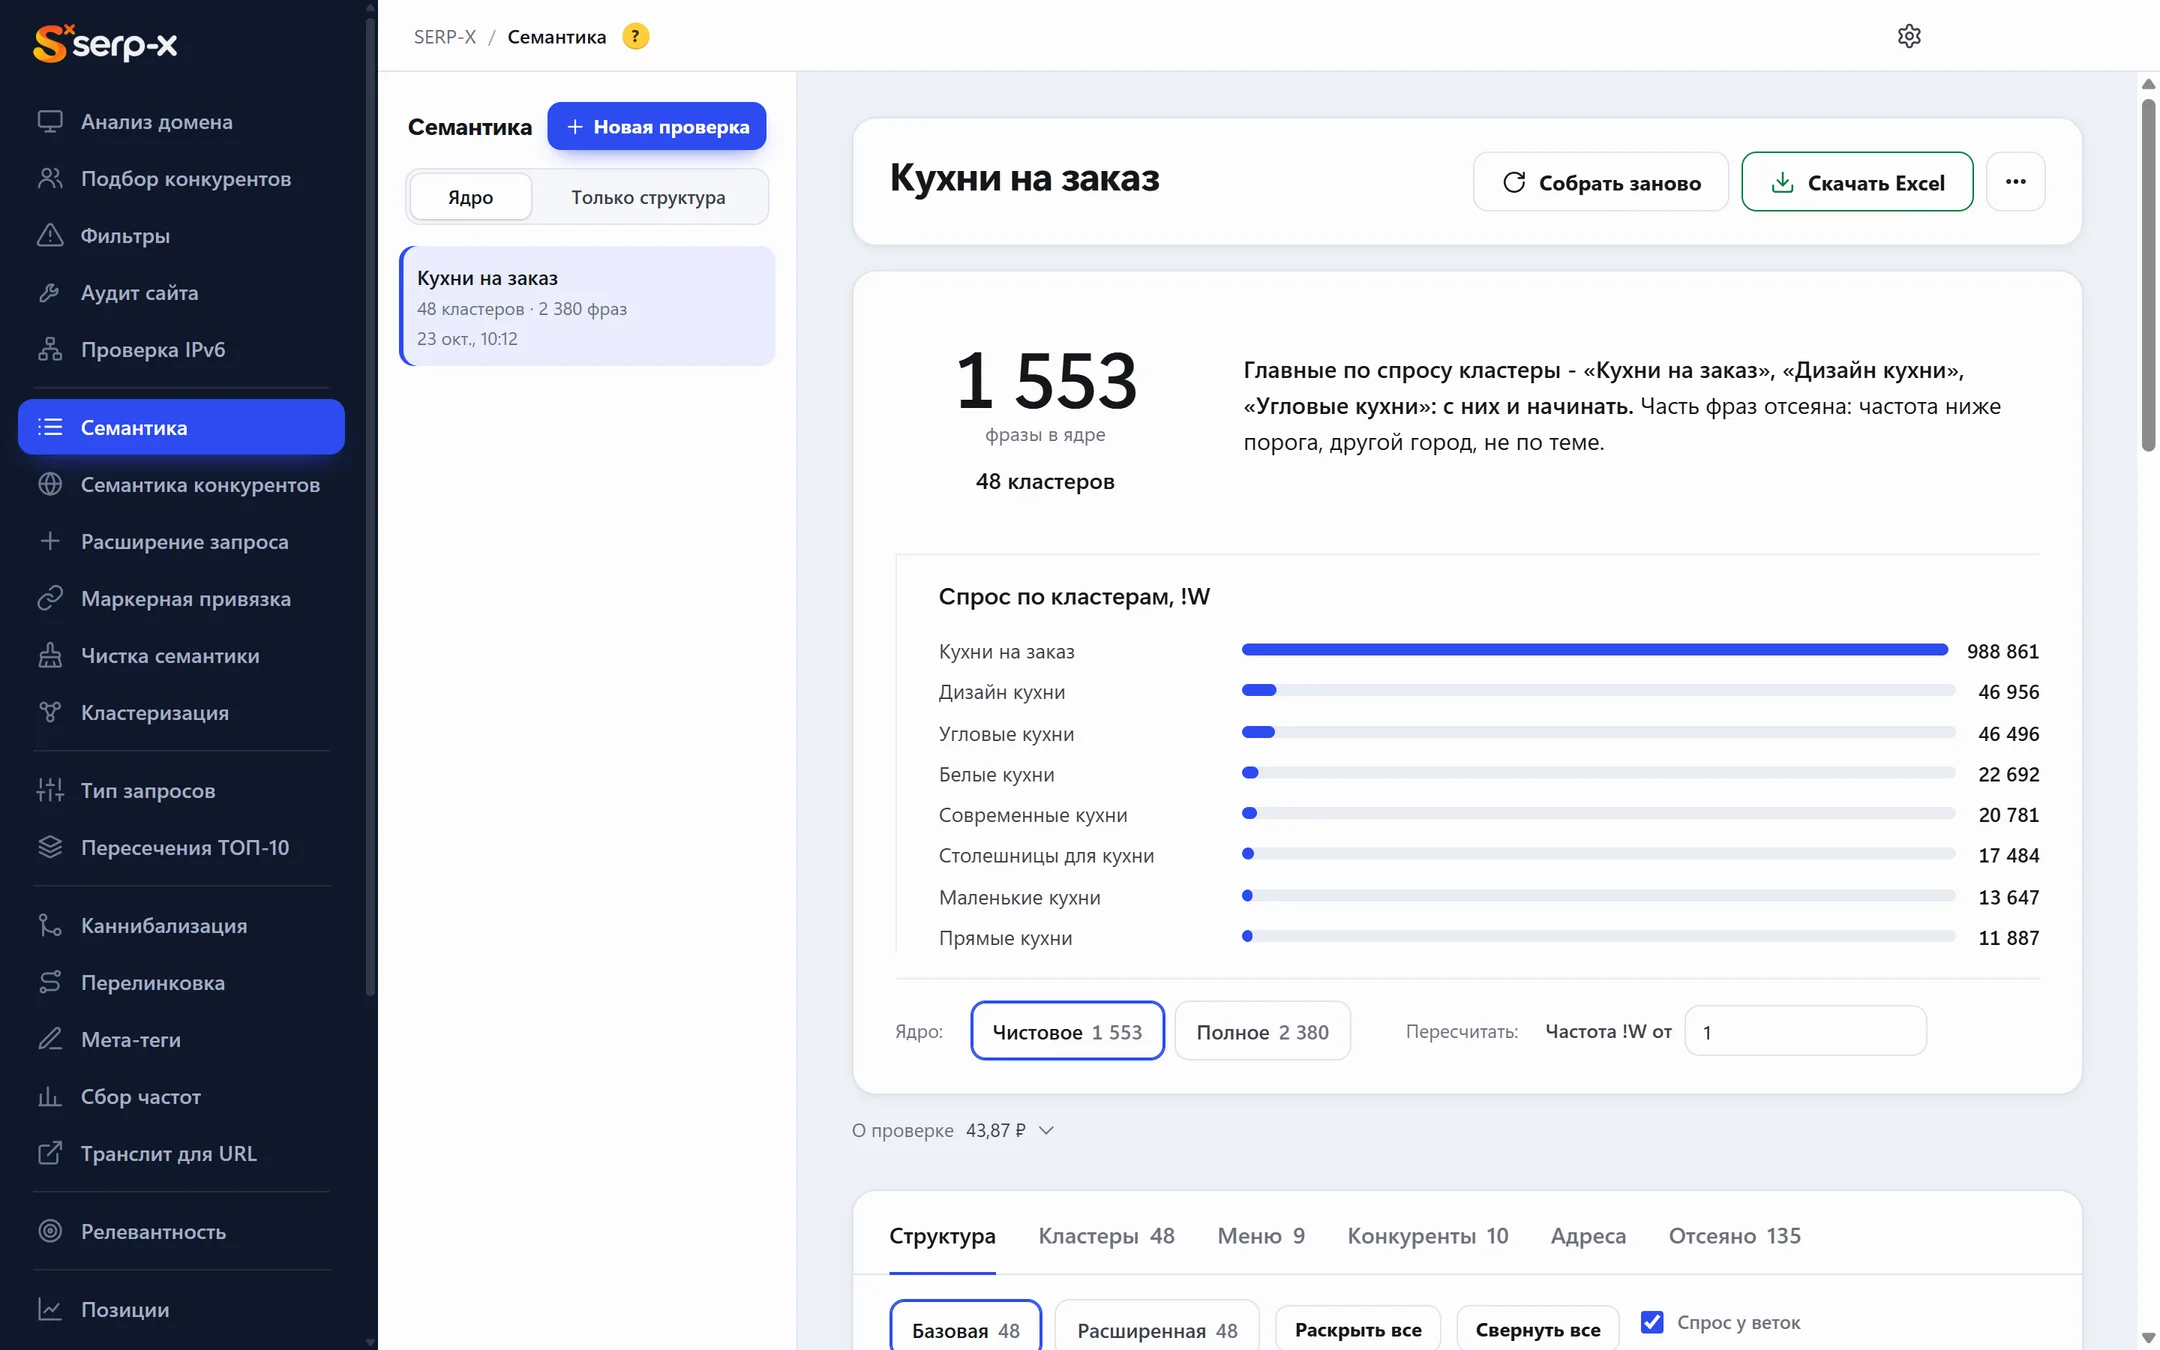
Сбор семантического ядра одной кнопкой: на входе - ниша, на выходе - структура сайта, страницы с ключевыми фразами и частотами, коммерция каждого запроса и мета-теги. Без ручной разметки.
- Ядро по конкурентам
- Структура и меню
- Excel и XMind
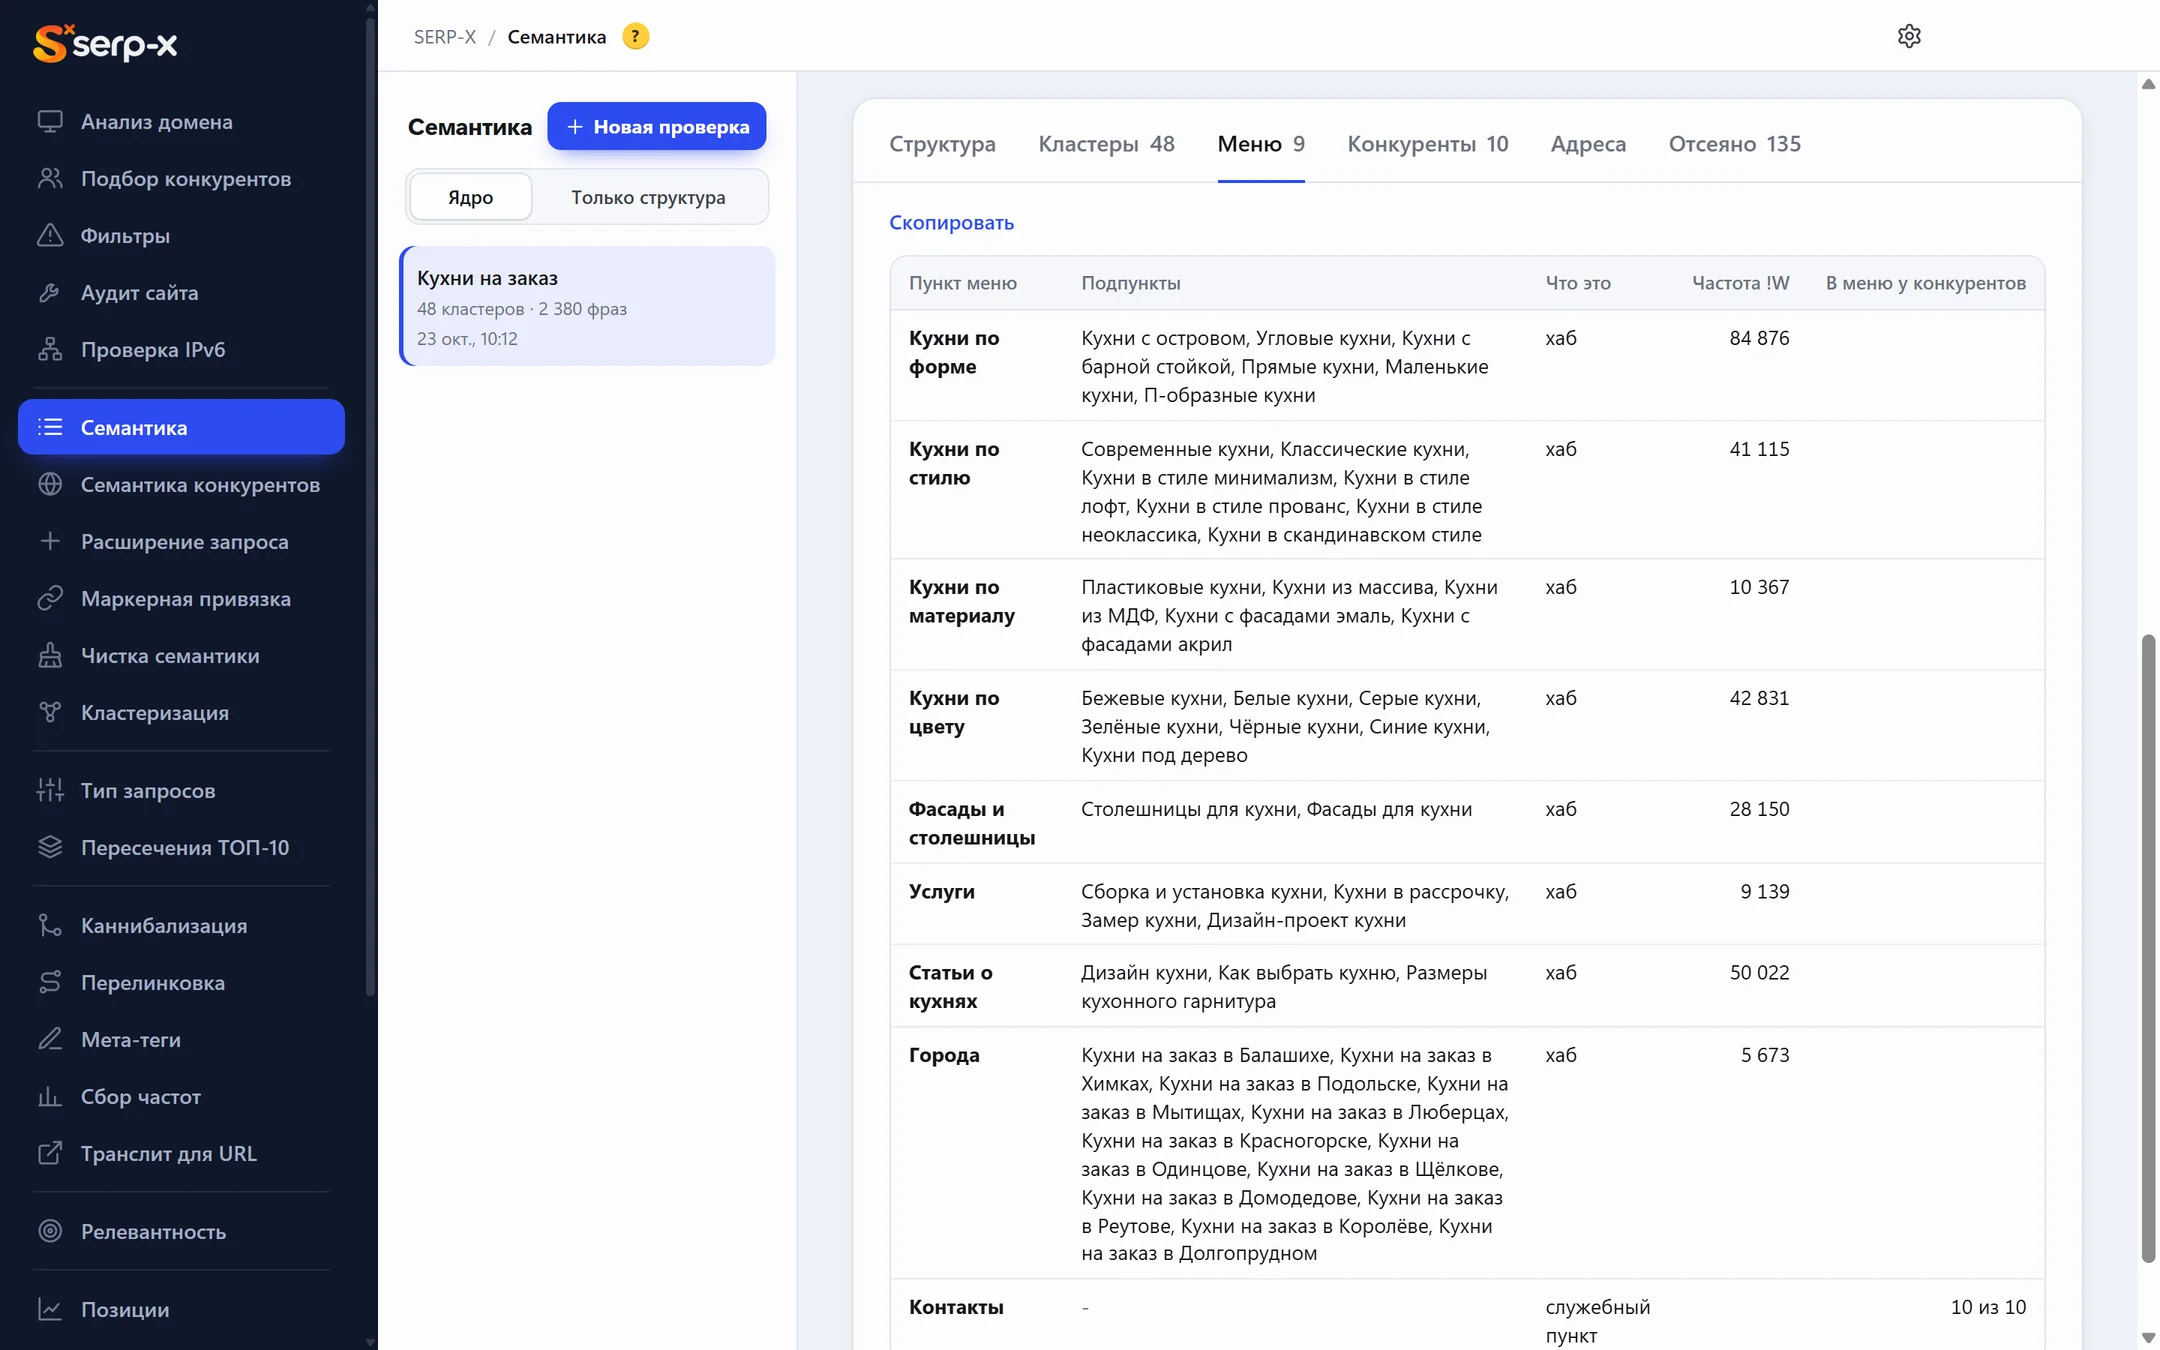
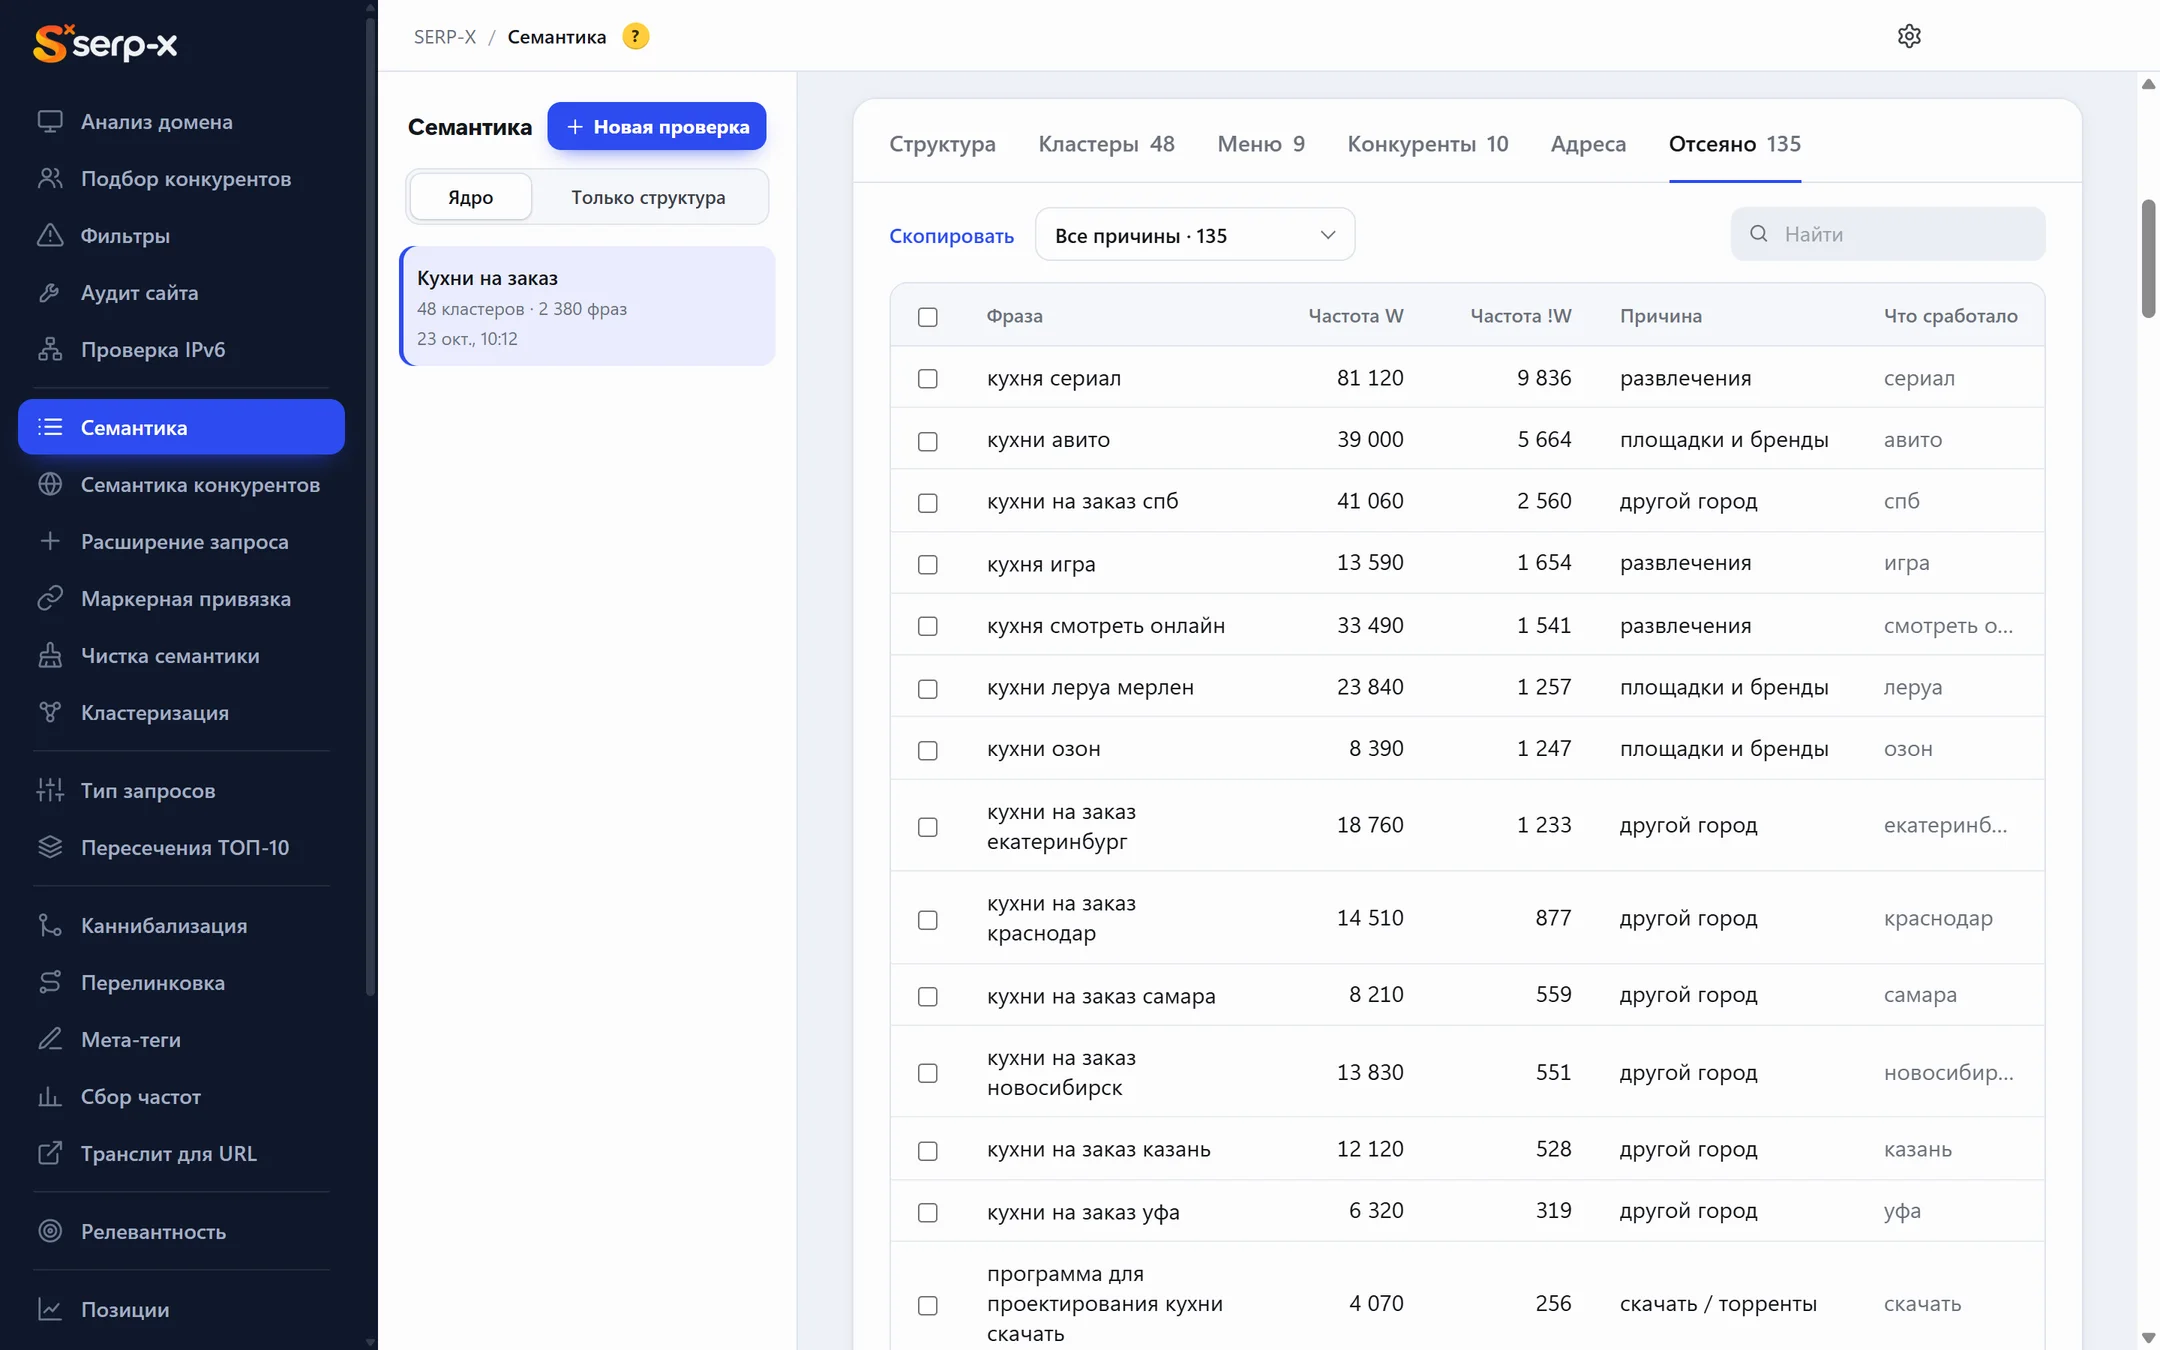
Как работает
Как собирается ядро
Конкуренты из выдачи
ТОП-10 по запросам ниши: остаются сайты такого же бизнеса, без площадок, агрегаторов и статей.
Разделы конкурентов
Навигация и страницы сайтов превращаются в поисковые запросы, повторы склеиваются.
Структура первой
Сначала каркас: главная, разделы и страницы по разделам конкурентов - так, как его строит опытный специалист.
Фразы с частотами
База фраз по каждой странице: W, «W» и «!W», без обрывков, чужих городов и брендов.
Выдача по фразам
Коммерциализация и геозависимость каждого запроса - по живому ТОП-10 Яндекса.
Страницы и мета-теги
Каждая фраза - на свою страницу, ненужное сайту - в «Отсеяно» с причиной; у страниц - H1, Title и Description.
Что получите
Семантическое ядро, которое можно отдать заказчику
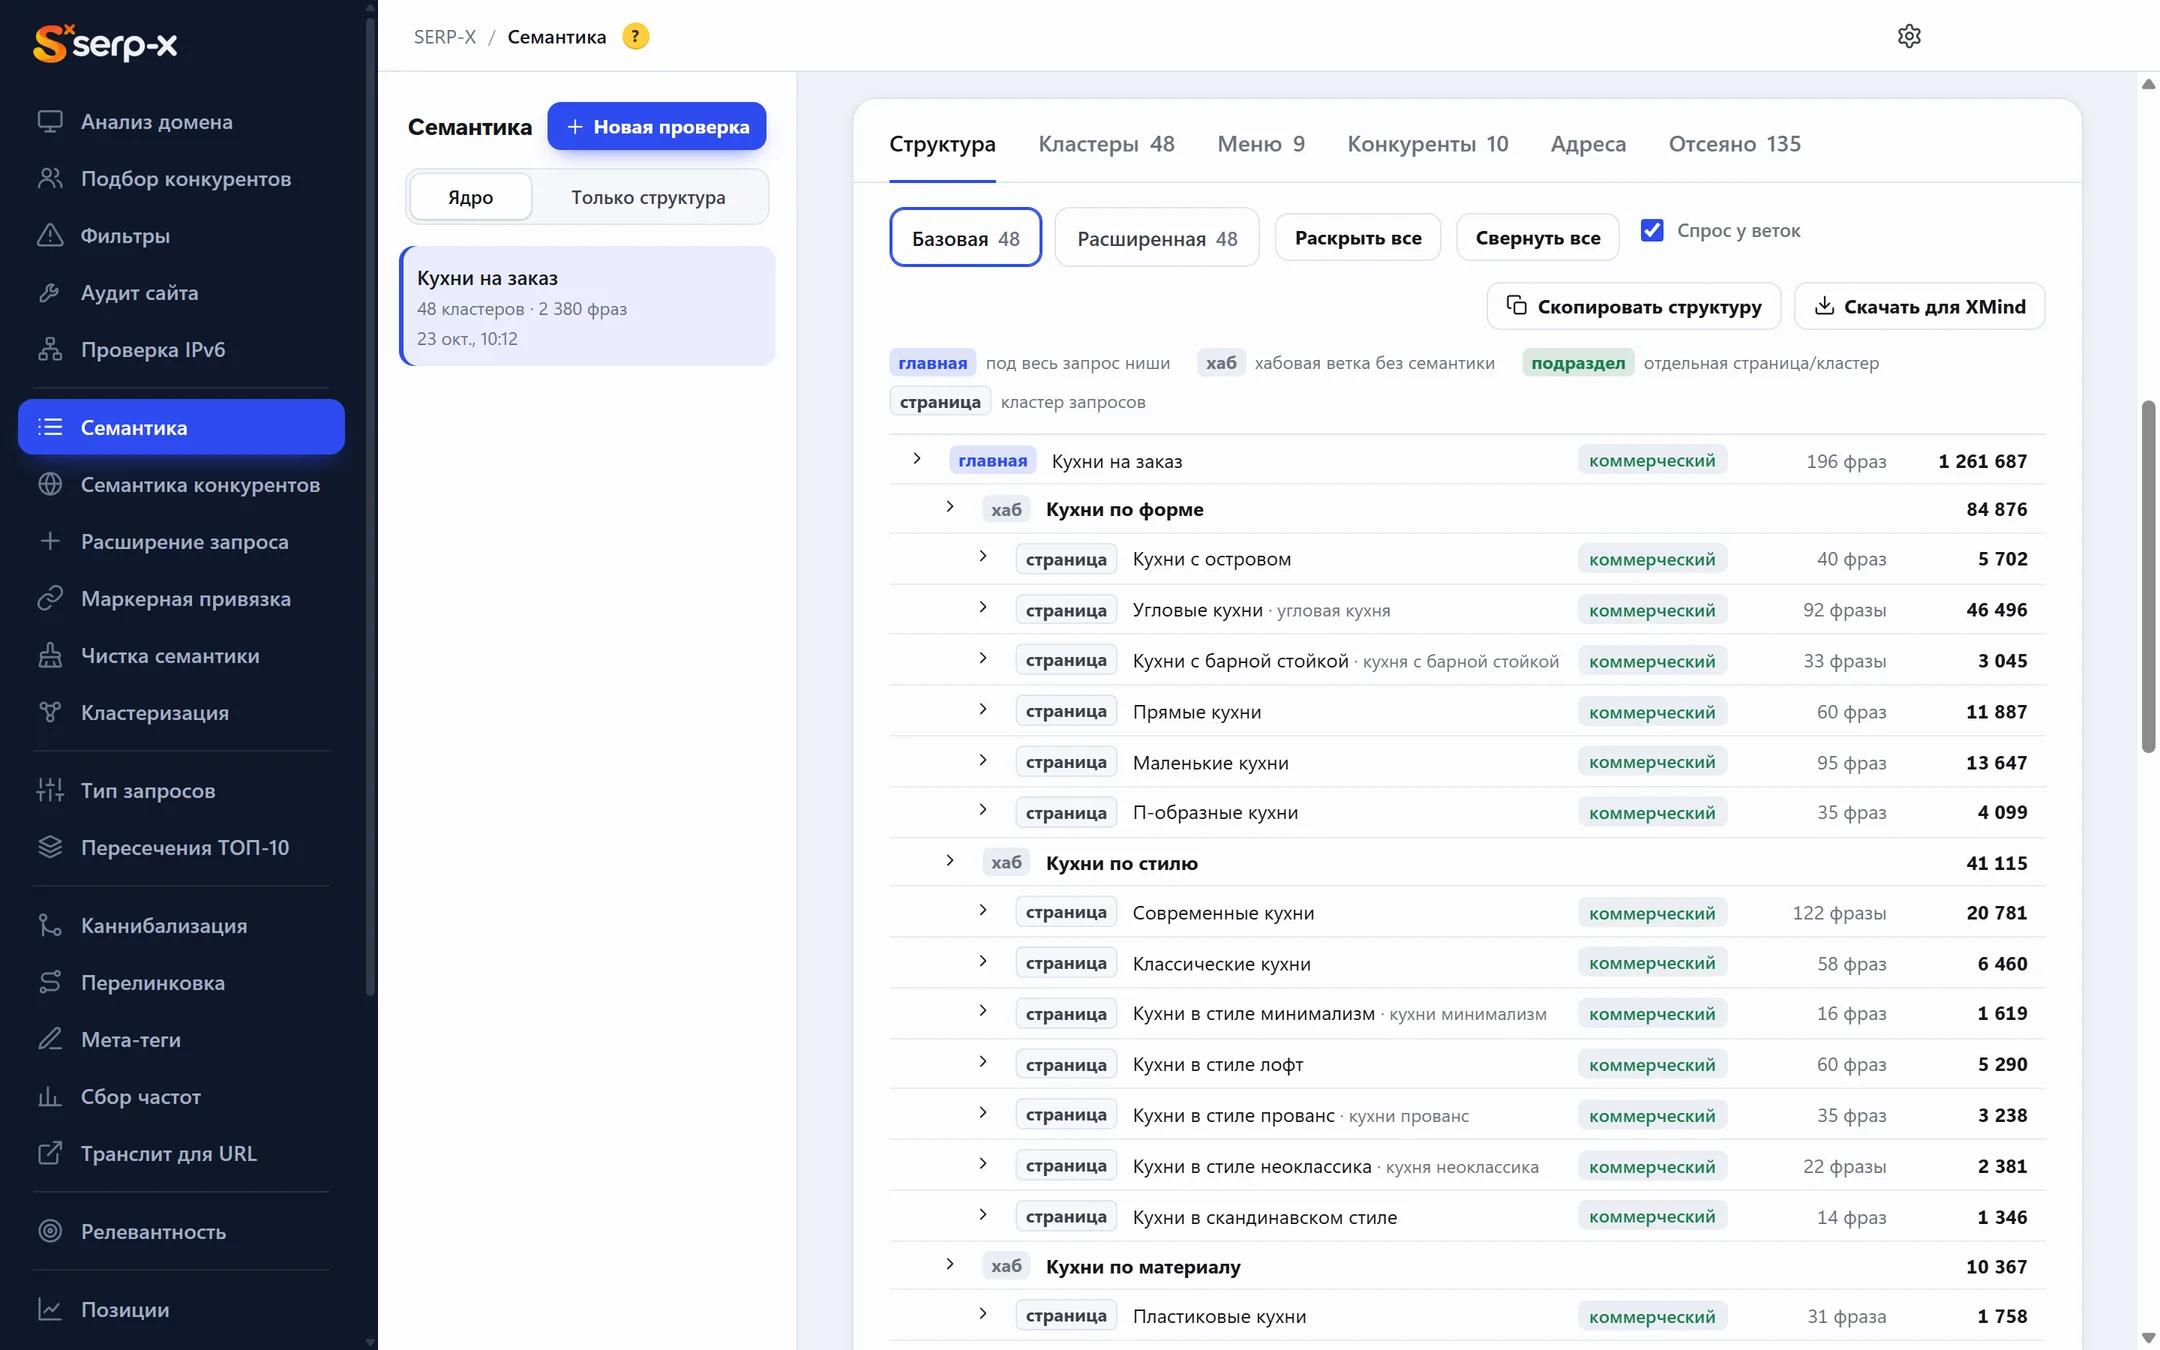
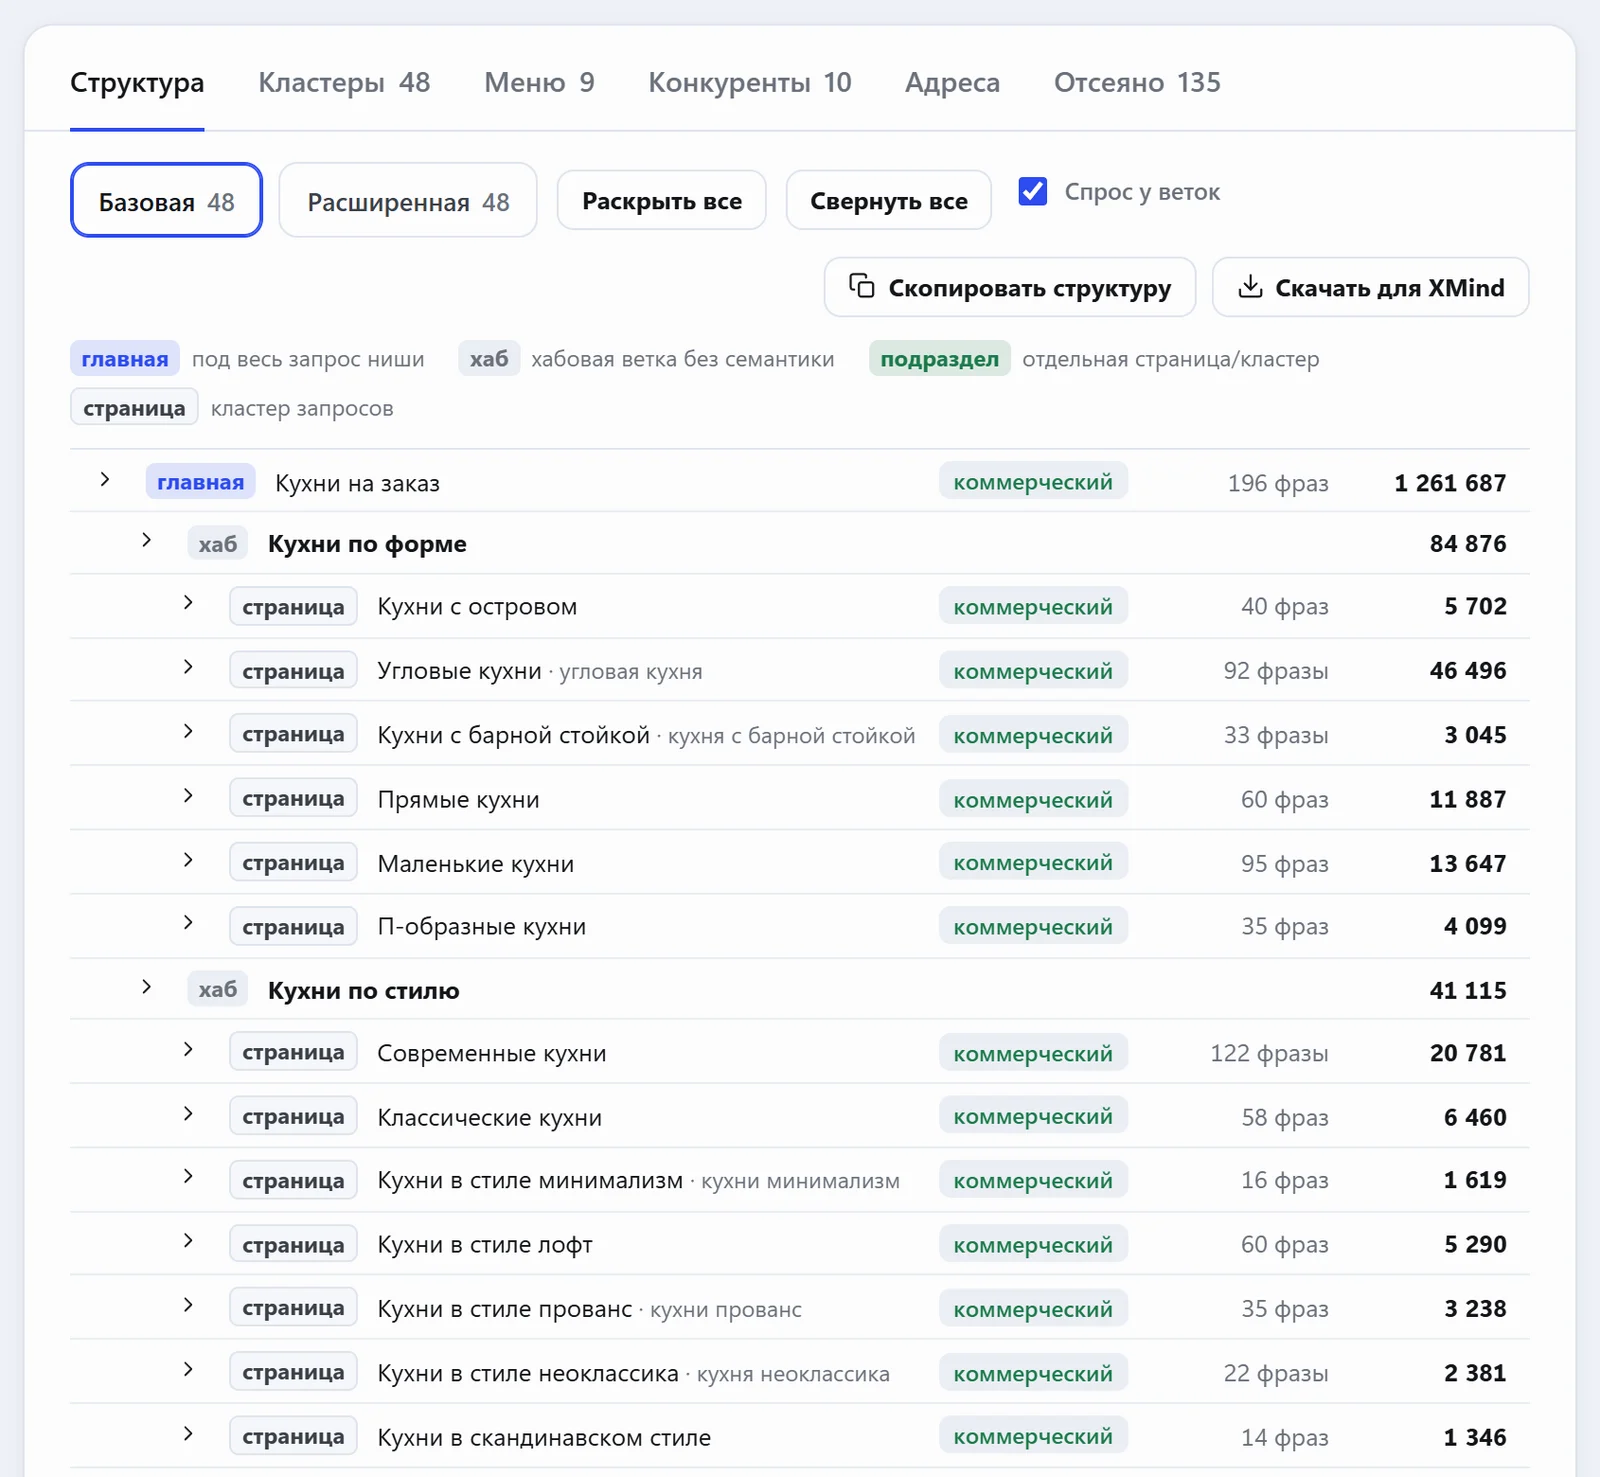
Структура сайта
Главная, разделы меню и страницы - деревом, со спросом каждой ветки. Базовая структура - то, что есть у большинства конкурентов, расширенная - со всеми нишевыми разделами.
- Хабы и страницы с частотой !W
- Другие названия страницы - рядом
- Копируется списком и выгружается в XMind
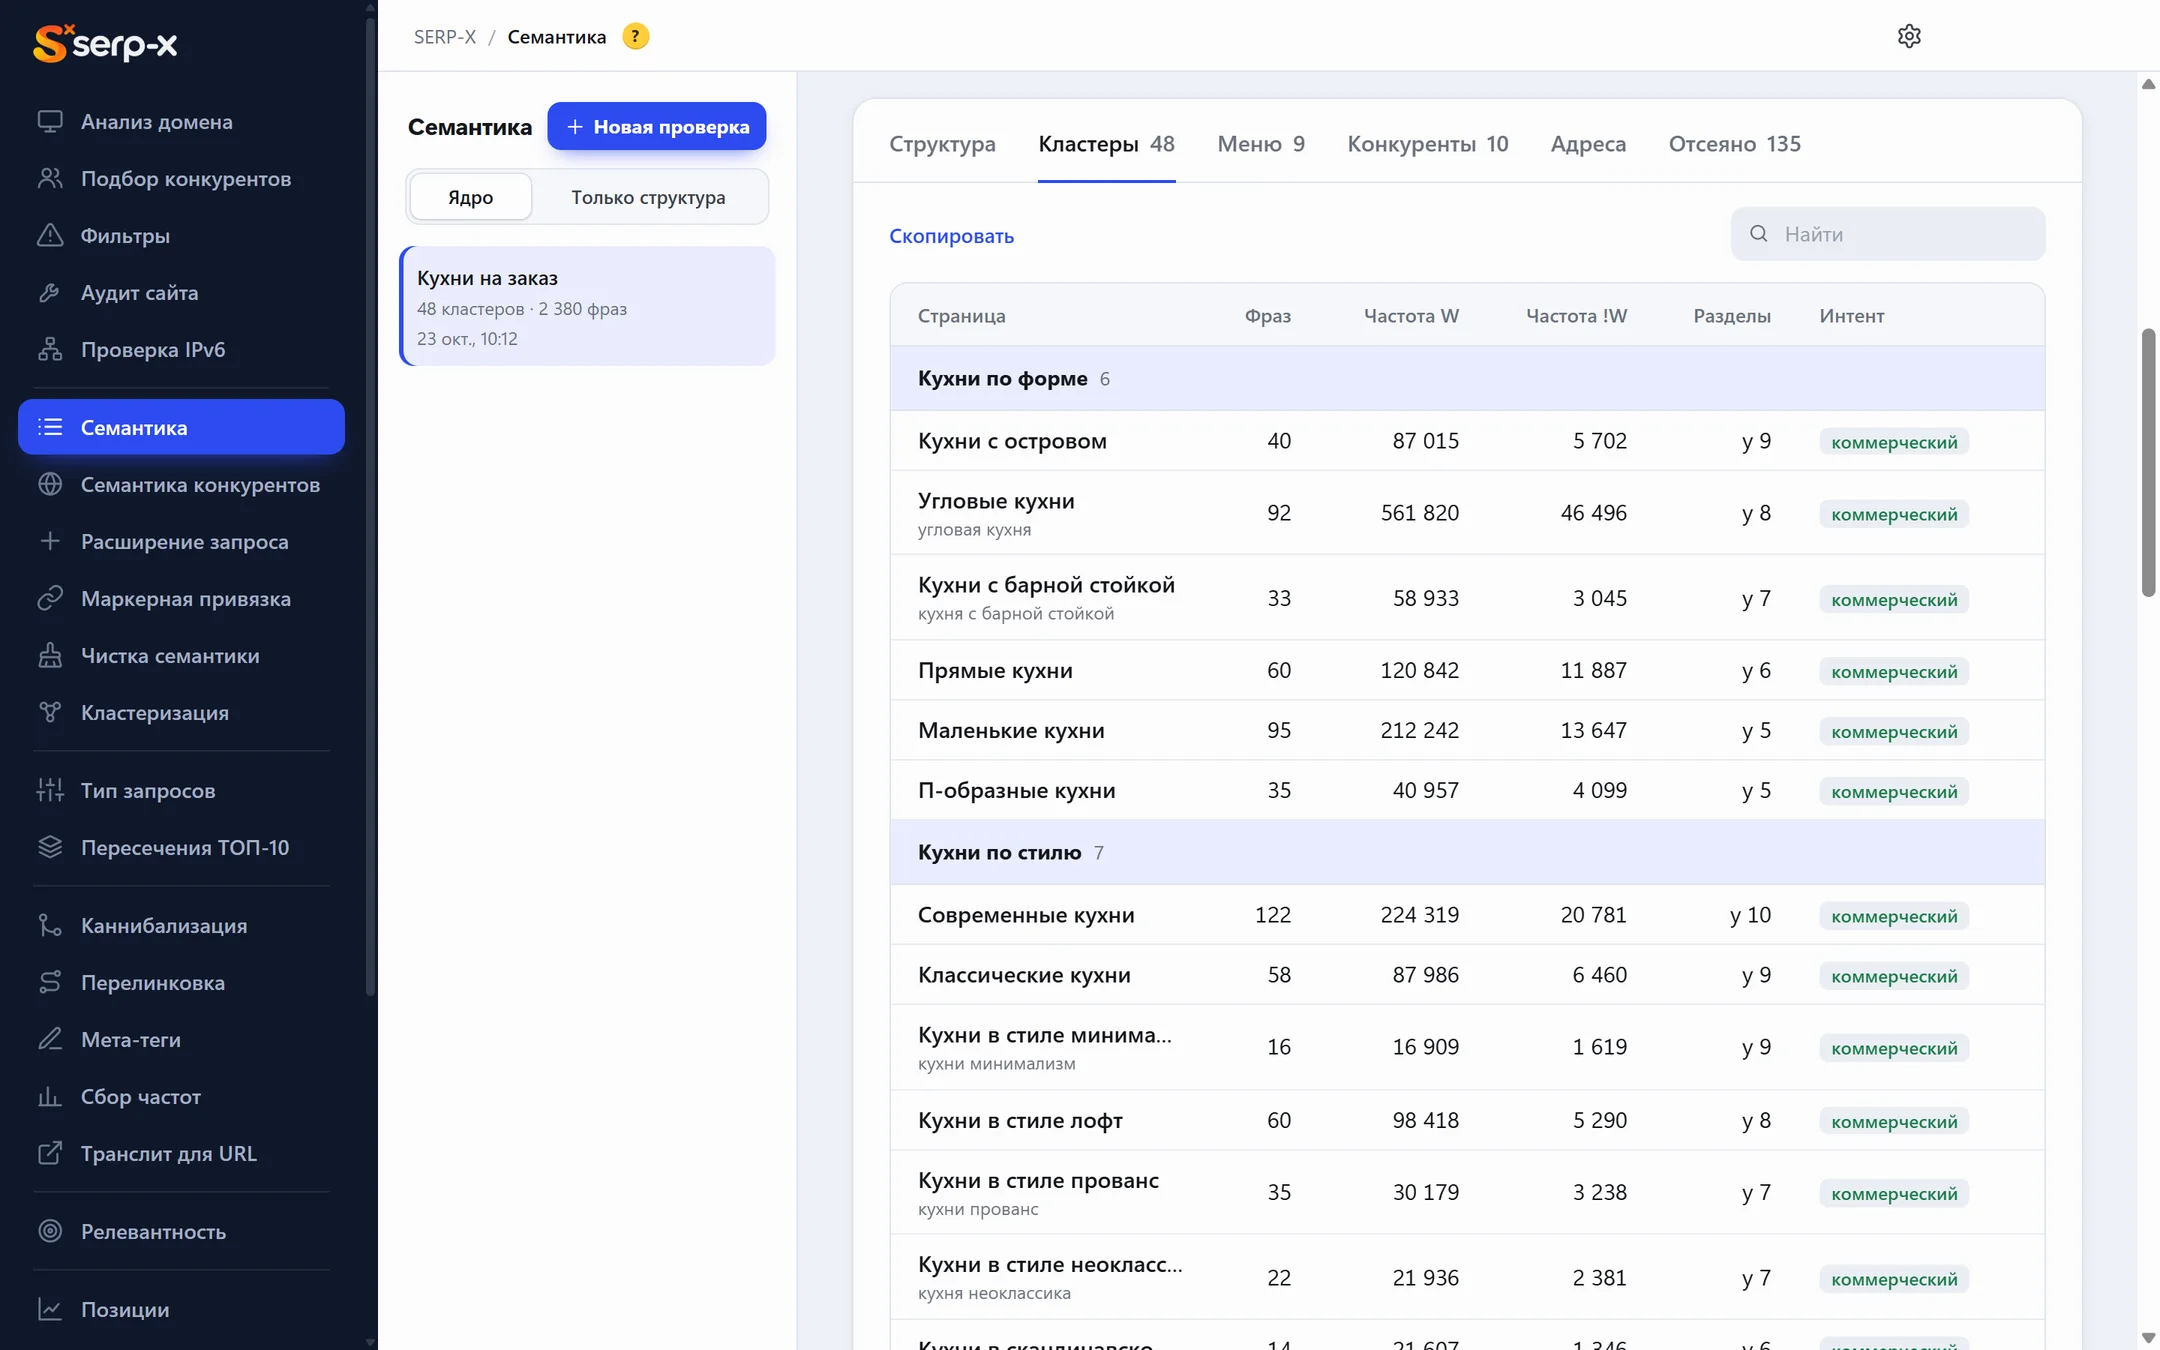
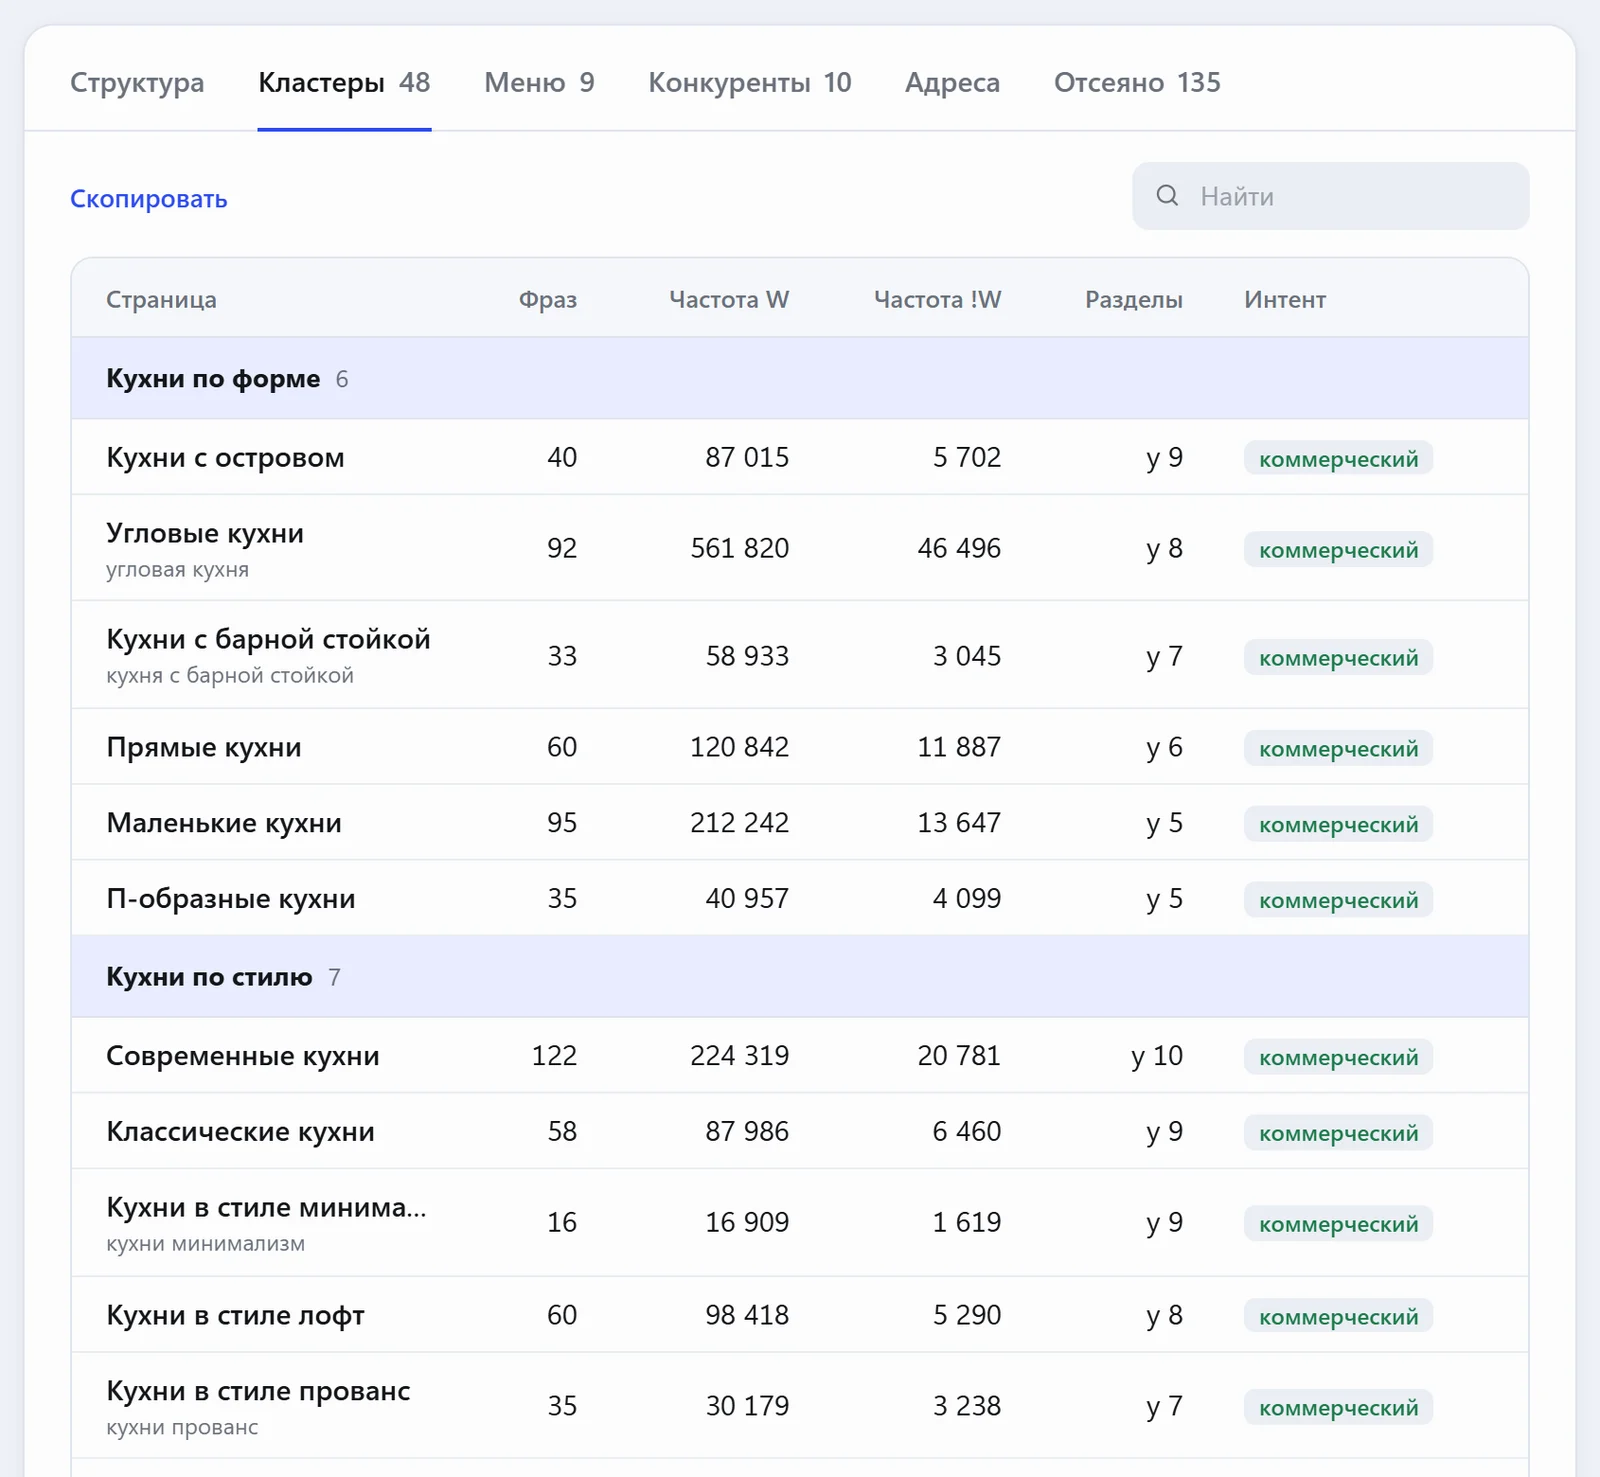
Кластеры с частотами
Каждая страница - со своими фразами, частотами W и !W, у скольких конкурентов есть такой раздел и интент страницы.
- Страницы - по разделам структуры
- Сколько конкурентов держат раздел
- Коммерческий или информационный
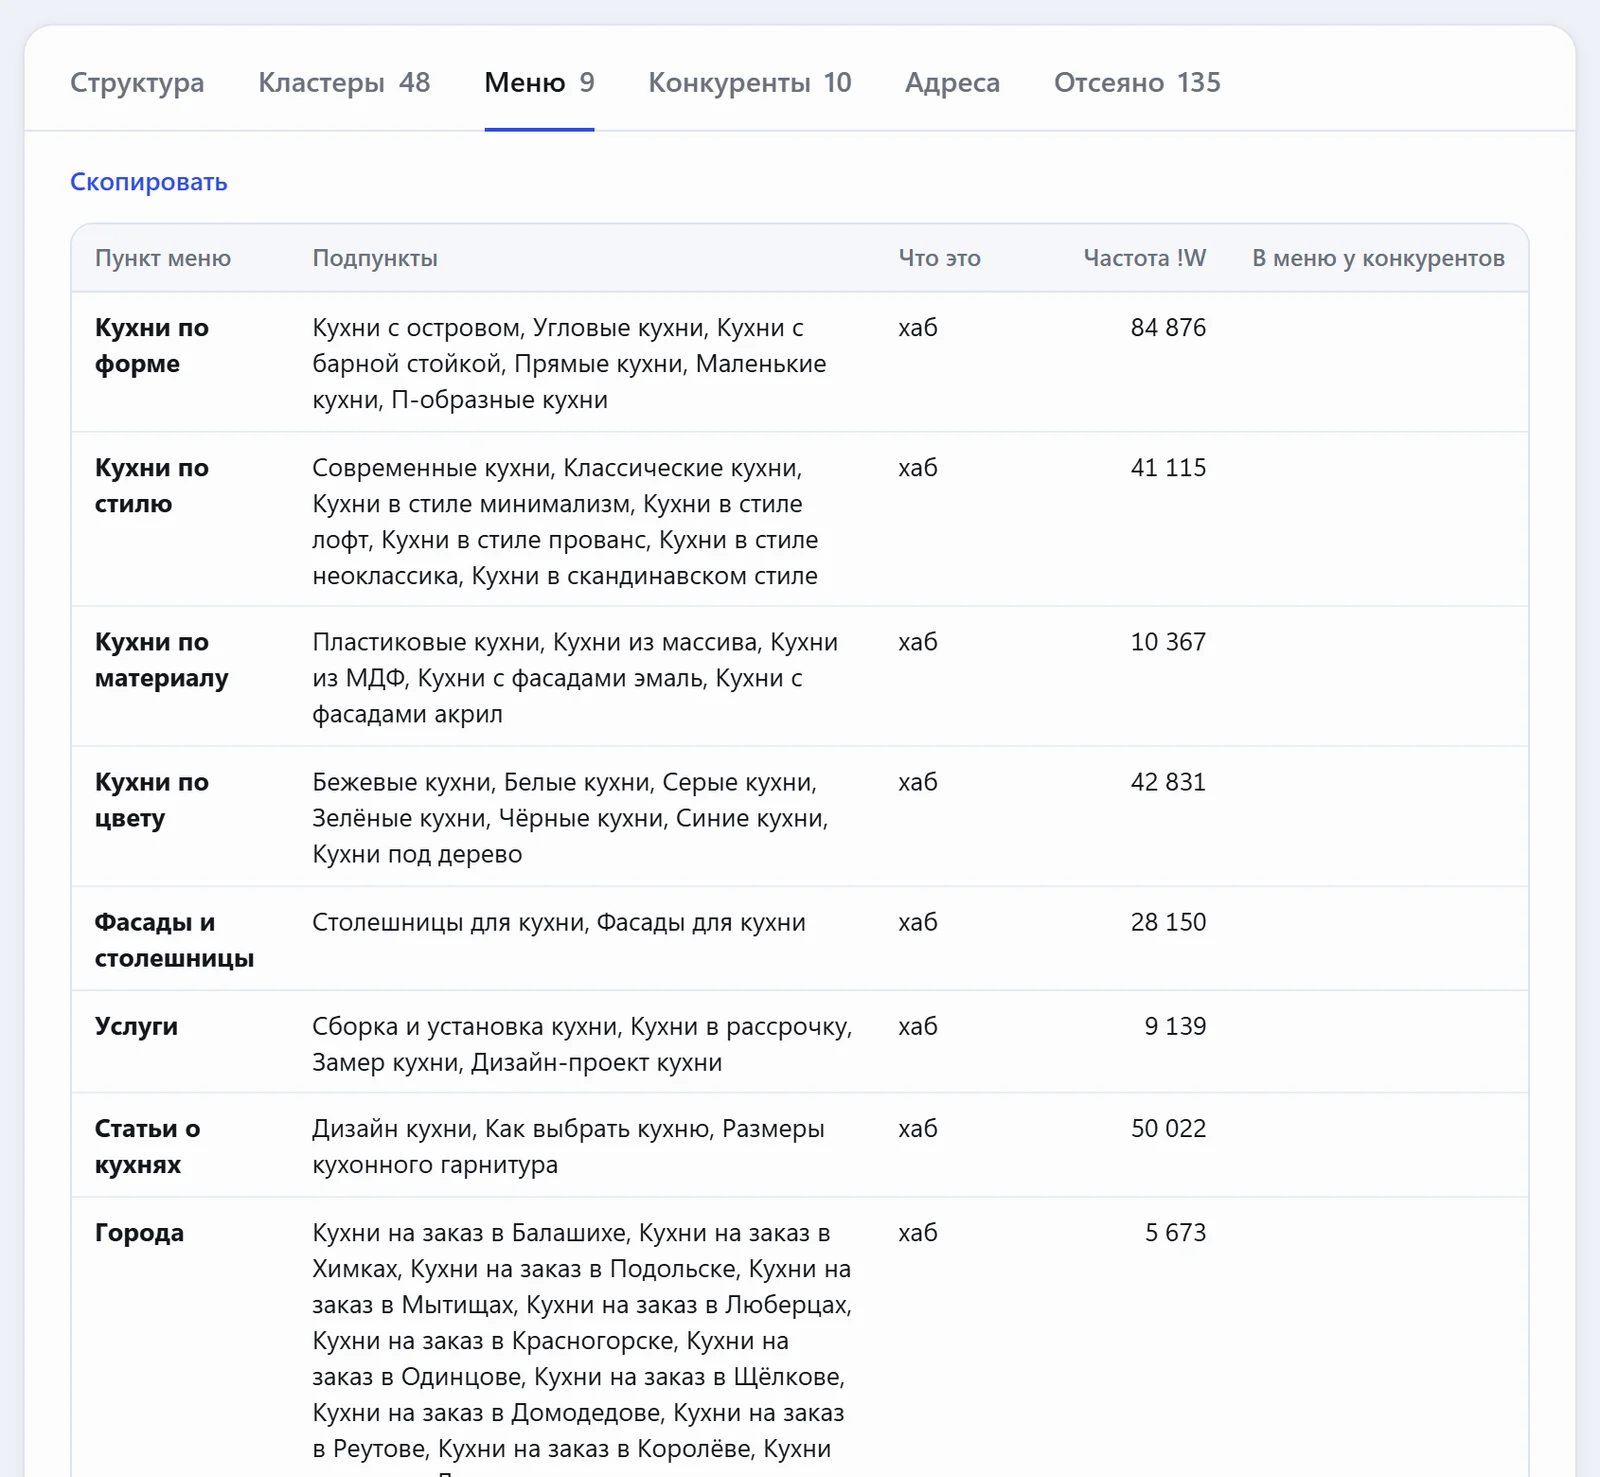
Меню сайта
Пункты и подпункты навигации - как у сайтов той же тематики, со спросом каждого пункта; служебные - если они есть у большинства.
- Разделы и их страницы
- Спрос каждого пункта
- Служебные пункты - у скольких конкурентов
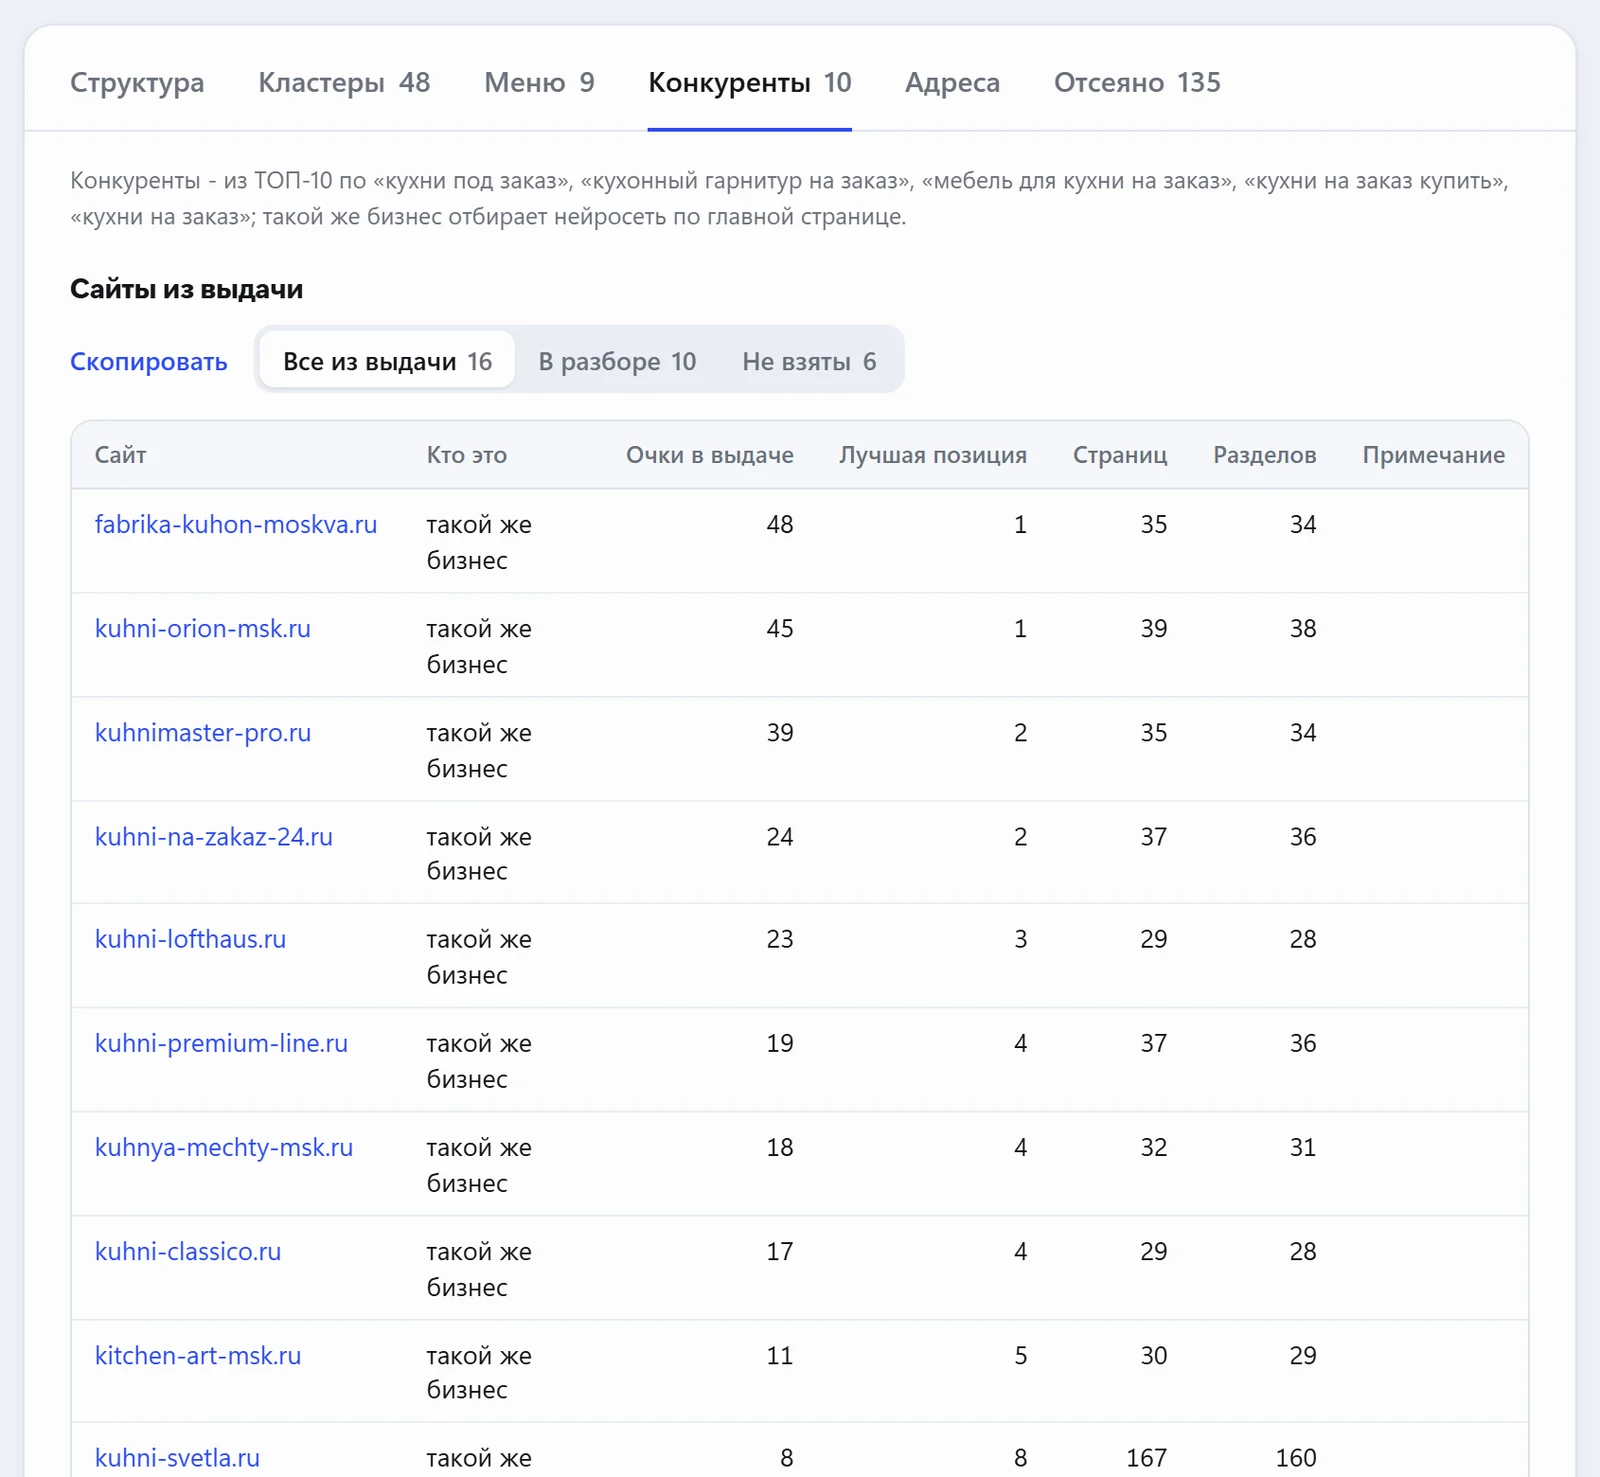
Конкуренты из выдачи
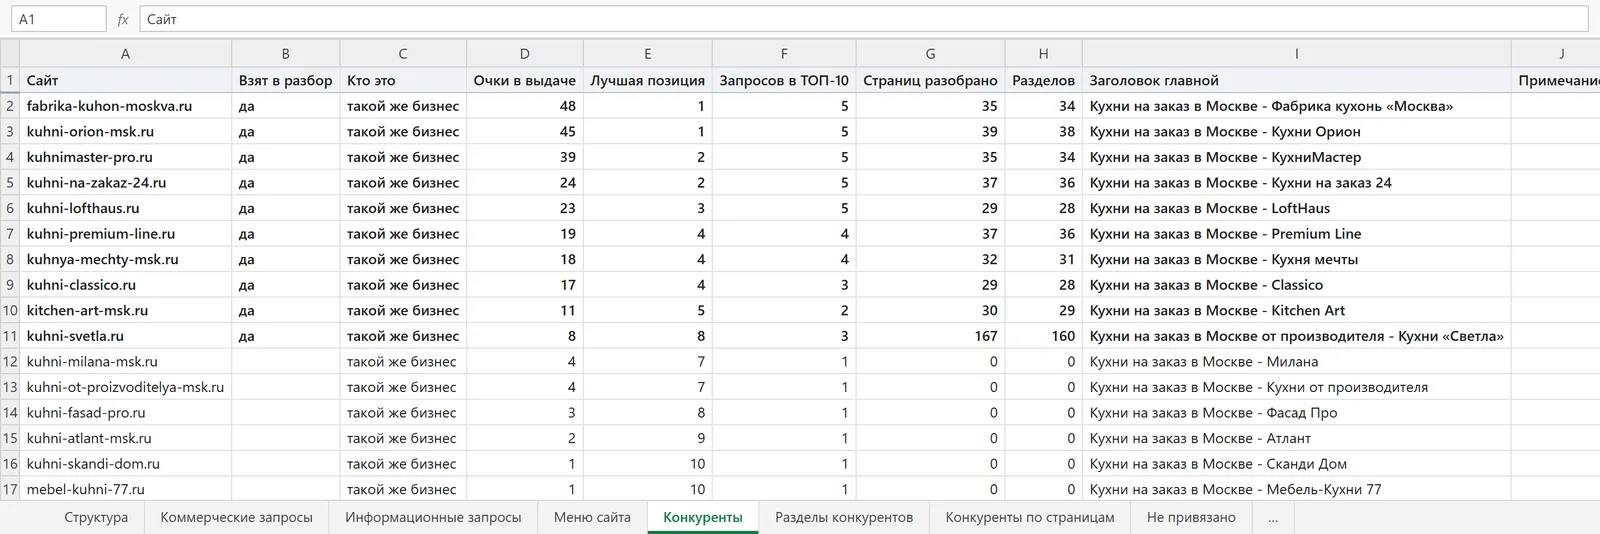
Сайты из ТОП-10 по запросам ниши: такой же бизнес, агрегатор или статья - видно по главной странице; в разбор идут только прямые конкуренты.
- Очки в выдаче и лучшая позиция
- Сколько страниц и разделов разобрано
- Агрегаторы и статьи - отдельно
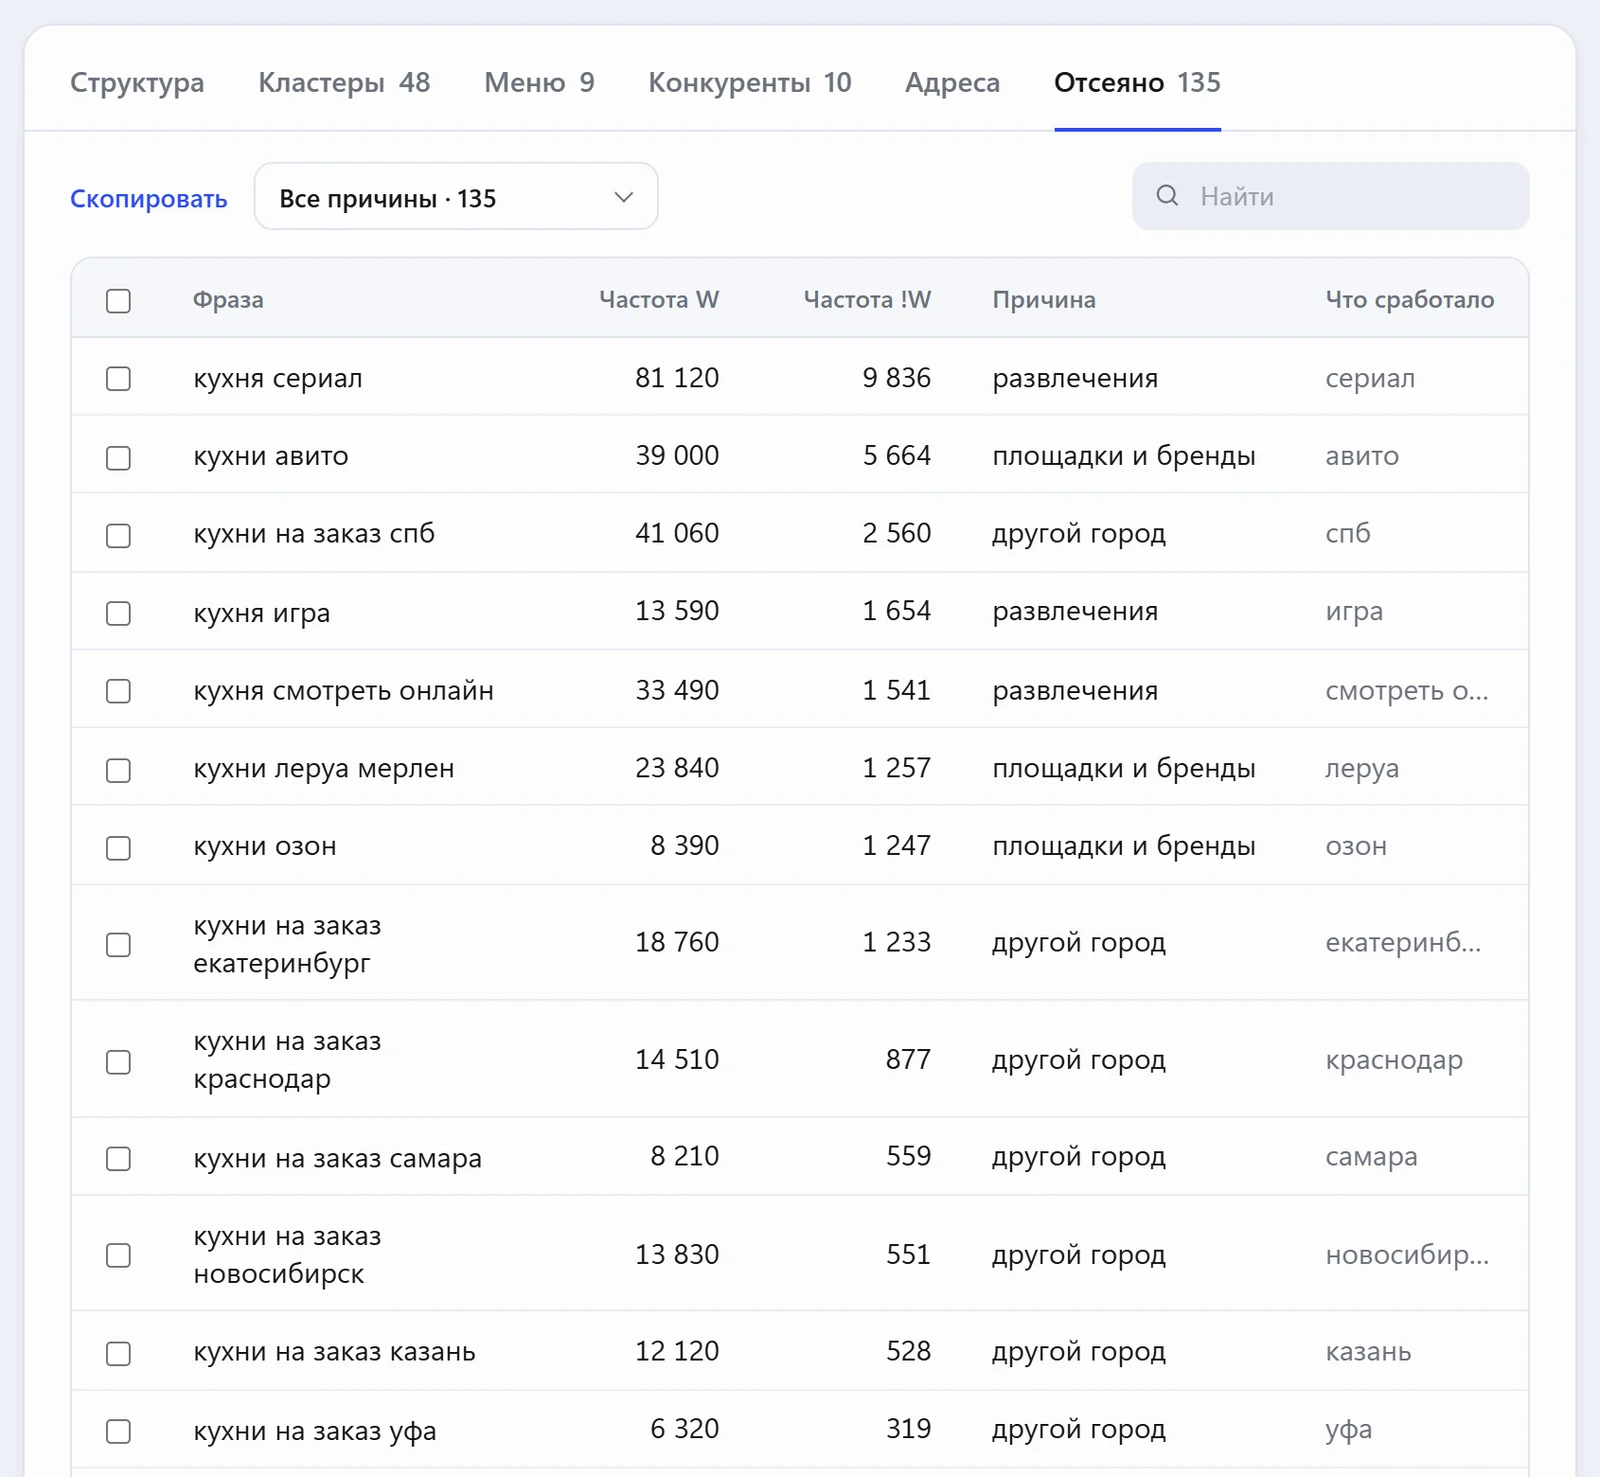
Отсеянное с причиной
Фразы, которые сайту не нужны: развлечения, площадки и бренды, другие города, скачать и торренты - и слово, которое сработало.
- Фильтр по причине
- Любую фразу можно вернуть
- Копируется списком
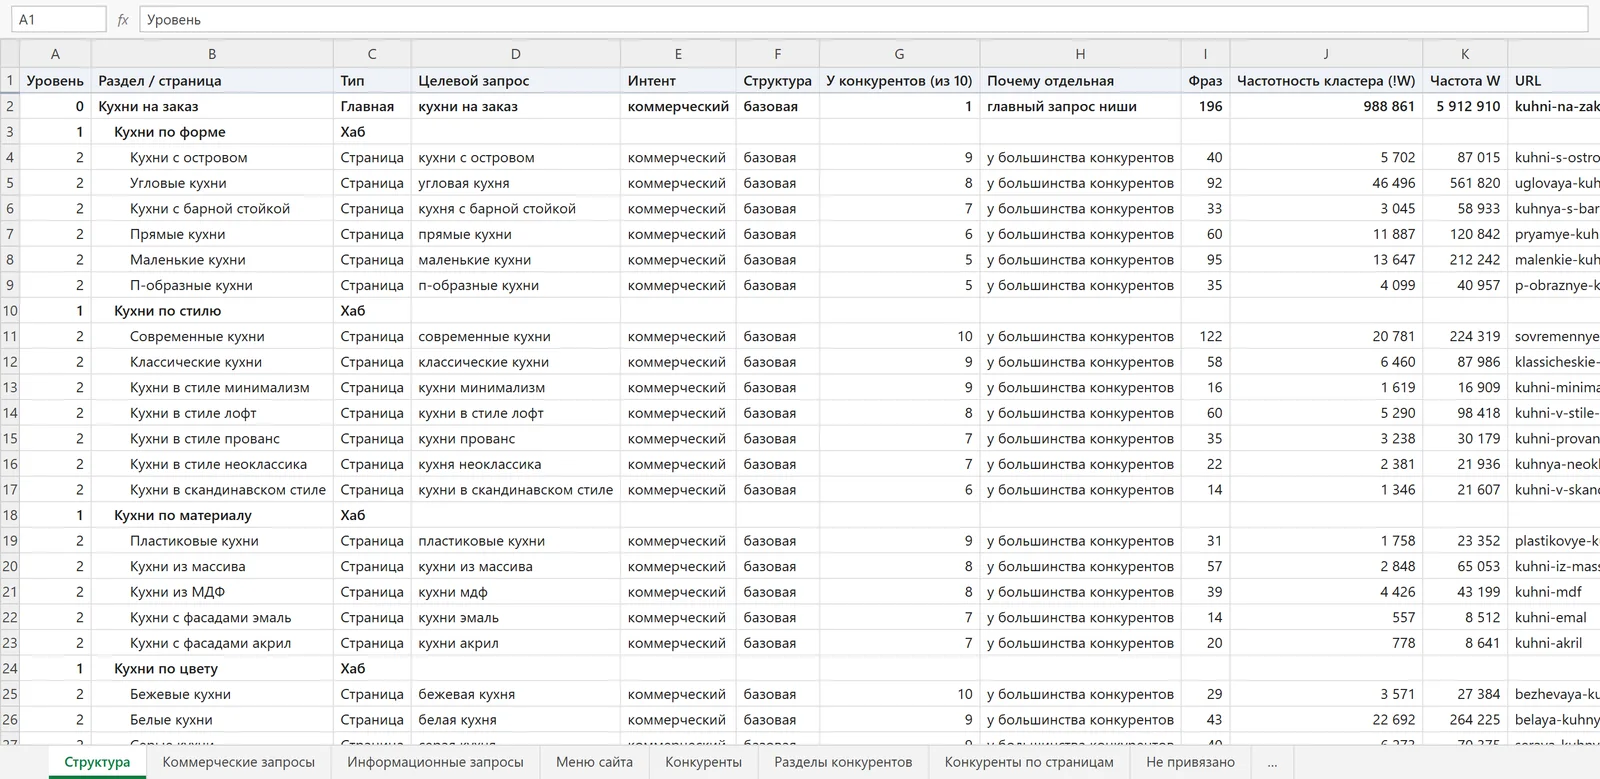
Пример
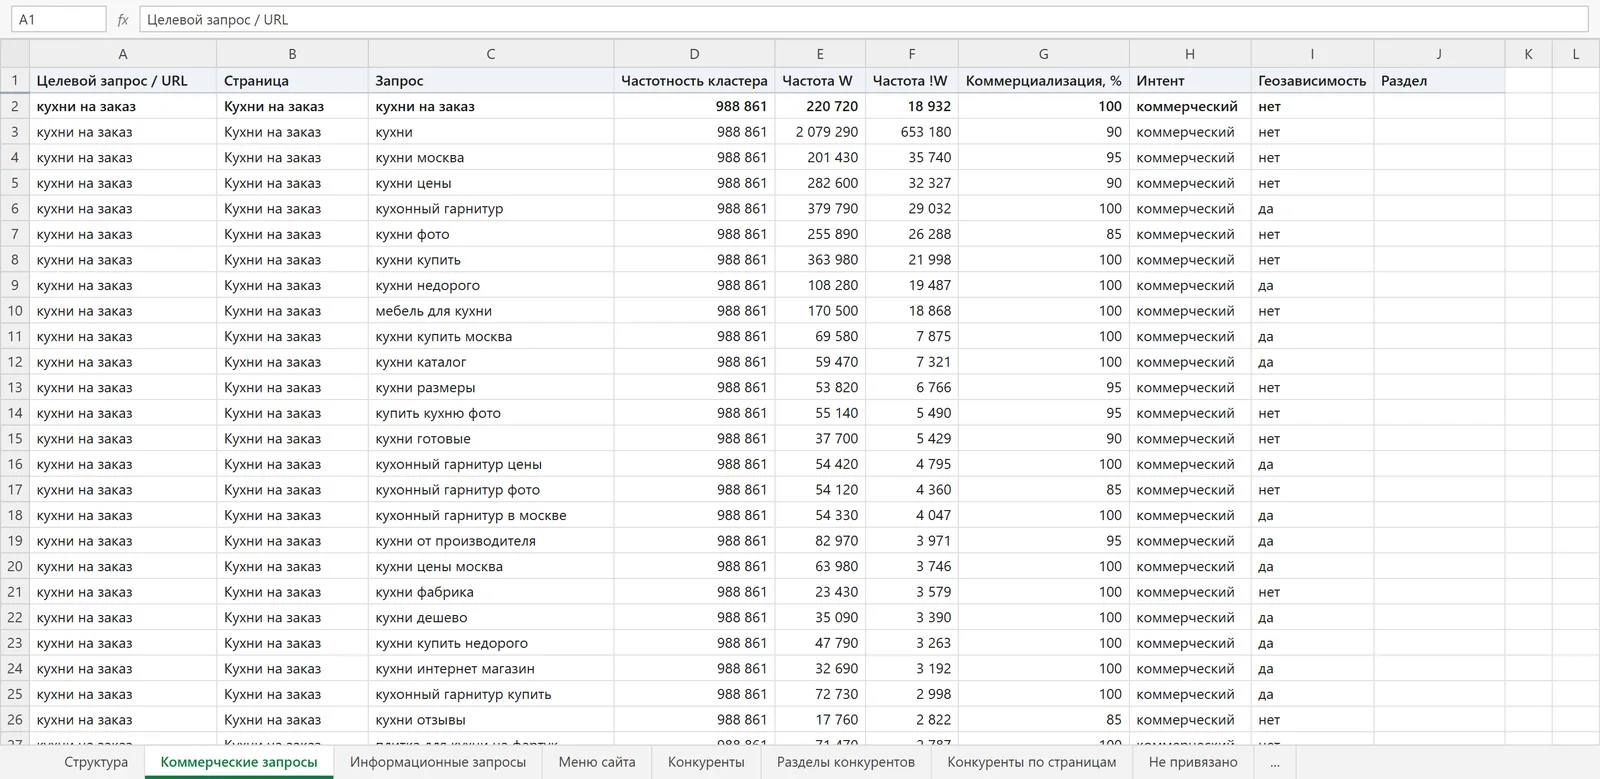
Так выглядит ядро в Excel
Ниша «кухни на заказ», Москва; данные - демонстрационные. Листы и колонки - как в настоящей выгрузке программы: структура, запросы по страницам, меню сайта, конкуренты, отсеянное и параметры сбора.
Преимущества
Почему удобно собирать семантическое ядро в SERP-X
Структура первой
Сначала каркас по разделам конкурентов, потом к страницам привязываются фразы - как собирает опытный специалист.
Только прямые конкуренты
Агрегаторы, маркетплейсы и статьи в разбор структуры не идут.
Чистое ядро
Другие города, площадки, бренды, развлечения и обрывки - в «Отсеяно» с причиной.
Частоты W и !W
У каждой фразы и страницы - спрос; чистовое ядро пересчитывается по порогу частоты без новых запросов.
H1, Title и Description
У каждой страницы - название для меню и мета-теги.
Excel и XMind
Одна строка - одна фраза со своей страницей; структура - картой для XMind.
Подробно
Как собрать семантическое ядро сайта
Семантическое ядро - это набор ключевых слов и фраз, по которым пользователи ищут товары, услуги или ответы вашей тематики, разложенный по документам сайта. От него зависят каркас сайта, тексты, мета-теги и перелинковка, а для контекстной рекламы - группы объявлений и минус-слова. Сбор семантического ядра - первый этап продвижения: без него непонятно, что создавать и под какие запросы оптимизировать.
Ниже - как устроен процесс, какие инструменты для этого используют и что делать с готовым ядром. Тот же порядок работы SERP-X проходит автоматически, а все решения видны в таблице.
Этапы сбора семантического ядра
- Маркеры. Основные запросы тематики: что продаёт бизнес, какие услуги оказывает, в каком регионе работает. Для интернет-магазина это категории товаров, для услуг - виды работ.
- Расширение. Подбор ключевых слов вокруг маркеров: база фраз, Яндекс Вордстат, поисковые подсказки, запросы лидеров тематики. На этом этапе набор ключей вырастает до тысяч фраз.
- Частотность. Число показов фразы в месяц. Без частотности не отличить популярные запросы от случайных и не распределить силы.
- Чистка. Убрать нецелевые запросы: чужие города, бренды, «скачать», «бесплатно», рефераты, пустые фразы без показов.
- Кластеризация. Группировка ключевых слов: запросы с общими сайтами в ТОП-10 продвигают одним документом, остальные - разными.
- Каркас сайта. Группа получает свой адрес и место в навигации: категории, подкатегории, карточки, статьи блога.
Где искать ключевые слова
Основные источники запросов - Яндекс Вордстат и базы ключевых фраз: в них видно, что и как часто вводят пользователи. Поисковые подсказки Яндекса и Google дают свежие формулировки и вопросы, которых ещё нет в базах. Статистика Яндекс Вебмастера и Google Search Console показывает запросы, по которым сайт уже получает показы, - это готовые точки роста для действующих проектов.
Ещё один источник - сайты, которые уже продвигаются в вашей тематике: их навигация, категории и посадочные документы подсказывают направления, о которых легко забыть. Важно брать данные о спросе в нужном регионе: в Москве и в Новосибирске один и тот же запрос ищут по-разному.
Вручную, в Key Collector или в сервисе
Самостоятельно ядро составляют в Вордстате и электронной таблице: выгрузить запросы, снять частотность, отсеять мусор, сгруппировать. Для небольшого сайта на 20-30 адресов это реально, но занимает несколько дней работы, а результат зависит от опыта специалиста.
Key Collector и похожие программы ускоряют парсинг, но требуют настройки: аккаунты Яндекса, прокси, антикапча, правила чистки и кластеризации. Это вариант для тех, кто собирает семантику каждый день и понимает, какие настройки выбрать для конкретной задачи.
Сервис сбора семантического ядра берёт рутину на себя. В SERP-X достаточно описать тематику парой слов: источники запросов, частотность, чистка, группировка и каркас появятся сами, а специалисту остаётся проверить результат и поправить спорные решения.
Почему ядро собирают по сайтам из ТОП-10
Сайты, которые уже стоят высоко по запросам тематики, показывают, чего ждёт поисковая система: какие категории есть почти у всех, какие услуги вынесены отдельно, где нужны статьи. Сбор семантического ядра на такой основе даёт готовый каркас и проверенный список направлений, а не только набор ключевых слов.
Брать стоит прямых соперников - такой же бизнес в том же регионе. Агрегаторы, маркетплейсы и информационные порталы держатся в поиске по другим причинам, и повторять их устройство не нужно. SERP-X отбирает сайты по главной странице и показывает, кто попал в разбор, а кто нет.
Частотность: W, «W» и !W
Частотность запроса бывает базовой и точной. Базовая (W) - число показов фразы со всеми продолжениями: в «купить диван» входят и «купить диван угловой», и «купить диван в Москве недорого». Фразовая («W») - только эта фраза в любом порядке слов. Точная (!W) - только эти слова в этих формах.
Ориентироваться стоит на точную частотность: фраза с W 5 000 и !W 30 почти никогда не ищется сама по себе. В SERP-X у фраз видны W и !W, а порог частотности меняется на готовом ядре без новых запросов.
Какой объём ядра нужен
Количество ключевых слов зависит от задачи, а не от желания собрать побольше. Сайту услуг в одном городе бывает достаточно нескольких сотен фраз, интернет-магазину с тысячами товаров - десятков тысяч. Важнее полнота по направлениям: у каждой категории и услуги должны быть свои запросы с понятным спросом, иначе часть аудитории просто не найдёт сайт.
Удобно начинать с высокочастотных и среднечастотных запросов, которые определяют каркас, а низкочастотные хвосты добавлять по мере наполнения. Так проект быстрее получает первый трафик, а работа идёт по плану, а не по случайному списку.
Чистка и группировка ключевых слов
Даже точный подбор приносит много лишнего: соседние тематики, другие значения слова, запросы про работу и обучение, названия площадок. Если их оставить, сайт будет продвигаться по запросам, которые не приносят заявок и продаж, а в рекламных кампаниях такие ключи сожгут бюджет.
Отдельно стоит разделить коммерческие и информационные запросы. «Купить», «цена», «заказать» - для каталога и услуг, «как выбрать», «что лучше» - для статей. Тип запроса лучше определять по поиску: если в ТОП-10 магазины, нужна коммерческая страница, если статьи - информационная.
Группировка по поисковой выдаче надёжнее группировки по словам: «диван-кровать» и «диван для сна» могут продвигаться вместе, а «угловой диван» и «угловой диван-кровать» - раздельно. SERP-X снимает выдачу по фразам и объединяет их так же, как это делает Яндекс.
Семантическое ядро для SEO и для рекламы
Ядро для поисковой оптимизации и для контекстной рекламы собирают из одних источников, но используют по-разному. В SEO запросы распределяют по адресам сайта и пишут под них тексты. В Яндекс Директе и Google Ads из тех же групп получаются рекламные кампании: каждая группа - свои объявления, а нецелевые фразы становятся минус-словами. Полезно собирать ядро один раз и брать из него обе части: так реклама и продвижение говорят с аудиторией одними словами.
Что делать после сбора семантического ядра
- Сверить каркас сайта с ядром: создать недостающие категории, объединить дубли, убрать пустые ветки.
- Подготовить мета-теги и H1, составить ТЗ на тексты для копирайтера.
- Настроить перелинковку: вес - на документы с наибольшим спросом.
- Поставить запросы на съём позиций, чтобы оценить эффективность продвижения по группам.
- Обновлять ядро раз в 3-6 месяцев: интерес пользователей меняется, появляются новые товары и формулировки.
Частые ошибки при составлении ядра
Самая частая ошибка - собрать много ключевых слов, но не связать их с адресами сайта: такой список не помогает ни каркасу, ни текстам. Вторая - ориентироваться на базовую частотность и тратить время на запросы, которые никто не вводит. Третья - смешивать на одном адресе коммерческие и информационные фразы. Четвёртая - копировать один сайт-образец вместо анализа всего ТОП-10. Пятая - не учитывать регион продвижения.
Грамотно собранное семантическое ядро помогает продвигать сайт системно: видно, что приносит трафик, где не хватает контента и что делать в следующем месяце. Поэтому SERP-X выдаёт результат в виде, удобном для работы: каркас сайта, группы фраз с частотностью, отсеянное и выгрузка в таблицу.
Вопросы
Частые вопросы
Сколько стоит сбор ядра?
Нейросеть HydraAI - обычно 30-150 ₽ за ядро ниши: чем шире ниша, тем дороже. Что войдёт и цена - видны до запуска.
Сколько времени занимает сбор?
20-60 минут. Сбор идёт в фоне - можно работать в других инструментах.
Что нужно для запуска?
Пара слов о нише и подключённый HydraAI: он разбирает разделы конкурентов и раскладывает фразы по страницам.
Можно начать со своего сайта?
Да: режим «Свой сайт» показывает, что уже есть на сайте, что есть у конкурентов и каких страниц не хватает. Есть и готовые маркеры - список страниц, под каждую фразы и частоты.
Что такое семантическое ядро сайта?
Список ключевых слов и фраз, по которым ищут товары, услуги или ответы вашей тематики, разложенный по адресам сайта: у каждого - свои запросы и их частотность.
Можно ли собрать семантическое ядро самому?
Да, вручную в Вордстате и таблице или в Key Collector - это дольше и требует опыта. В SERP-X сбор семантического ядра идёт сам, а вы проверяете и правите результат.
Как часто обновлять ядро?
Раз в 3-6 месяцев или при запуске новых товаров и услуг: интерес аудитории меняется. Повторный сбор той же тематики в SERP-X даёт тот же каркас, если поиск и сайты из ТОП-10 не изменились.
Семантика - в программе SERP-X
Все инструменты в одной программе для Windows. Начать можно бесплатно.