Сайт глазами поискового робота
Сайт глазами поискового робота: что получают Яндекс и Google вместо обычной страницы. В браузере всё в порядке, а в поиске - нет? Видно, что мешает: защита от ботов, клоакинг, пустая версия для смартфонов.
- Четыре взгляда на страницу
- Компьютер и телефон
- Отличия - красным
Как работает
Четыре ответа на одну страницу - рядом
Вставьте адреса
Страницы, которые важны: главная, разделы, карточки, статьи.
Программа запрашивает
Каждую - как браузер на компьютере и телефоне, как робот Яндекса и робот Google.
Сравнивает
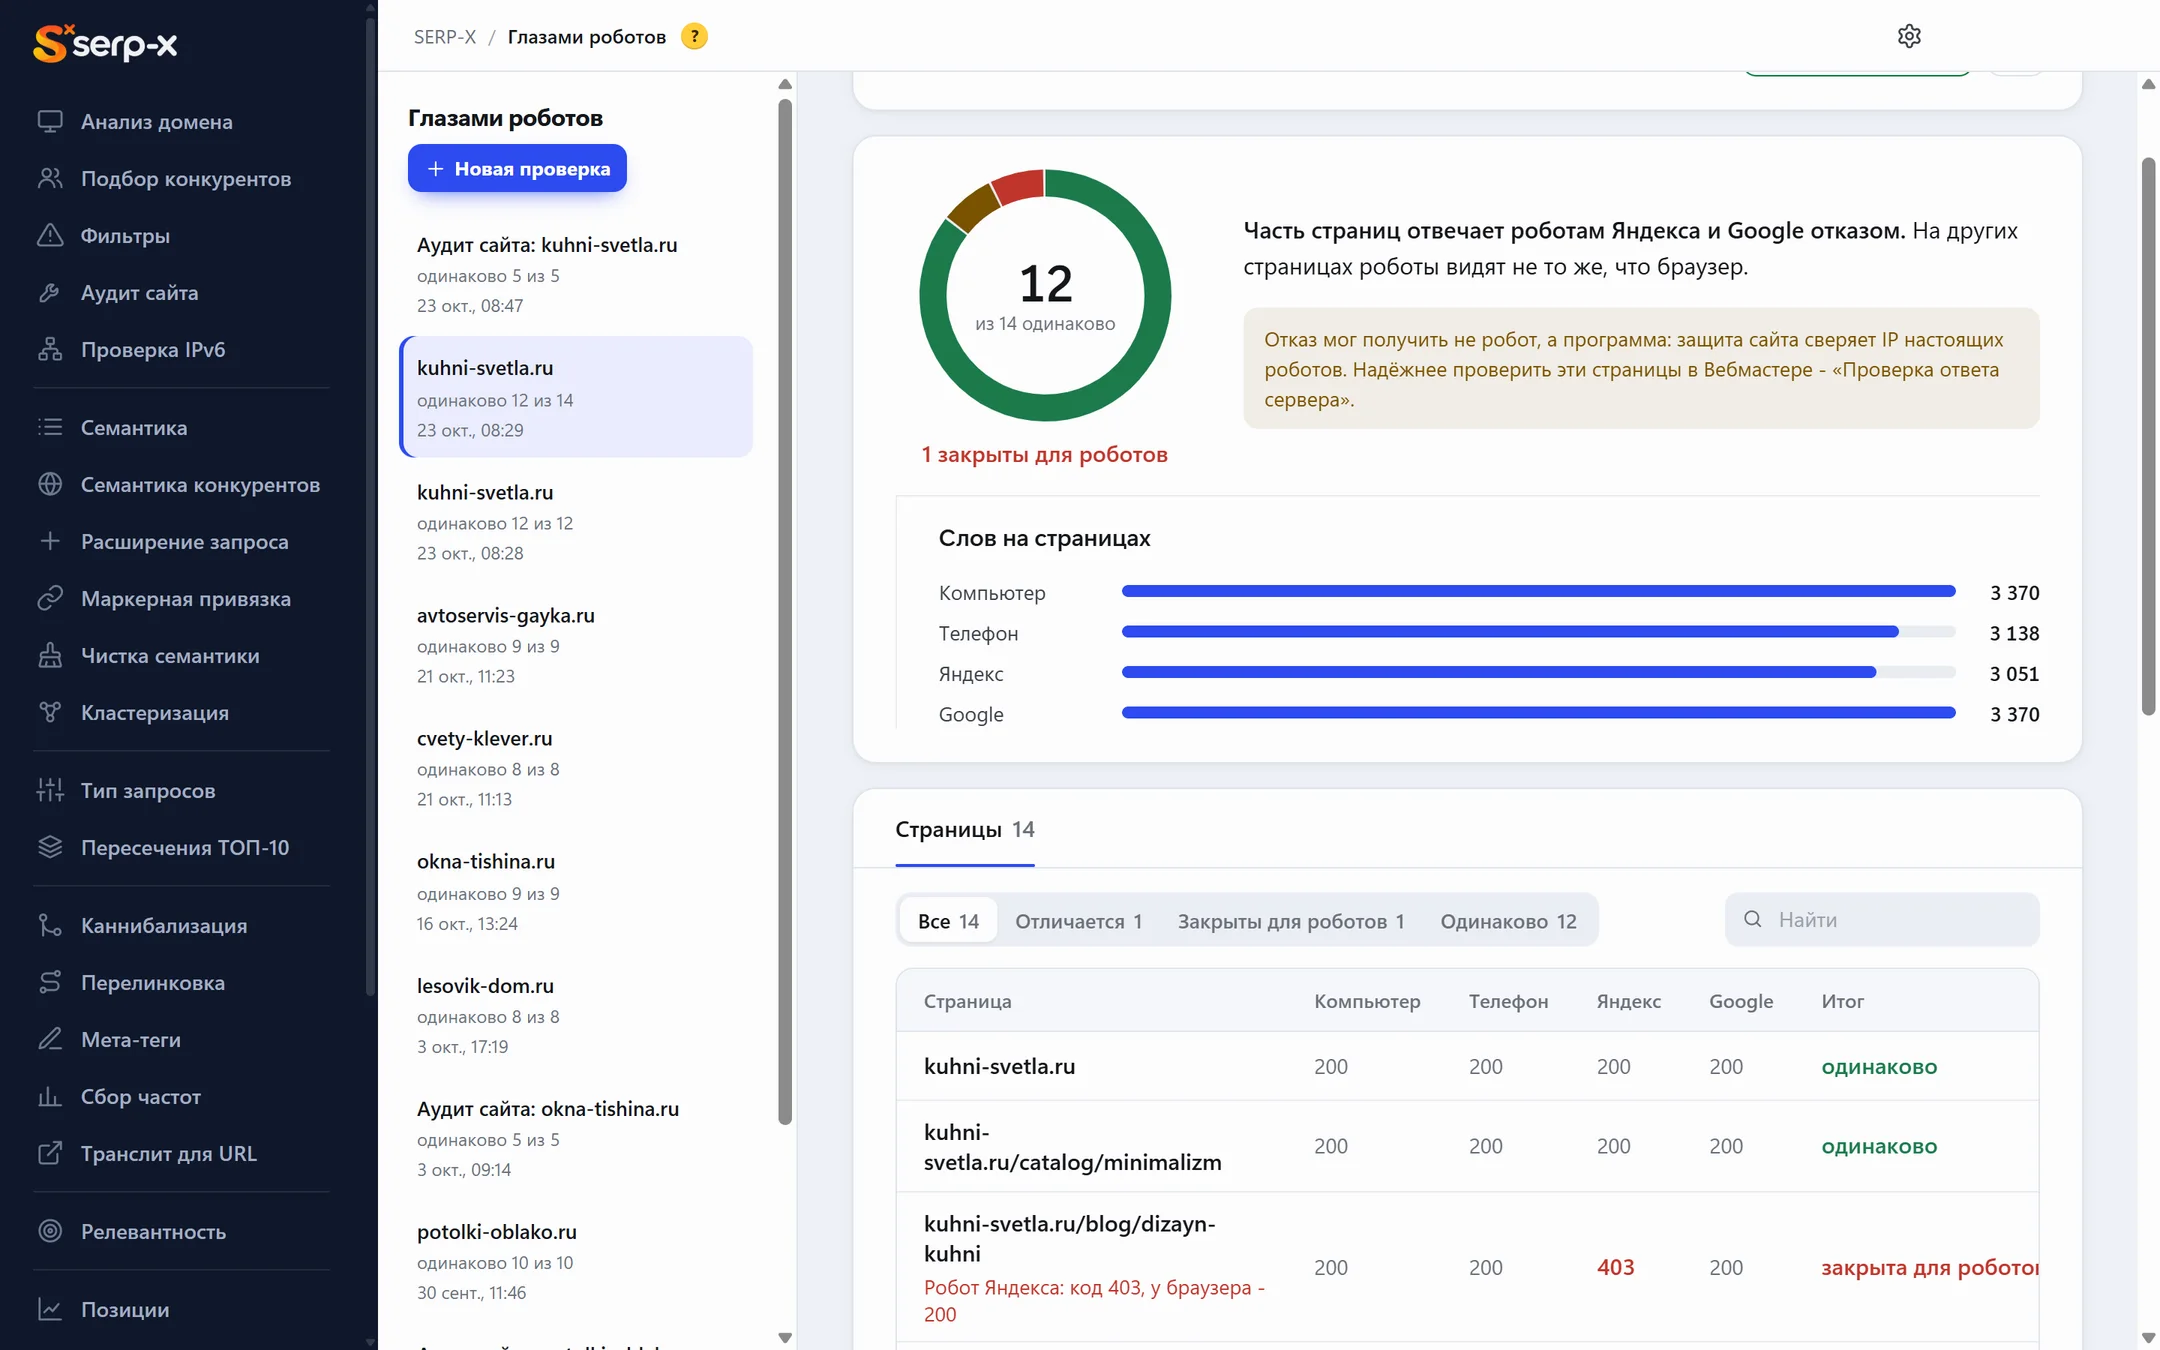
Код ответа, объём текста, ссылки и заголовки - что отличается, подсвечено красным под адресом.
Что получите
Робот видит не то, что посетитель? Узнаете первыми
Итог
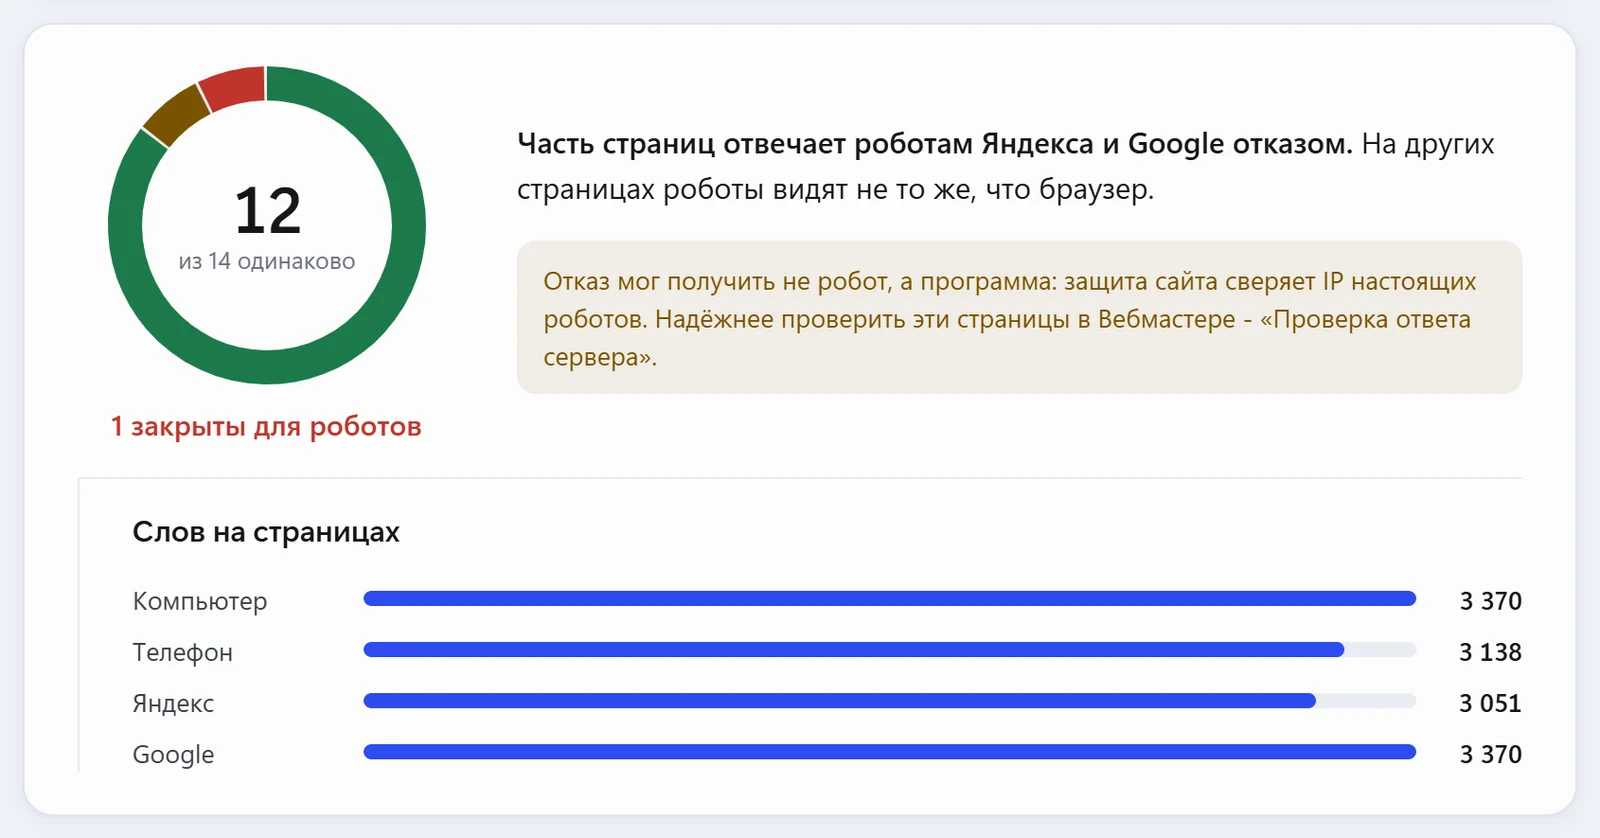
Сколько страниц роботы видят так же, как браузер, и вывод одной фразой. Справа - объём текста у каждого «зрителя».
- Защита от ботов, которая режет роботов
- Разные версии для роботов
- Мобильная версия без текста
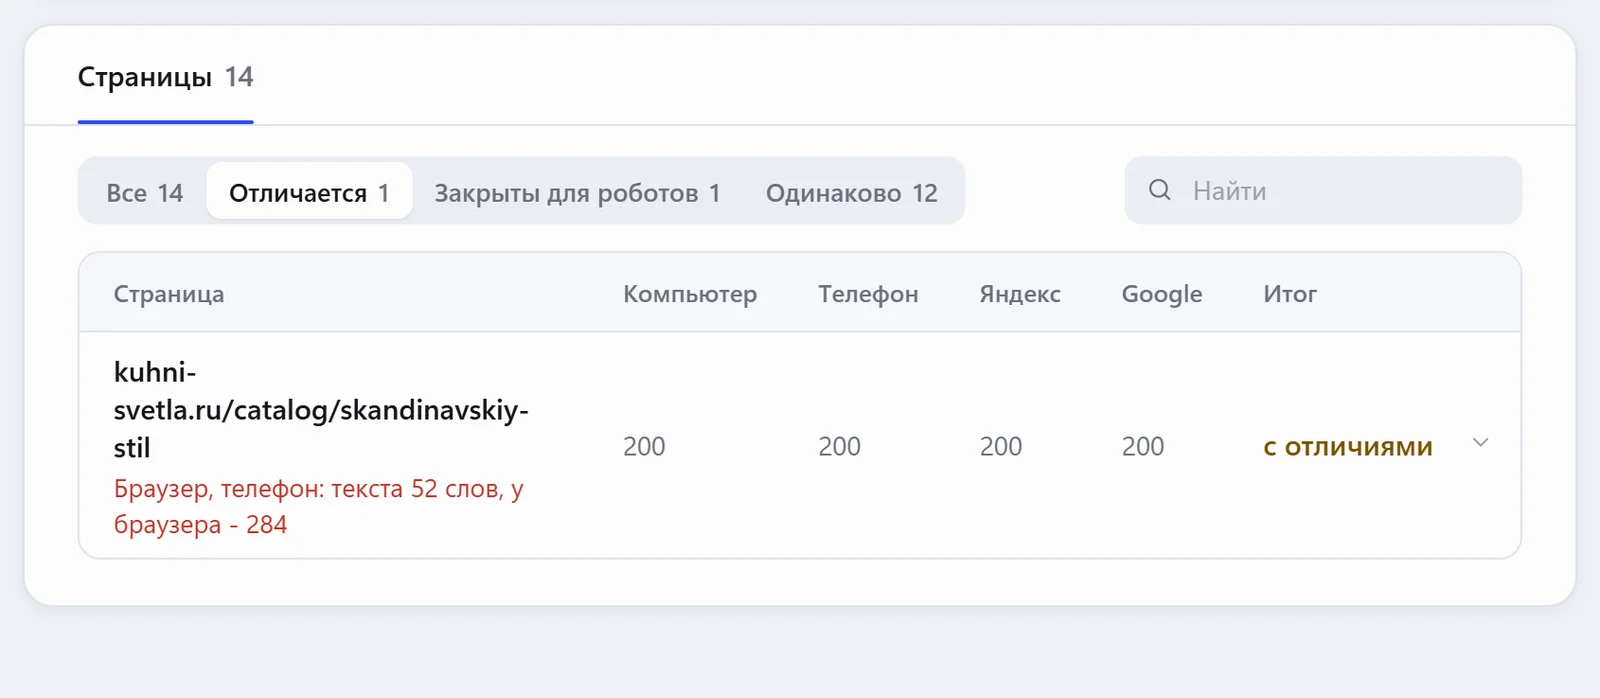
Страница с отличиями
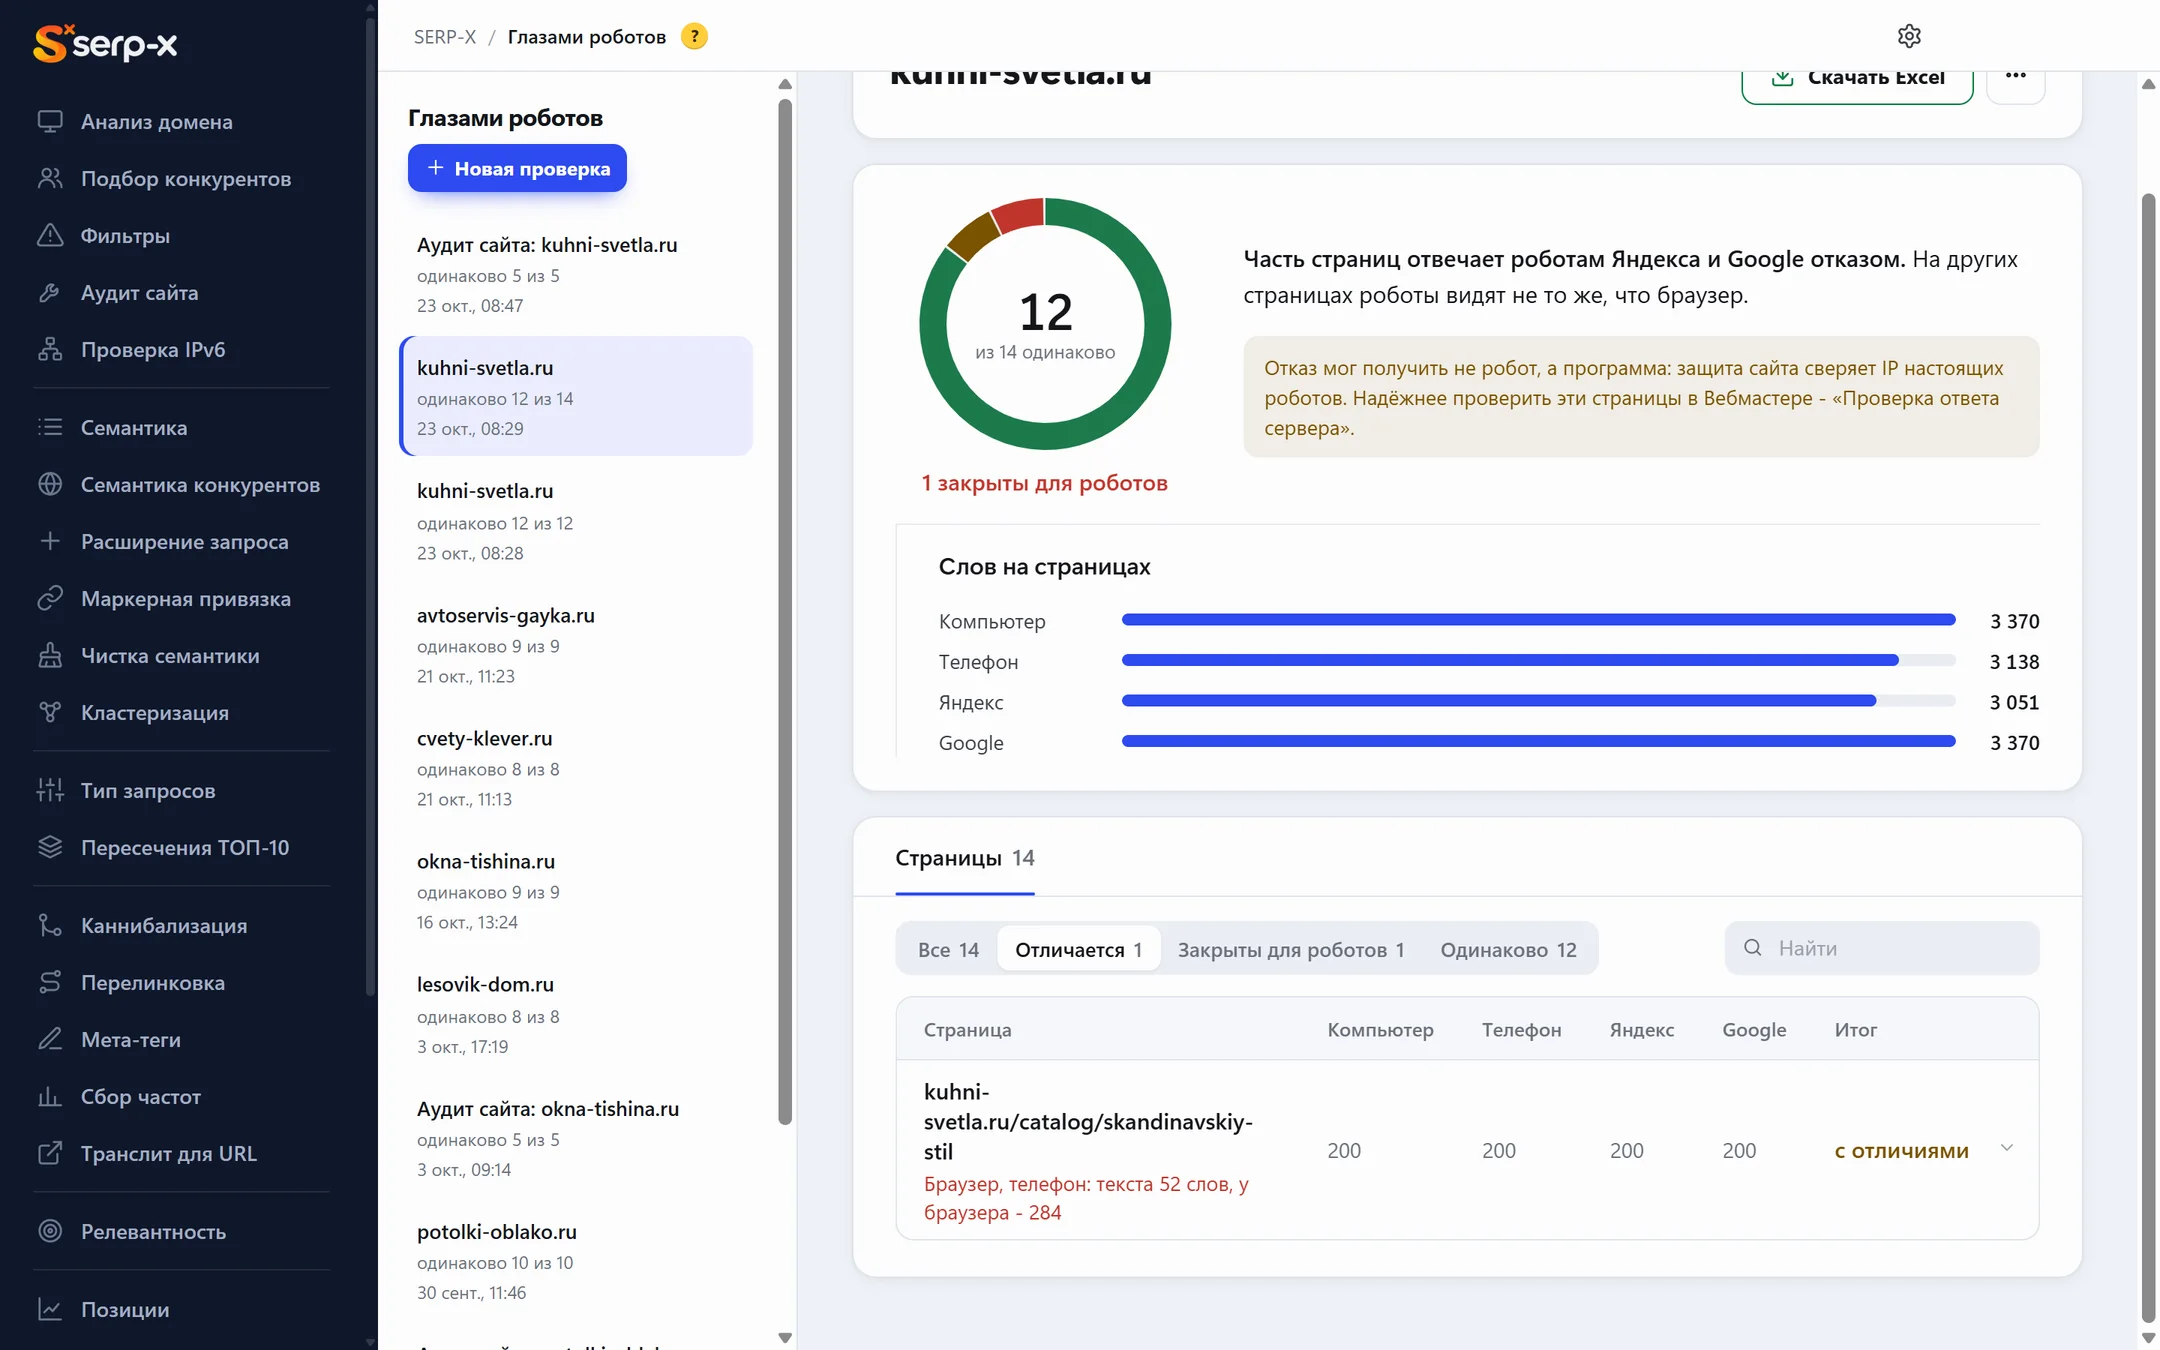
Здесь мобильный шаблон раздела отдаёт 52 слова вместо 284 - робот с телефона увидит пустую страницу.
- Четыре ответа в одной строке
- Отличие - словами под адресом
- Отбор «Отличается»
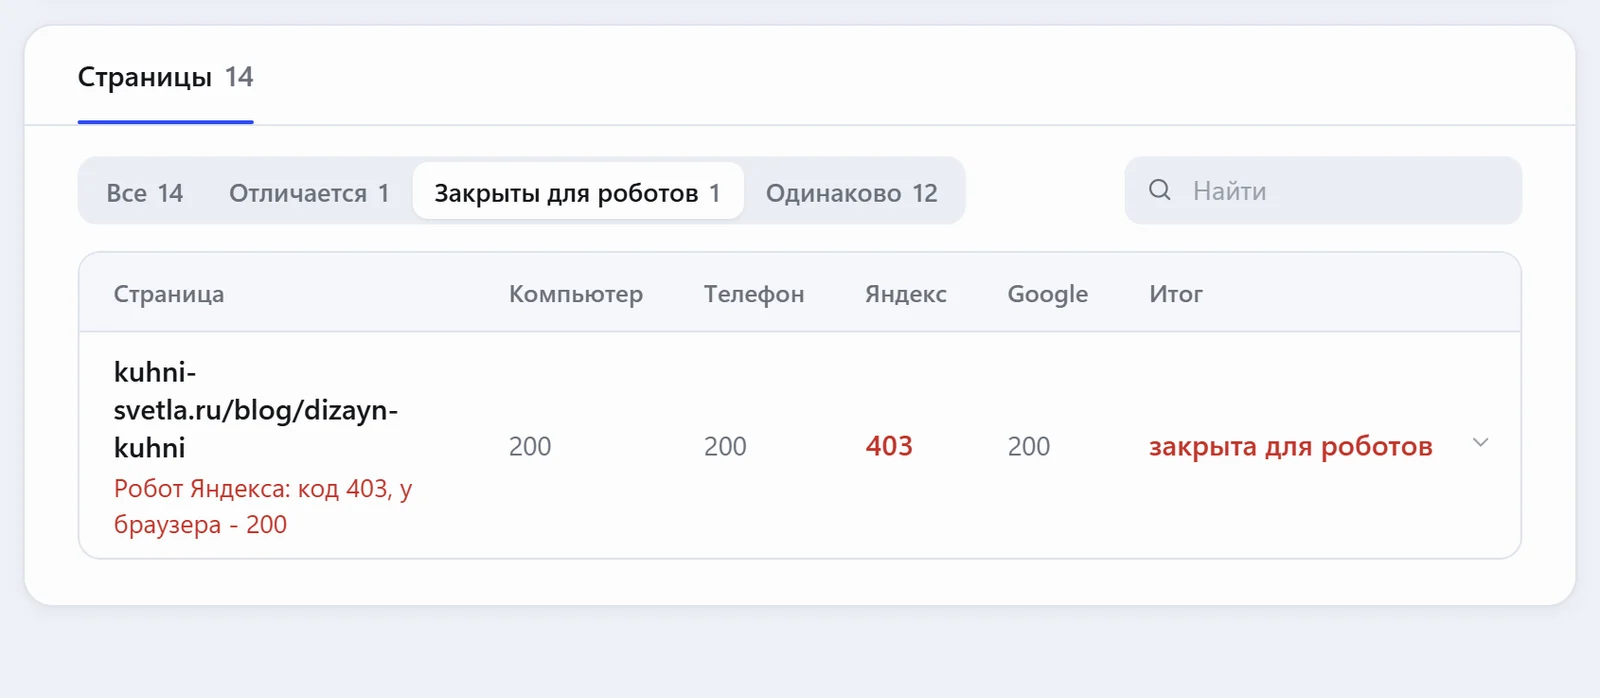
Закрыта для роботов
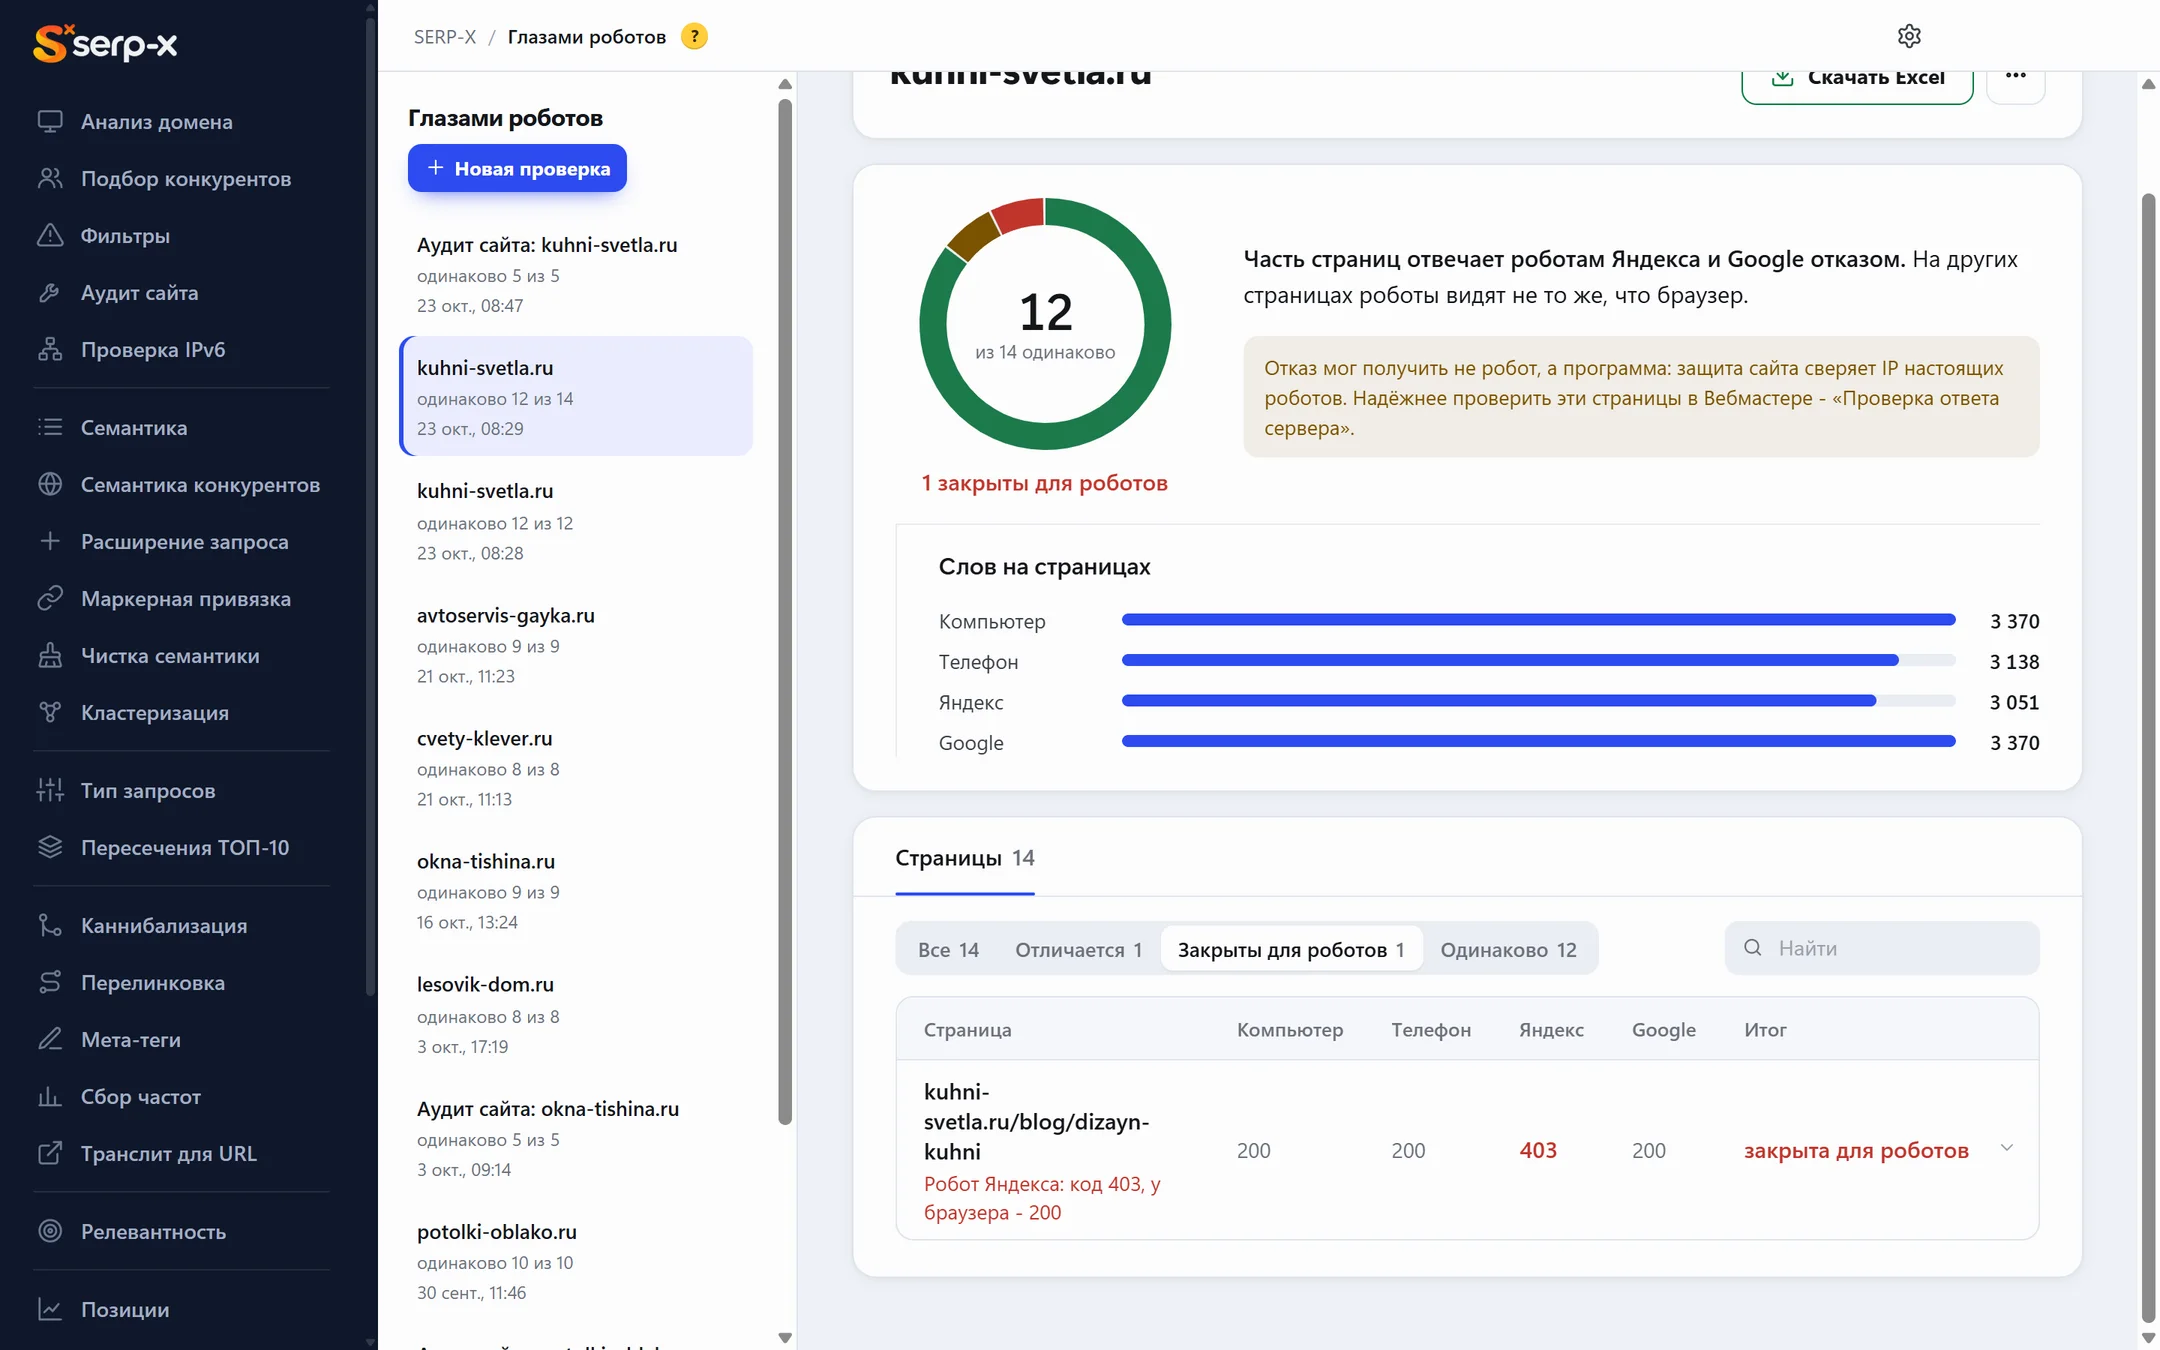
Браузеру - 200, роботу Яндекса - 403: статья выпадет из поиска, а в браузере всё работает.
- Отбор «Закрыты для роботов»
- Подсказка, как перепроверить в Вебмастере
- Excel
Преимущества
Почему удобно проверять в SERP-X
Четыре зрителя сразу
Компьютер, смартфон, Яндекс и Google - одним запуском, а не по очереди в разных сервисах.
Видно защиту от ботов
Если защита режет роботов, вывод скажет об этом прямо.
Мобильная версия
Отдельный ответ для смартфона - пустой мобильный шаблон не пройдёт незамеченным.
Отличия словами
Не нужно сравнивать HTML глазами - программа пишет, что именно не совпало.
Списком
Десятки страниц за раз, с отборами и Excel.
В полном аудите
Входит в «Аудит сайта» с набором «Полный».
Подробно
Как посмотреть на сайт глазами поискового робота
Посмотреть на сайт глазами поискового робота - значит увидеть страницу так, как её получают Яндекс и Google: код ответа сервера, HTML-код, текст, ссылки и заголовки, без дизайна и без действий пользователя. Посетитель видит готовую картинку в браузере, а робот работает с исходным кодом и с тем, что успели выполнить скрипты. Если версии расходятся, страдает индексирование: страницы теряют трафик, хотя визуально всё выглядит нормально.
Зачем проверять, как поисковый робот видит страницу
Поисковые системы ранжируют то, что смогли получить, обработать и добавить в индекс, а не то, что отображается на экране у человека. Частые причины расхождений:
- основной контент подгружает JavaScript уже после загрузки страницы, а в исходном HTML его нет;
- защита от ботов или настройки хостинга отдают роботу ошибку 403, капчу или пустой ответ;
- для смартфонов сайт отдаёт другой шаблон, в котором меньше текста, ссылок и изображений;
- страница закрыта в robots.txt, метатегом noindex или указывает canonical на другой URL;
- робот попадает в цепочку редиректов или на версию для другого региона.
Такие технические ошибки редко заметны при обычном просмотре. Их находят, когда трафик уже упал, а новые материалы блога, карточки товаров или страницы услуг неделями не попадают в индекс. Проверка глазами робота помогает найти проблему раньше: на этапе разработки, после публикации, редизайна, переезда на другой движок или изменения настроек сервера. Для интернет-магазина или сайта компании с тысячами URL это реальная экономия времени и трафика.
Что видит робот и чего он не делает
Робот заходит на страницу как особый пользователь: со своим user-agent, без cookie и без истории просмотров. Вся информация о странице для него - это ответ сервера, HTML-код и связанные ресурсы: файлы CSS, скрипты, изображения. Из этих данных поисковая система собирает документ для индекса: содержимое тегов Title и Description, заголовки, текст, внутренние и внешние ссылки, атрибуты alt, микроразметку. Ключевой текст, которого нет в этом документе, для ранжирования не существует.
Чего робот не делает: не нажимает кнопки, не прокручивает ленту, не заполняет формы и не ждёт долго. Текст, который появляется только по клику, во вкладке или после прокрутки, робот может не проиндексировать. Кнопки без адреса в атрибуте href поисковик не считает ссылками: страницам за ними трудно попасть в индекс, для этого нужны обычные ссылки или запись в sitemap.xml.
JavaScript и рендеринг
Многие современные сайты собирают страницу на стороне браузера: сервер возвращает почти пустой HTML, а меню, каталог товаров или текст статьи дорисовывает JavaScript. Google ставит такие страницы в отдельную очередь на обработку скриптов, Яндекс тоже умеет их выполнять, но не для всех страниц и не сразу. Пока рендеринг не выполнен, поисковик видит пустой шаблон, а при нехватке краулингового бюджета может так и не увидеть страницу полностью.
Использование фреймворков само по себе не мешает продвижению: важно, чтобы итоговый HTML был доступен поисковику. Надёжнее, когда основной контент и навигация есть в исходном коде: серверный рендеринг (SSR), предварительная генерация страниц или отдельная отрисовка для поисковиков с тем же содержимым. Если сайт построен как SPA на клиентском рендеринге, проверьте, что у любого URL свои Title, H1 и текст, а страница доступна по прямому адресу, а не только переходом из меню. Динамический контент - фильтры, отзывы, подборки - тоже стоит отдавать так, чтобы его видели без выполнения скриптов.
Как проверить сайт глазами поискового робота вручную
Простой способ - посмотреть исходный код, более полный - сменить user-agent и отключить JavaScript. Основные методы:
- Исходный код. Откройте страницу и нажмите Ctrl+U: это HTML до выполнения скриптов. Если основного текста там нет, его добавляет JavaScript.
- Chrome DevTools. Панель разработчика позволяет на вкладке Network conditions выбрать user-agent робота Яндекса или Googlebot, а отключение JavaScript в настройках покажет, что останется на странице.
- cURL. Используйте запрос из командной строки с подписью поисковика: результаты покажут код ответа, заголовки HTTP и HTML, который получает робот.
- Сервисы поисковых систем. Полезные отчёты есть в Яндекс Вебмастере - проверка ответа сервера, и в Google Search Console - проверка URL: просканированная версия страницы, скриншот и список ресурсов, которые были недоступны при сканировании.
У любого способа свои ограничения. DevTools и cURL требуют времени и навыков, а Search Console работает только с подтверждёнными сайтами, и оба сервиса смотрят адреса по отдельности. Для пары страниц ручной способ подходит, для десятков удобнее инструмент, который быстро запрашивает их списком и сразу показывает, где версии отличаются.
Частые ошибки, которые видит только робот
- Защита от ботов режет поисковиков. Файрвол, CDN или плагин безопасности принимает бота поисковой системы за атаку: блокировка по IP или частоте, ответ 403 или капча. В браузере сайт работает, а страницы выпадают из поиска.
- Клоакинг. Роботу отдаётся другой контент, чем посетителю, например скрытый текст с ключами. Поисковые системы считают это нарушением и могут исключить страницы из выдачи, даже если подмена возникла из-за ошибки разработчика или плагина.
- Пустой шаблон для смартфонов. Поиск в первую очередь оценивает версию для смартфонов: если в ней урезан текст или меньше ссылок, в индекс попадёт урезанная страница.
- Разные ответы сервера. Ответ нередко зависит от устройства, региона и cookie: браузер получает 200, а робот - редирект, 404 или 5xx.
- Закрытые ресурсы. Если в robots.txt закрыть папки со скриптами и CSS, поисковик не сможет корректно отрисовать страницу и оценить её удобство.
- Содержимое за действием. Пример - отзывы, характеристики товаров, видео и описания во вкладках, которые загружаются только по клику и остаются вне индекса.
Эти ошибки влияют на видимость сайта сильнее, чем кажется: алгоритмы поисковых систем учитывают только то, что увидели, а количество слов и ссылок у робота может быть в разы меньше, чем у посетителя.
Что делать, если робот видит не то
План работы простой: сначала понять причину - сравнить код ответа, объём текста, ссылки и заголовки у браузера и у роботов. Решения зависят от того, что нашлось:
- правильно настроить защиту, чтобы она пропускала настоящих роботов Яндекса и Google, проверяя их по обратному DNS, а не только по user-agent;
- вынести основной контент и навигацию в исходный HTML или включить серверный рендеринг;
- выровнять версии для компьютера и смартфона по тексту, ссылкам и разметке;
- открыть нужные разделы и ресурсы в robots.txt, убрать лишние noindex и указать верный canonical;
- убрать дубли и цепочки редиректов, чтобы робот не тратил краулинговый бюджет;
- затем повторить проверку и отправить страницы на переобход в Вебмастере и Search Console.
В SERP-X сайт глазами поискового робота проверяется списком: любую страницу программа запрашивает четыре раза - как браузер на компьютере и на смартфоне, как робот Яндекса и как робот Google. Код ответа, объём текста, ссылки и заголовки сравниваются, отличия подсвечены красным под адресом, а итог коротким выводом говорит, сколько страниц роботы видят так же, как браузер. Отборы «Отличается» и «Закрыты для роботов» и выгрузка в Excel помогают передать задачу разработчику. Запросы идут не с адресов поисковиков, поэтому если сайт режет «поддельных» роботов, это видно в выводе, а подсказка объясняет, как перепроверить в Вебмастере. Проверка работает онлайн и бесплатно, а в программе входит в набор «Полный» аудита сайта.
Вопросы
Частые вопросы
Это настоящие роботы Яндекса и Google?
Нет - запросы идут с вашего компьютера с их подписью. Часть сайтов проверяет адреса настоящих роботов и режет «поддельных» - это видно в выводе, и есть подсказка, как перепроверить в Вебмастере.
Что значит «закрыта для роботов»?
Браузер получает страницу, а робот - отказ (403, капча). Такая страница может выпасть из поиска.
Зачем сравнивать с телефоном?
Поиск в первую очередь смотрит мобильную версию. Если она без текста или ссылок - позиции пострадают.
Можно проверить сайт конкурента?
Да, любые адреса.
Как проверить, как поисковый робот видит сайт?
Сравнить ответ сервера, HTML-код и текст страницы для браузера и для роботов: вручную через исходный код, DevTools и cURL с user-agent поисковика или списком адресов здесь - четыре ответа видны рядом.
Видит ли робот контент, который загружает JavaScript?
Не всегда. Google выполняет скрипты с задержкой, Яндекс - не для всех страниц. Основной текст, ссылки и мета-теги надёжнее отдавать сразу в HTML.
Что такое клоакинг?
Подмена: роботу показывают не то, что посетителю. Поисковые системы наказывают за это вплоть до исключения из выдачи, даже если разница возникла случайно - из-за плагина или настроек сервера.
Глазами роботов - онлайн, бесплатно
Без установки и без карты - в личном кабинете SERP-X. Инструменты с выдачей и нейросетью - в программе для Windows.