Парсер поисковых подсказок
Парсер поисковых подсказок покажет, что люди ищут вокруг ниши: подсказки Яндекса и Google - хвосты, уточнения и вопросы для новых страниц и материалов блога.
- Яндекс и Google
- Перебор букв и вопросов
- Страница или статья - по выдаче
Как работает
Подсказки поиска - в семантическое ядро
Впишите запросы
По одному в строке; выберите Яндекс или Google.
Программа перебирает
Сам запрос, запрос с каждой буквой и с вопросами: как, что, где, сколько, почему, можно ли.
Получите список
Как в «Семантике», по топу Яндекса: страницы - в ядро, статьи и вопросы - в контент-план.
Что получите
Хвосты для ядра и темы для статей
Итог
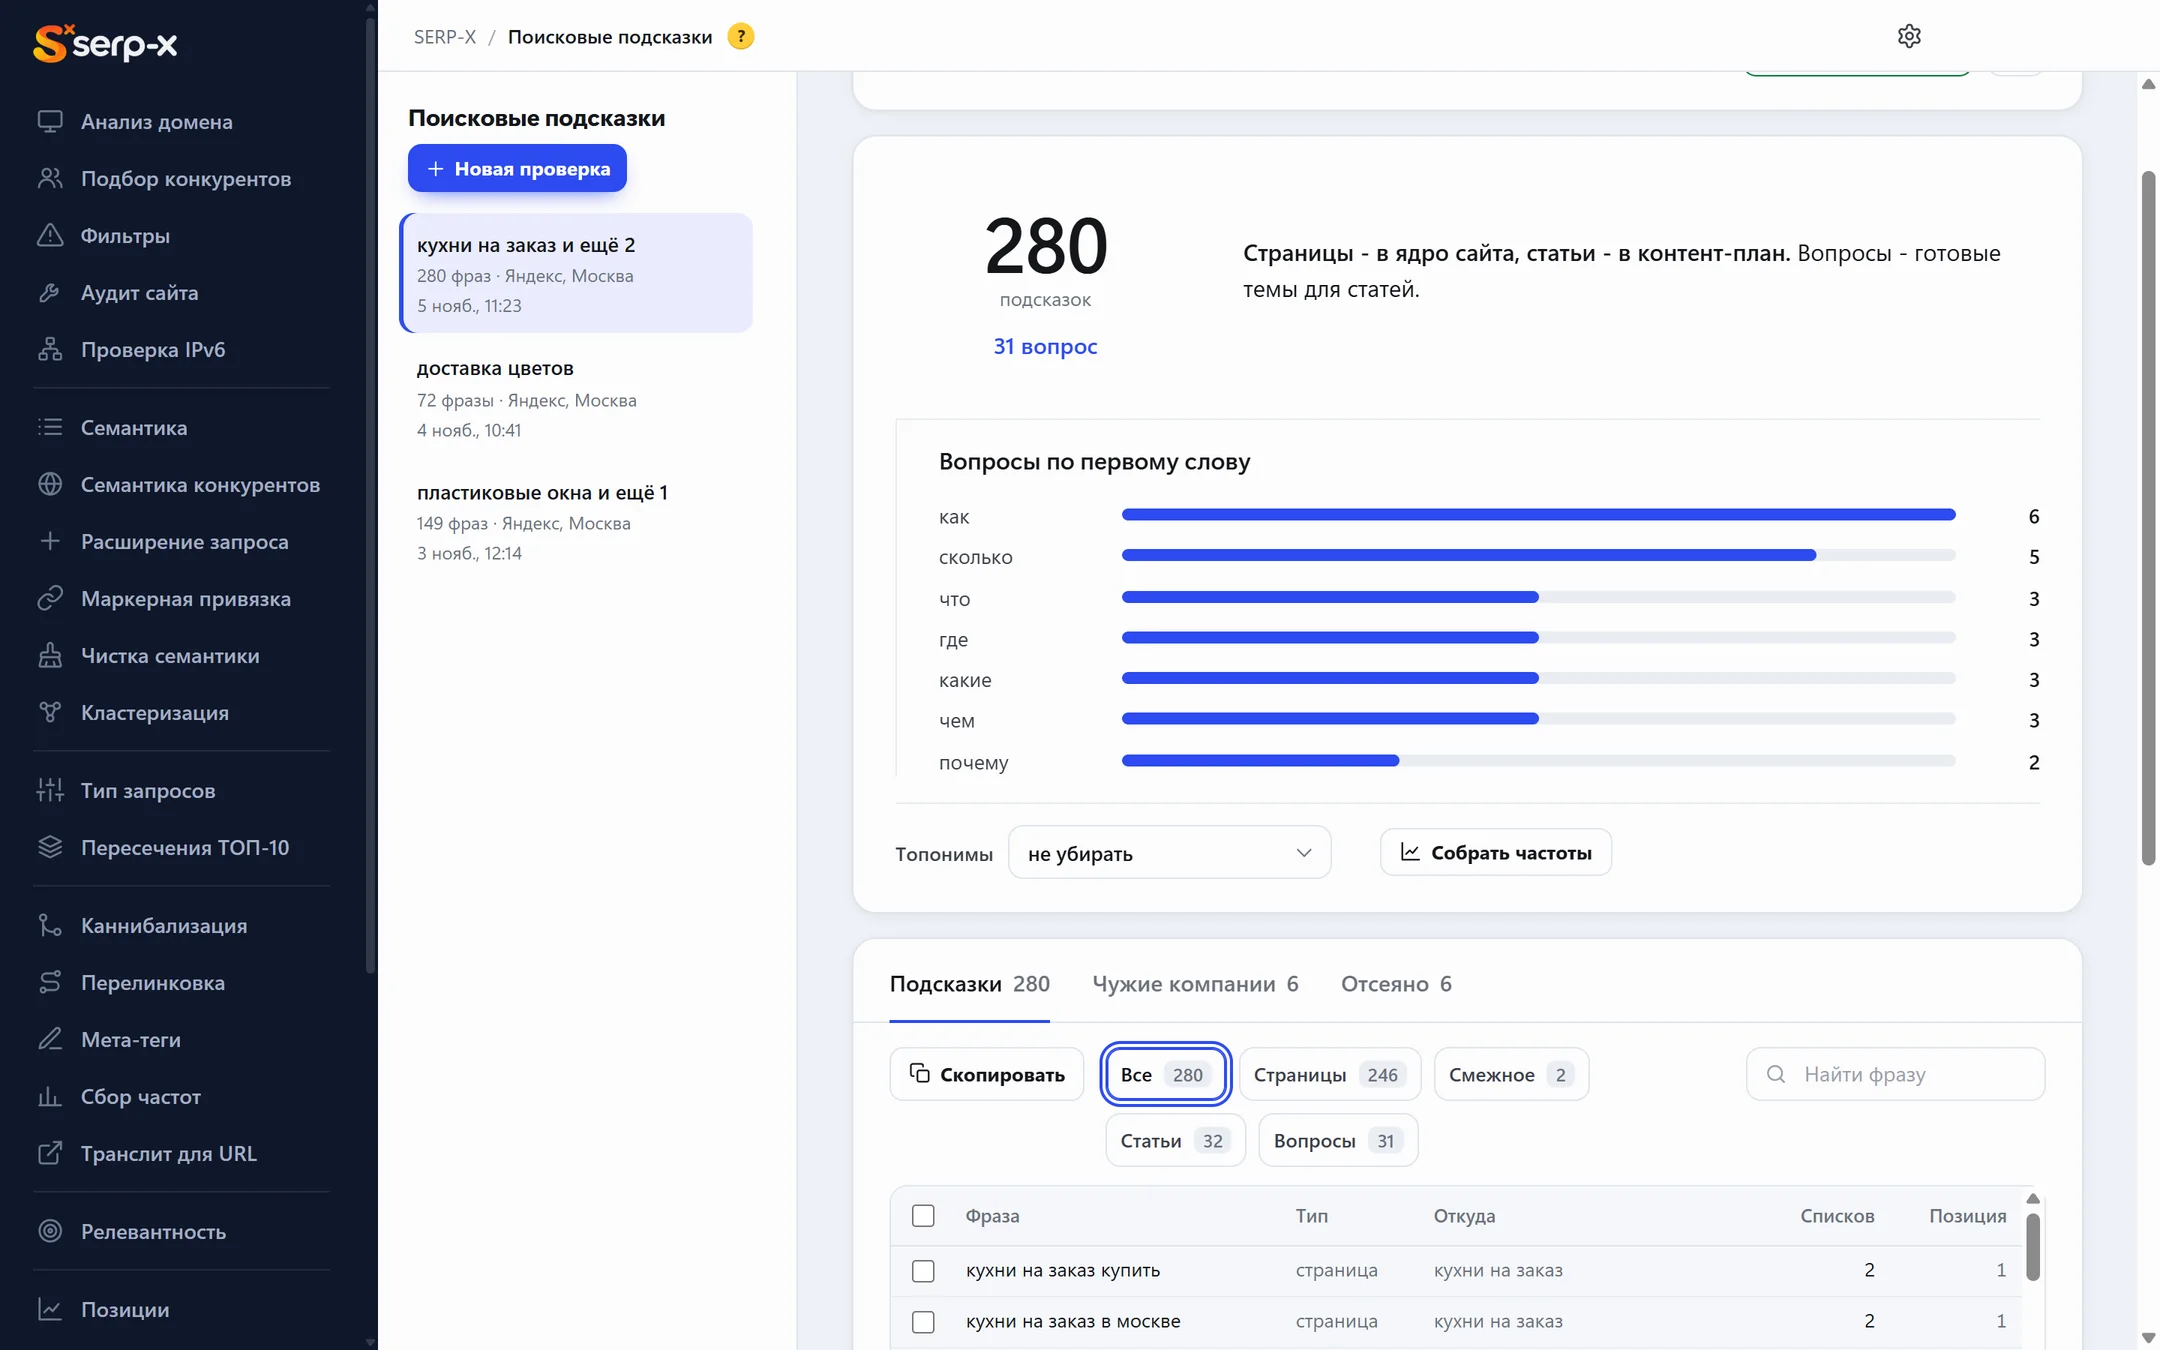
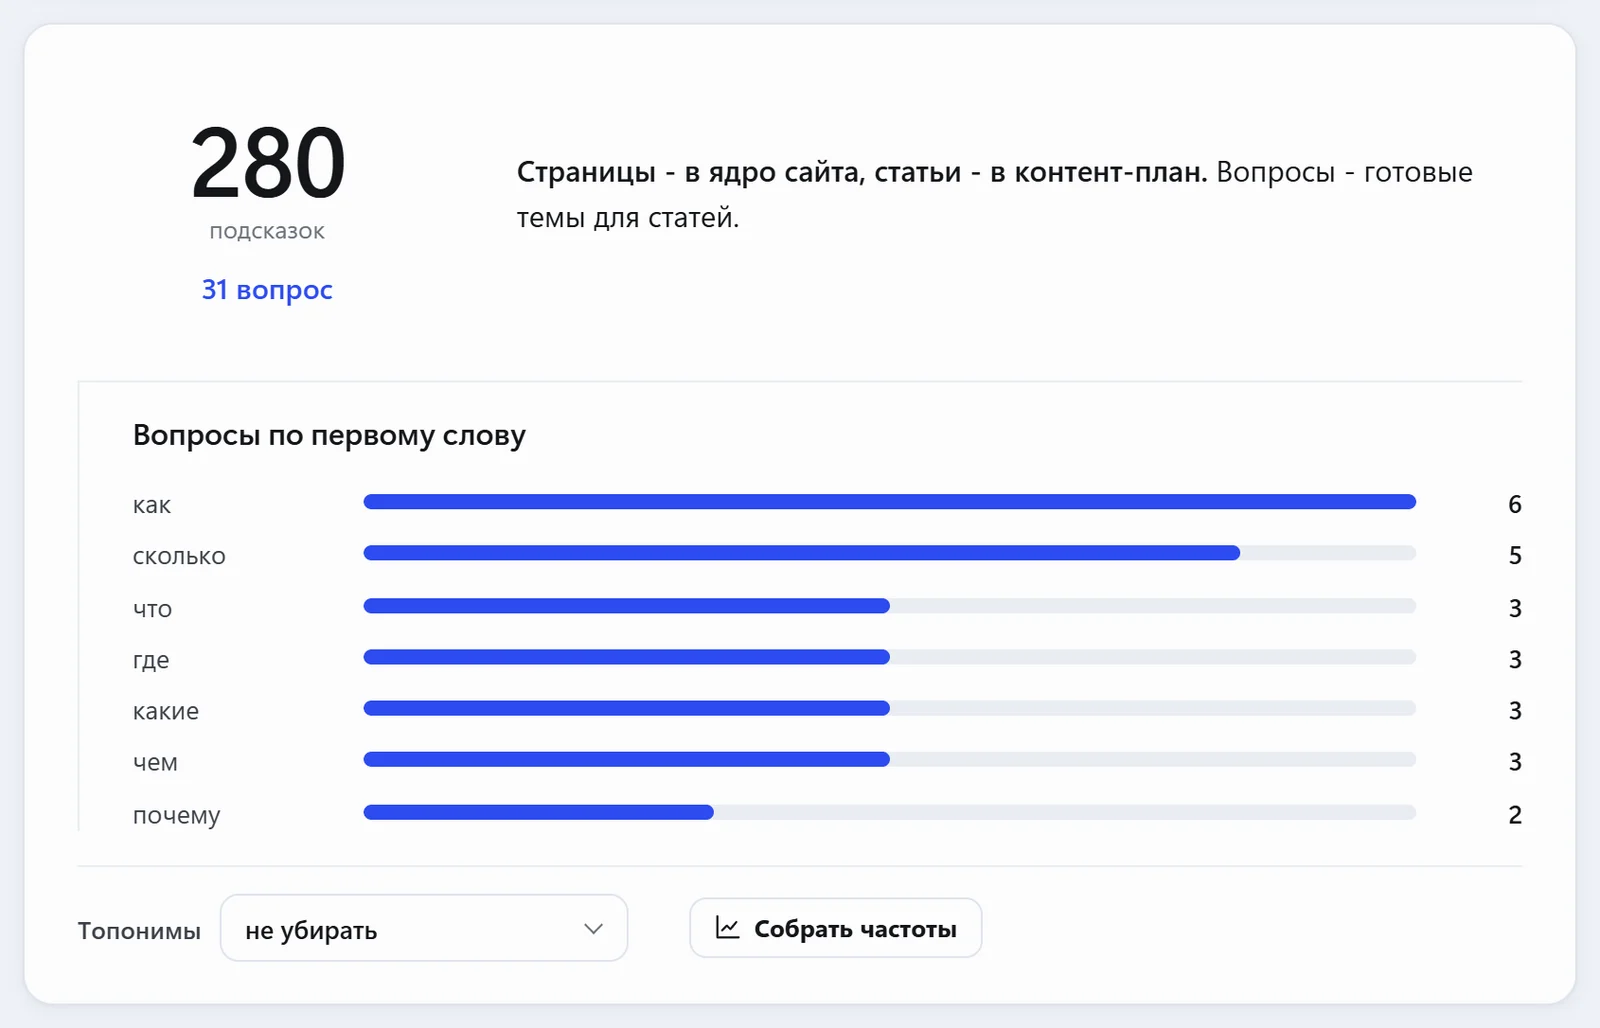
Сколько подсказок и вопросов и вывод: что пойдёт в статьи, что - в ядро. Справа - вопросы по первому слову.
- Как, что, где, сколько, почему
- Топонимы - фильтром
- Собрать частоты - одной кнопкой
Вопросы
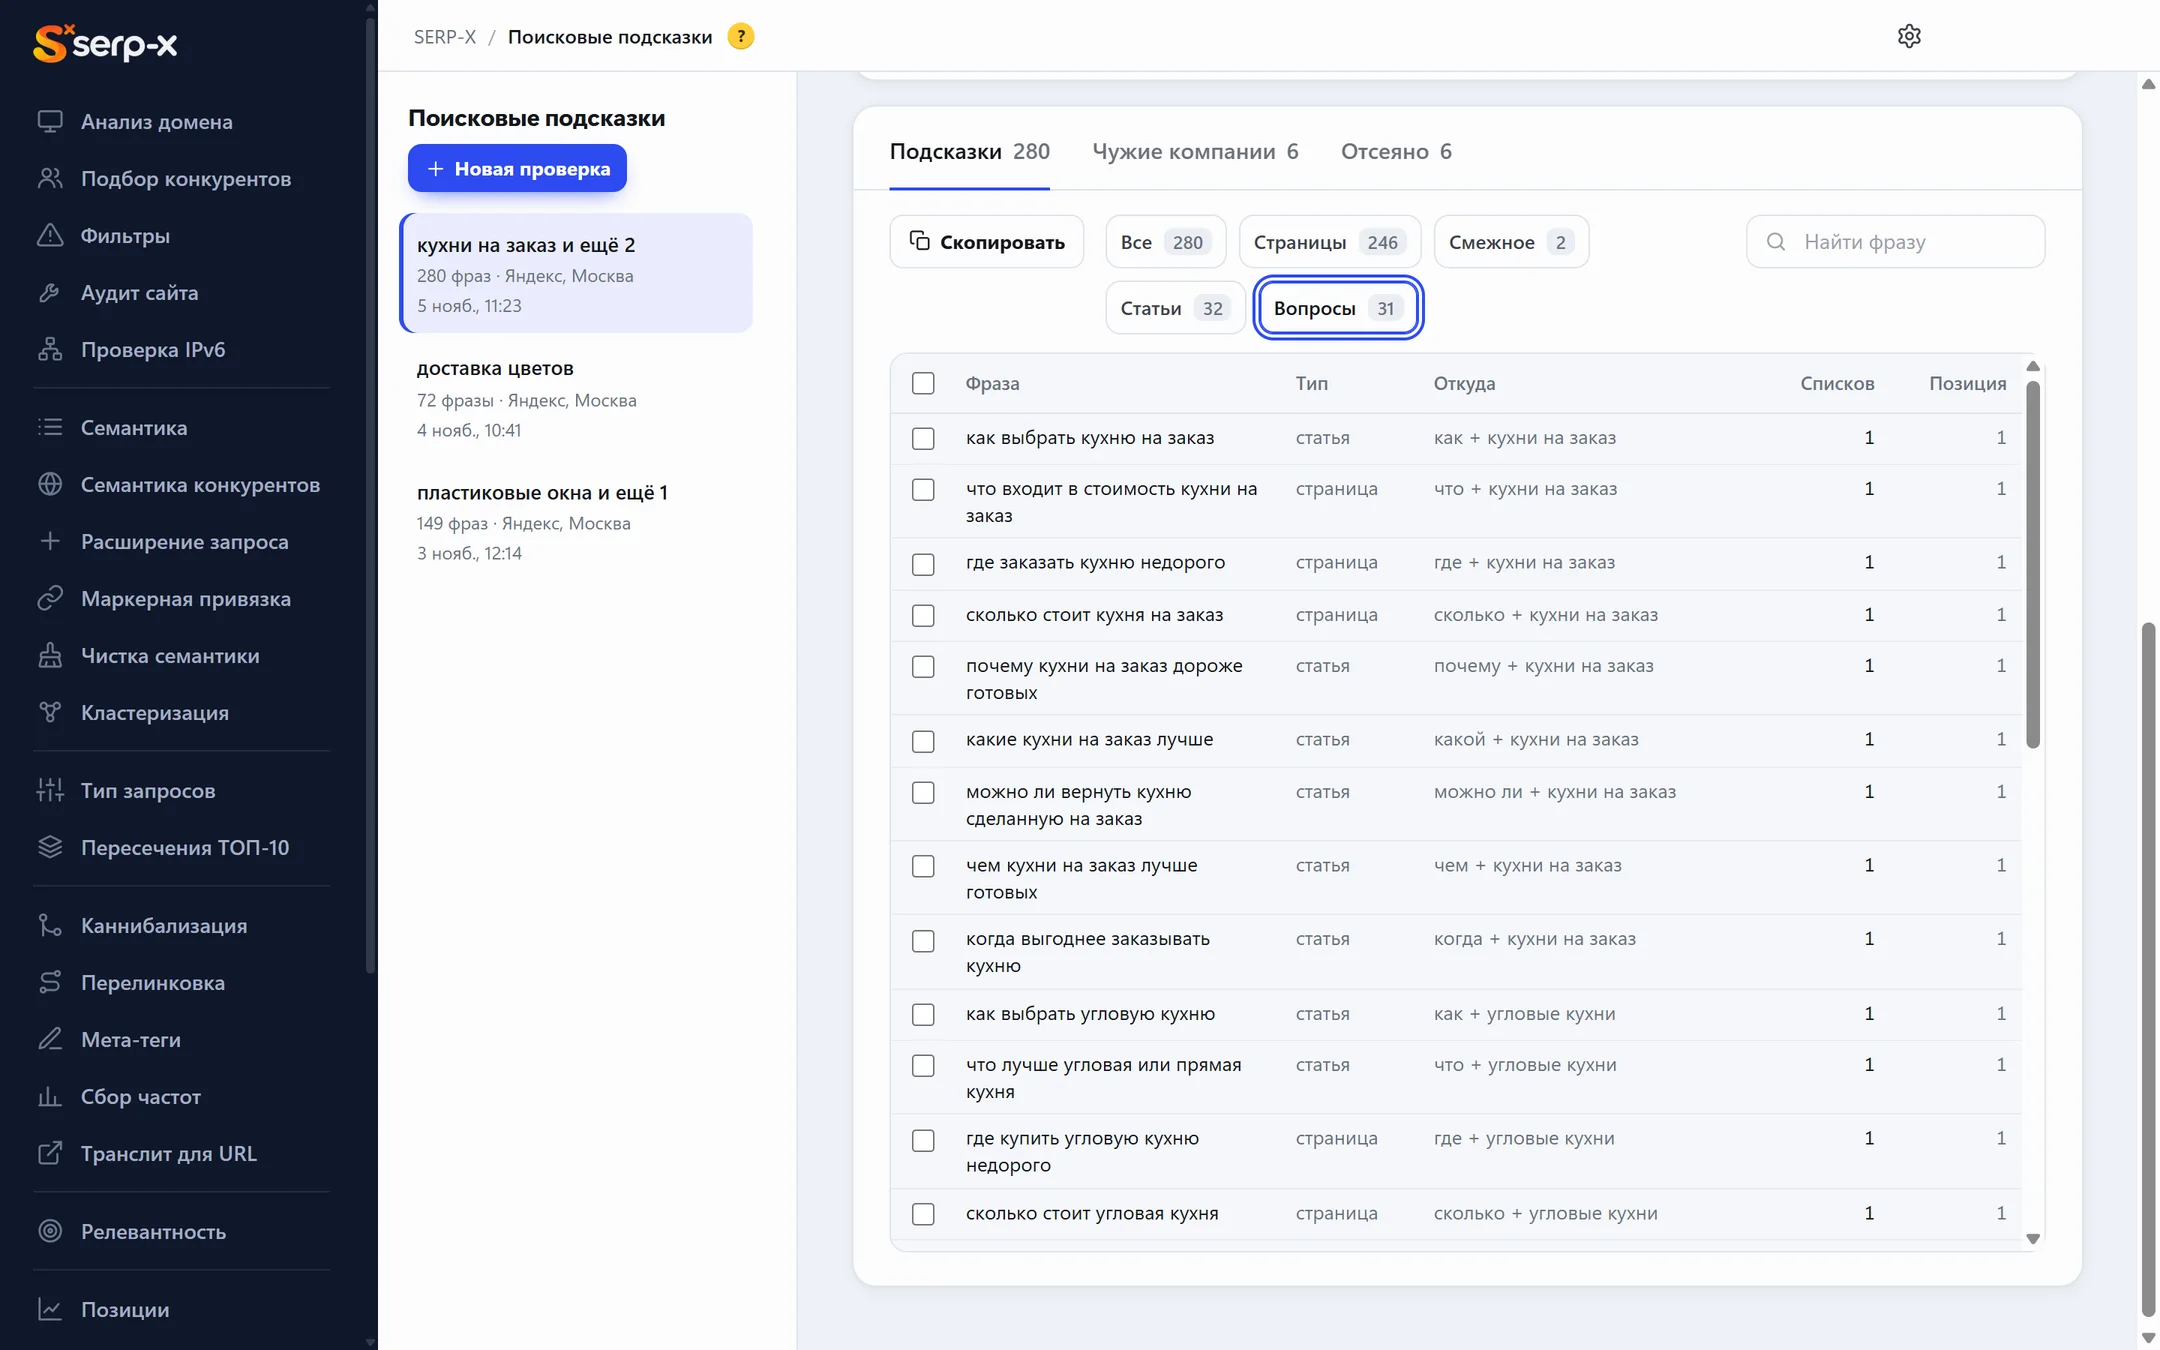
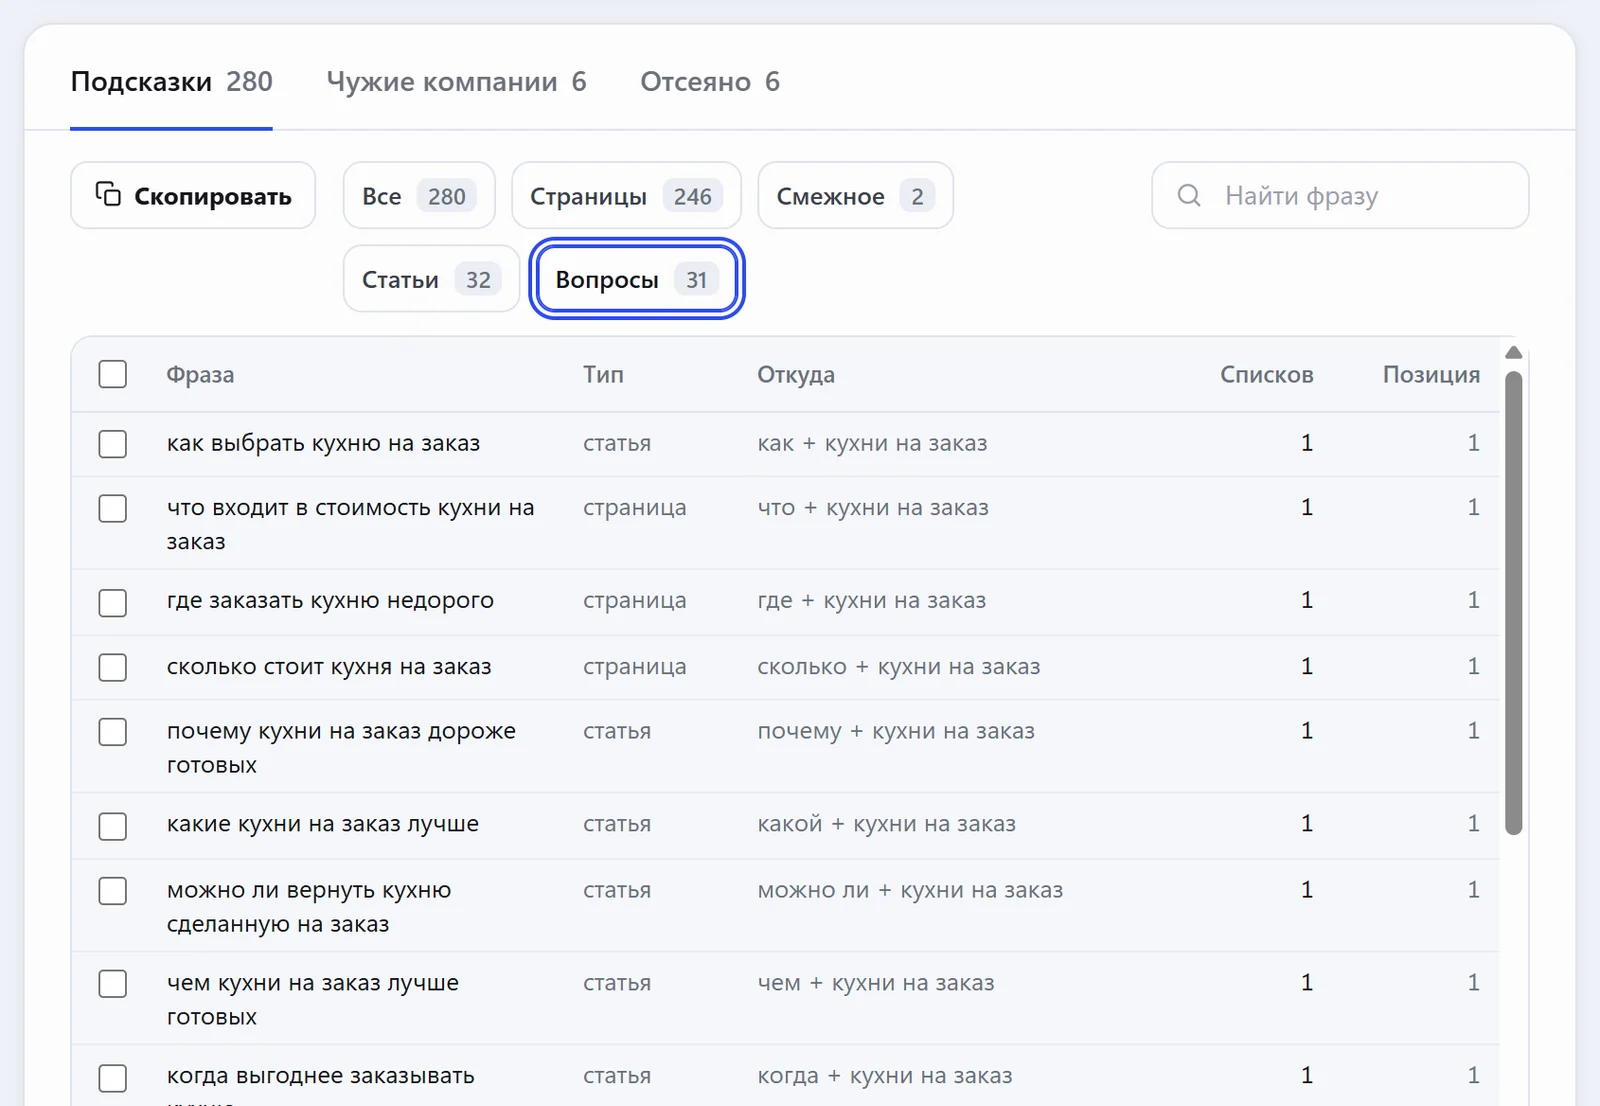
Отбор «Вопросы» - темы статей блога; у каждого - тип по топу и откуда пришла подсказка.
- Запрос и что перебирали
- Списком - в контент-план
- Скопировать
Коммерческие хвосты
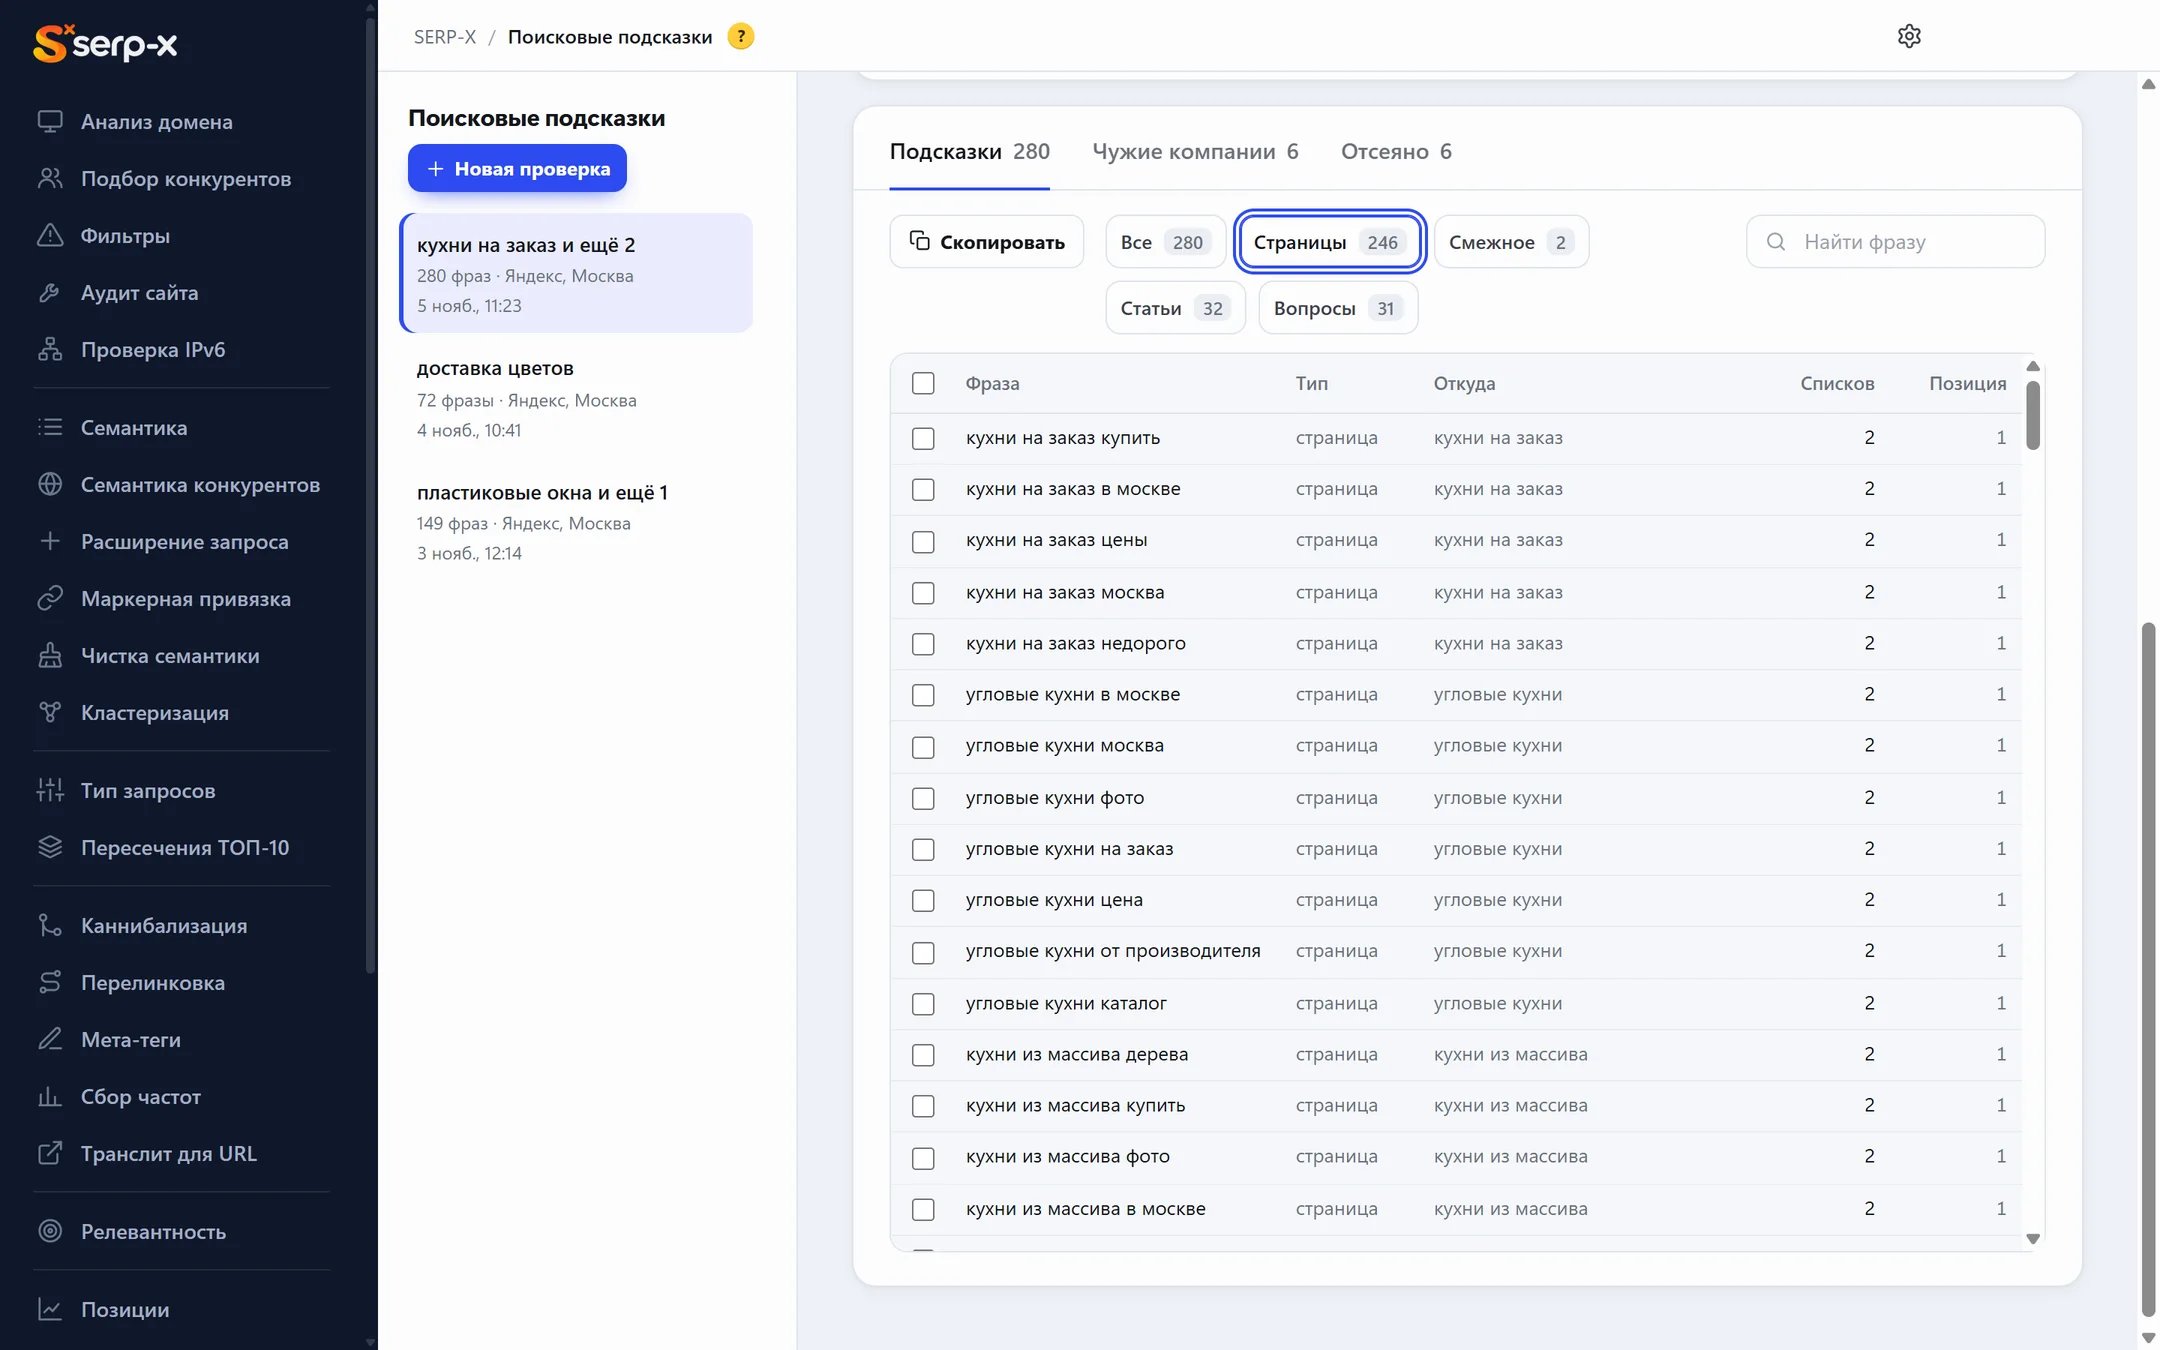
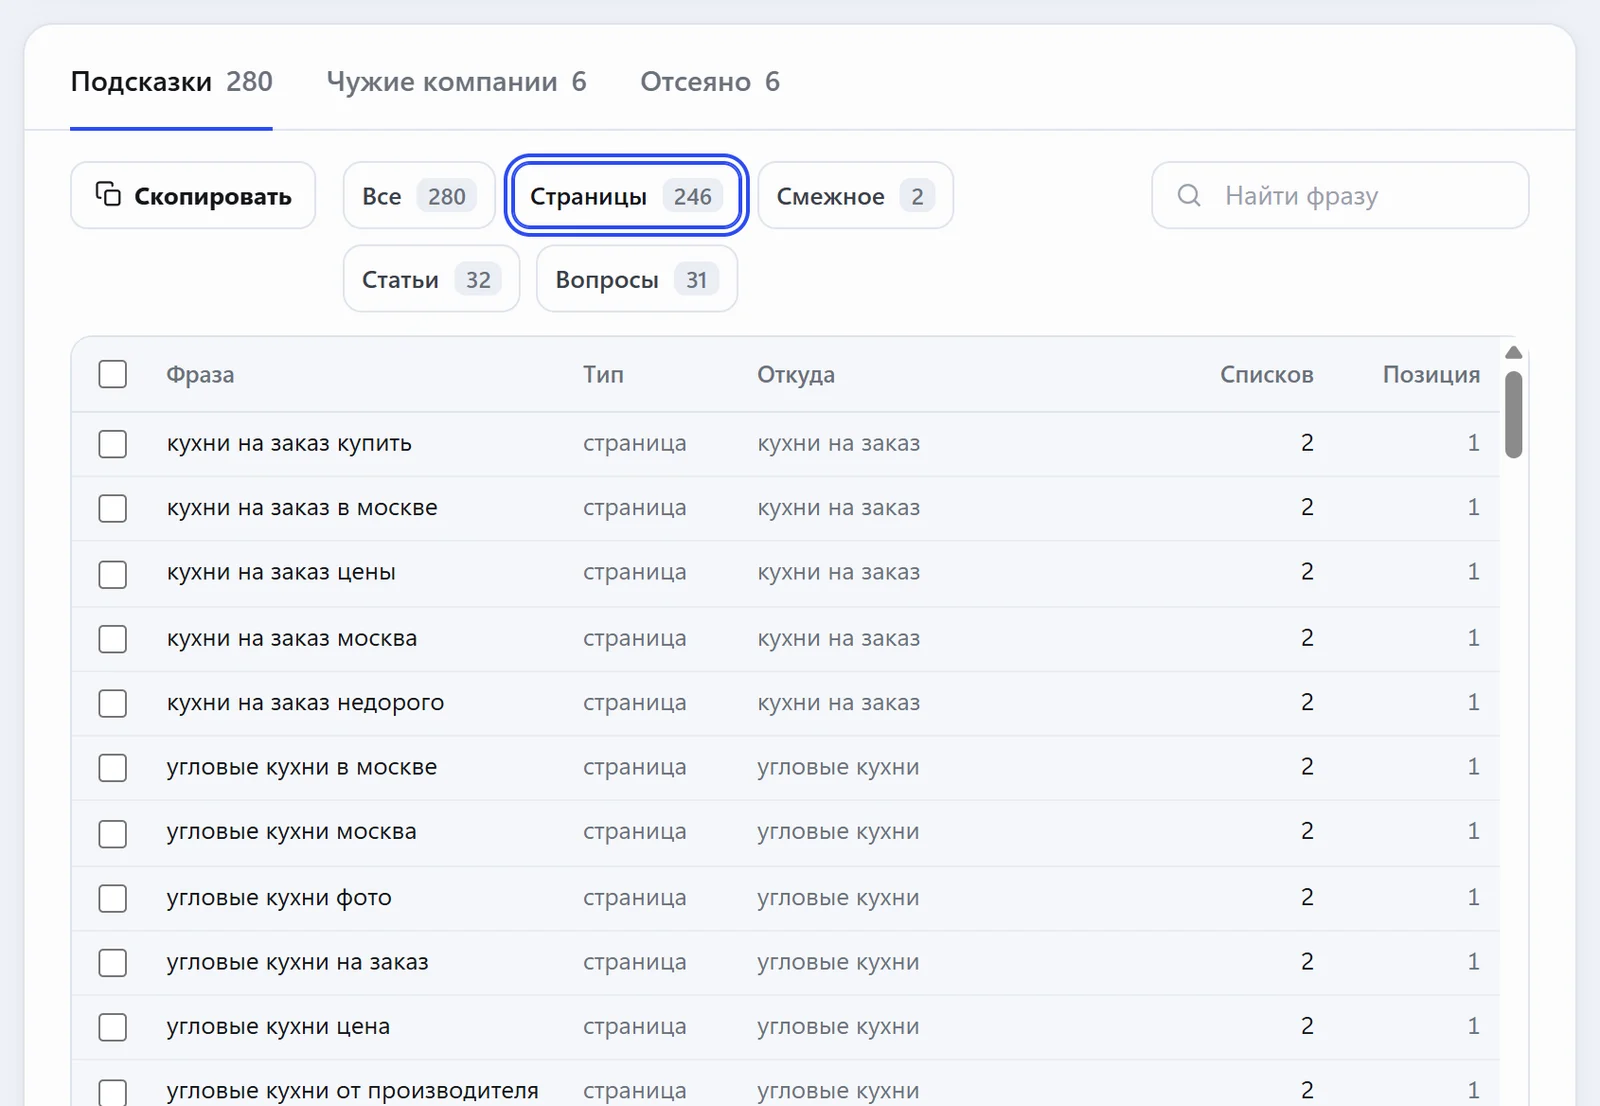
Подсказки, по которым в топе магазины и компании, - отбор «Страницы»: в ядро и в «Сбор частот».
- Тип - по топу Яндекса
- Чужие компании - вкладкой
- Excel
Преимущества
Почему удобно собирать подсказки в SERP-X
Яндекс и Google
Оба поисковика - в одном инструменте.
Перебор
Буквы, цифры и вопросы - сотни подсказок без ручного набора.
Вопросы отдельно
Готовые заголовки для блога - одним отбором.
Чистка
Минус-слова, мусор и топонимы - правилами, «не для этого сайта» - по топу Яндекса.
Частоты
«Собрать частоты» - подсказки уходят в Wordstat одной кнопкой.
Бесплатный сбор
Подсказки собираются без платных сервисов; решение по топу - копейки нейросети.
Подробно
Как работает парсер поисковых подсказок
Поисковые подсказки - варианты продолжения, которые Яндекс и Google показывают под поисковой строкой, пока человек вводит фразу. Парсер поисковых подсказок собирает их автоматически: вводит заданные фразы вместо человека, перебирает буквы и вопросительные слова и сохраняет результат списком. Так быстро находятся реальные формулировки пользователей, которых часто нет в базах ключевых слов.
Откуда берутся подсказки
Поисковые системы строят их по истории поиска: показывают популярные и растущие запросы, которые начинаются с введённых слов. Учитываются регион, язык, устройство и свежесть спроса, поэтому варианты на телефоне и на компьютере, в Москве и в Казани различаются. Новые формулировки появляются в подсказках раньше, чем в Вордстате, - так можно поймать спрос на старте.
Зачем SEO-специалисту парсинг подсказок
- Расширение семантического ядра. Подсказки дают низкочастотные хвосты: «купить диван угловой с ящиком», «диван для дачи недорого». Конкуренция по ним ниже, а конверсия часто выше.
- Вопросы для контента. «Как», «почему», «сколько», «можно ли» - готовые заголовки для блога, блоков FAQ и инструкций.
- Новые направления. Видно, что люди связывают с товаром или услугой: материалы, бренды, задачи, с которыми к вам приходят.
- Контекстная реклама. Из коммерческих хвостов получаются ключевые фразы для объявлений, из нецелевых вариантов - минус-слова.
Перебор букв, цифр и вопросов
Поисковая строка показывает до десяти подсказок на фразу. Чтобы получить больше, парсер добавляет к исходной фразе буквы алфавита («ремонт квартиры а», «ремонт квартиры б»), цифры и вопросительные слова («как ремонт квартиры», «сколько стоит ремонт квартиры»). Из каждого маркера так получаются десятки и сотни вариантов.
Некоторые парсеры повторяют сбор и для найденных хвостов - это называют глубиной парсинга. Вторая волна приносит ещё больше вариантов, но и больше мусора, поэтому без чистки результат быстро разрастается.
Регион, язык и устройство
Для локального бизнеса важно, в каком регионе собраны данные: жители Екатеринбурга и Краснодара продолжают одну и ту же фразу по-разному, а в подсказки попадают местные районы, бренды и магазины. Мобильные варианты короче и чаще содержат «рядом», «круглосуточно», «отзывы», поэтому для сайтов с мобильной аудиторией их стоит смотреть отдельно. Если сайт работает на нескольких языках, сбор повторяют для каждого.
Способы собрать подсказки
- Вручную. Вводить фразы в поисковую строку и копировать варианты. Подходит для пары маркеров, но не для больших объёмов.
- Через API или свой скрипт. Даёт гибкость, но требует навыков программирования и аккуратности с частотой обращений: при слишком частых запросах поисковик начинает показывать капчу.
- Программы и онлайн-сервисы. Key Collector и похожие решения собирают их вместе с другими данными, а специализированный парсер берёт на себя перебор, чистку и выгрузку в файл.
Как выбрать парсер подсказок
Стоит проверить, поддерживает ли он Яндекс и Google, мобильные подсказки, перебор букв и вопросов, минус-слова и фильтр чужих регионов. Удобно, когда результат сразу делится на коммерческие хвосты и вопросы, отсеянное видно с причиной, а частотность собирается без ручного копирования. Отдельно оцените стоимость: часть сервисов берёт плату за каждую фразу.
Что делать с собранными подсказками
- Убрать мусор: чужие регионы, бренды конкурентов, «скачать», «бесплатно», опечатки.
- Проверить спрос: подсказка не гарантирует частоту, поэтому фразы стоит прогнать через Вордстат.
- Разделить коммерческие хвосты и вопросы: первые - в семантическое ядро и на посадочные страницы, вторые - в контент-план.
- Сгруппировать фразы по выдаче, чтобы понять, какие продвигать вместе: здесь поможет кластеризация.
Как превратить вопросы в контент
Вопросы удобно группировать по смыслу: «как выбрать», «сколько стоит», «можно ли» часто ведут к одному материалу с несколькими разделами. Частые вопросы становятся заголовками H2 и H3, короткие - блоком FAQ на посадочной странице товара или услуги. До написания текста стоит посмотреть ТОП-10 по вопросу: если там магазины, нужен не текст в блог, а коммерческая страница с ответом на этот вопрос.
Подсказки Яндекса, Google и других площадок
У YouTube, маркетплейсов и магазинов приложений тоже есть свои подсказки: они полезны для видео, карточек товаров и описаний приложений. Для сайта главные источники - Яндекс и Google: их варианты отражают то, что люди ищут именно в поиске, и показывают разницу между аудиториями двух систем.
В SERP-X парсер поисковых подсказок принимает фразы по одной в строке. Вы выбираете Яндекс или Google (у Яндекса есть и мобильные подсказки) и что перебирать: буквы, цифры по желанию и вопросы «как», «что», «где», «сколько», «почему», «можно ли»; задаёте минус-слова и чистку. Дальше, как в «Семантике», подсказки собираются в группы по топу Яндекса, и о каждой группе решает нейросеть: страница сайта, смежное или статья; подсказки с названиями других компаний уходят на свою вкладку, «не для этого сайта» - в отсеянное с причиной. Итог показывает, сколько собрано подсказок и вопросов и что пойдёт в ядро, а что - в контент-план, рядом - вопросы по первому слову. Отбор «Вопросы» хранит, откуда пришла каждая подсказка. Топонимы убираются фильтром без нового сбора, кнопка «Собрать частоты» отправляет подсказки в сбор частот Wordstat, результат выгружается в Excel. Сами подсказки собираются без платных сервисов; для решения по топу нужны выдача (прокси или XML) и нейросеть, без них галочку можно снять - останется чистка правилами.
Вопросы
Частые вопросы
Что перебирается?
Запрос, запрос с буквами (и цифрами по желанию) и с вопросительными словами.
Яндекс или Google?
Любой - на выбор; у Яндекса - ещё мобильные подсказки.
Как убрать чужие города?
Фильтром топонимов - он меняет список без нового сбора.
Можно узнать частоты?
Да: «Собрать частоты» отправит подсказки в «Сбор частот».
Как отделить страницы от статей?
По топу Яндекса, как в «Семантике»: подсказки собираются в группы по общим сайтам ТОП-10, о каждой группе решает нейросеть - страница сайта, смежное или статья.
Что такое парсер поисковых подсказок?
Инструмент, который вводит фразы в поисковую строку вместо человека и сохраняет подсказки Яндекса или Google списком. Перебор букв и вопросов даёт сотни вариантов без ручного набора.
Зачем подсказки, если есть Вордстат?
Подсказки показывают свежие и разговорные формулировки, которых в Вордстате ещё нет или которые теряются среди частых фраз. Спрос по ним всё равно стоит проверить частотностью.
Подходят ли подсказки для контекстной рекламы?
Да: коммерческие хвосты становятся ключевыми фразами объявлений, а нецелевые подсказки - минус-словами для рекламных кампаний.
Ещё в разделе «Семантика»
Поисковые подсказки - в программе SERP-X
Все инструменты в одной программе для Windows. Начать можно бесплатно.