Чистка семантического ядра
Чистка семантического ядра убирает лишнее, которое всегда есть в собранном списке: площадки, чужие компании, другие города и темы. Как в «Семантике» - по топу Яндекса и нейросетью, а у отсеянной фразы видно, почему она ушла.
- Как в «Семантике»
- Группы по выдаче
- Правила - бесплатно
Как работает
Чистое ядро - без ручного просмотра
Вставьте фразы
Можно с частотами из Excel или «Кластер ⇥ Запрос» из «Маркерной привязки».
Опишите сайт
Тема, что продаёте и чего нет, город сайта; что оставить - страницы и статьи, только страницы или только статьи.
Получите чистые
Сначала правила, потом выдача: фразы со спросом - группами по топу Яндекса, о каждой группе решает нейросеть - страница, статья, чужая компания или не для сайта.
Что получите
Нецелевые запросы - с объяснением, а не молча
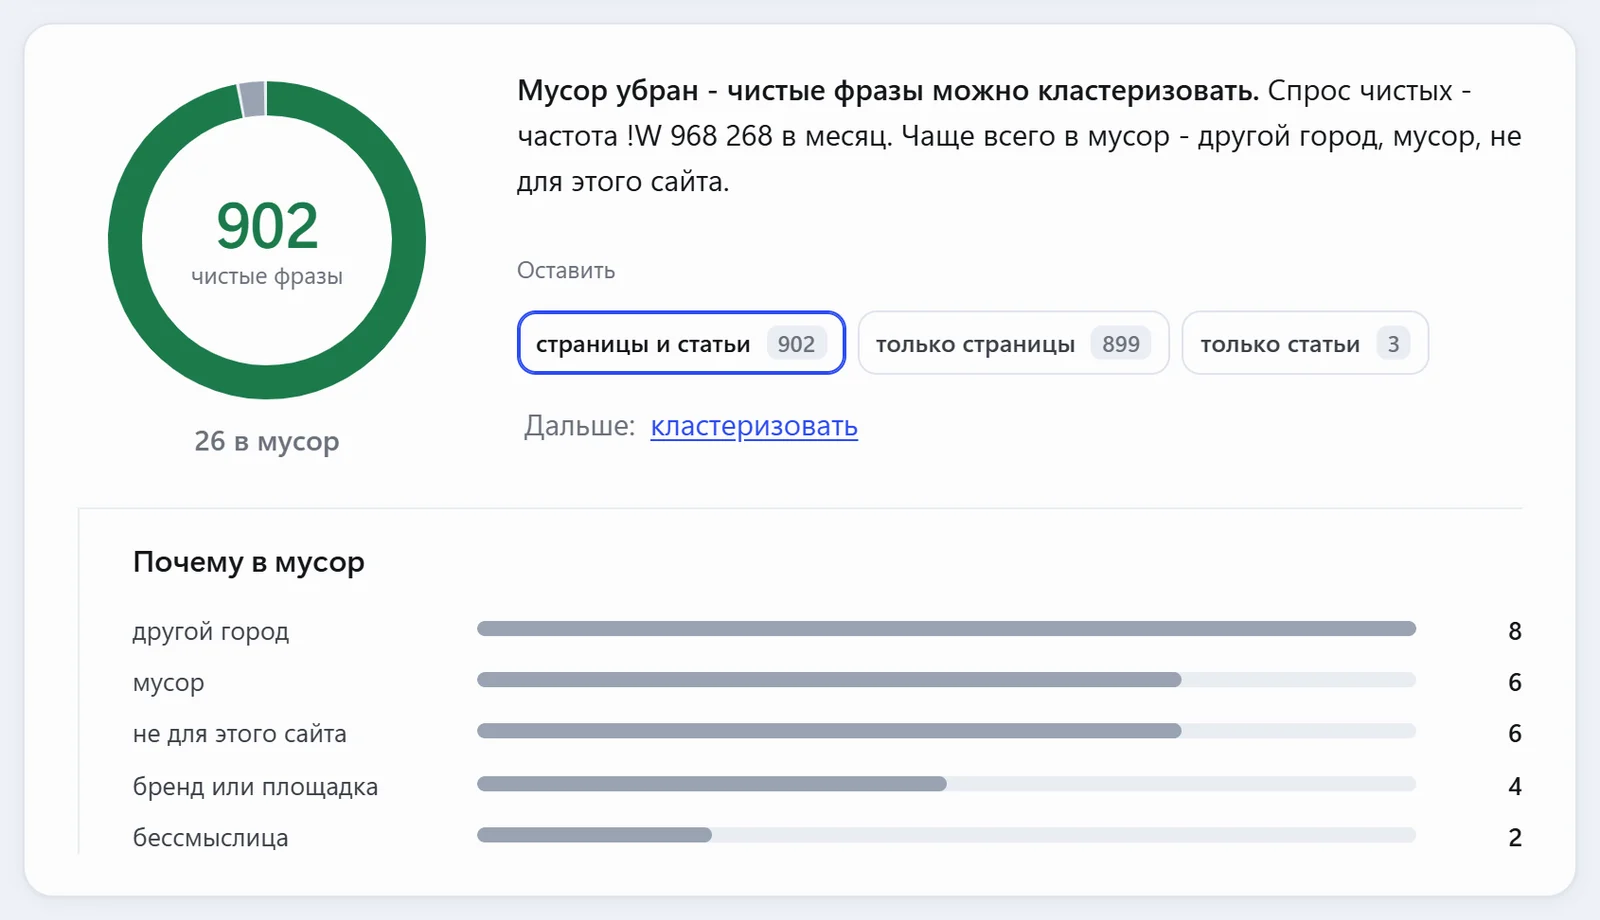
Итог
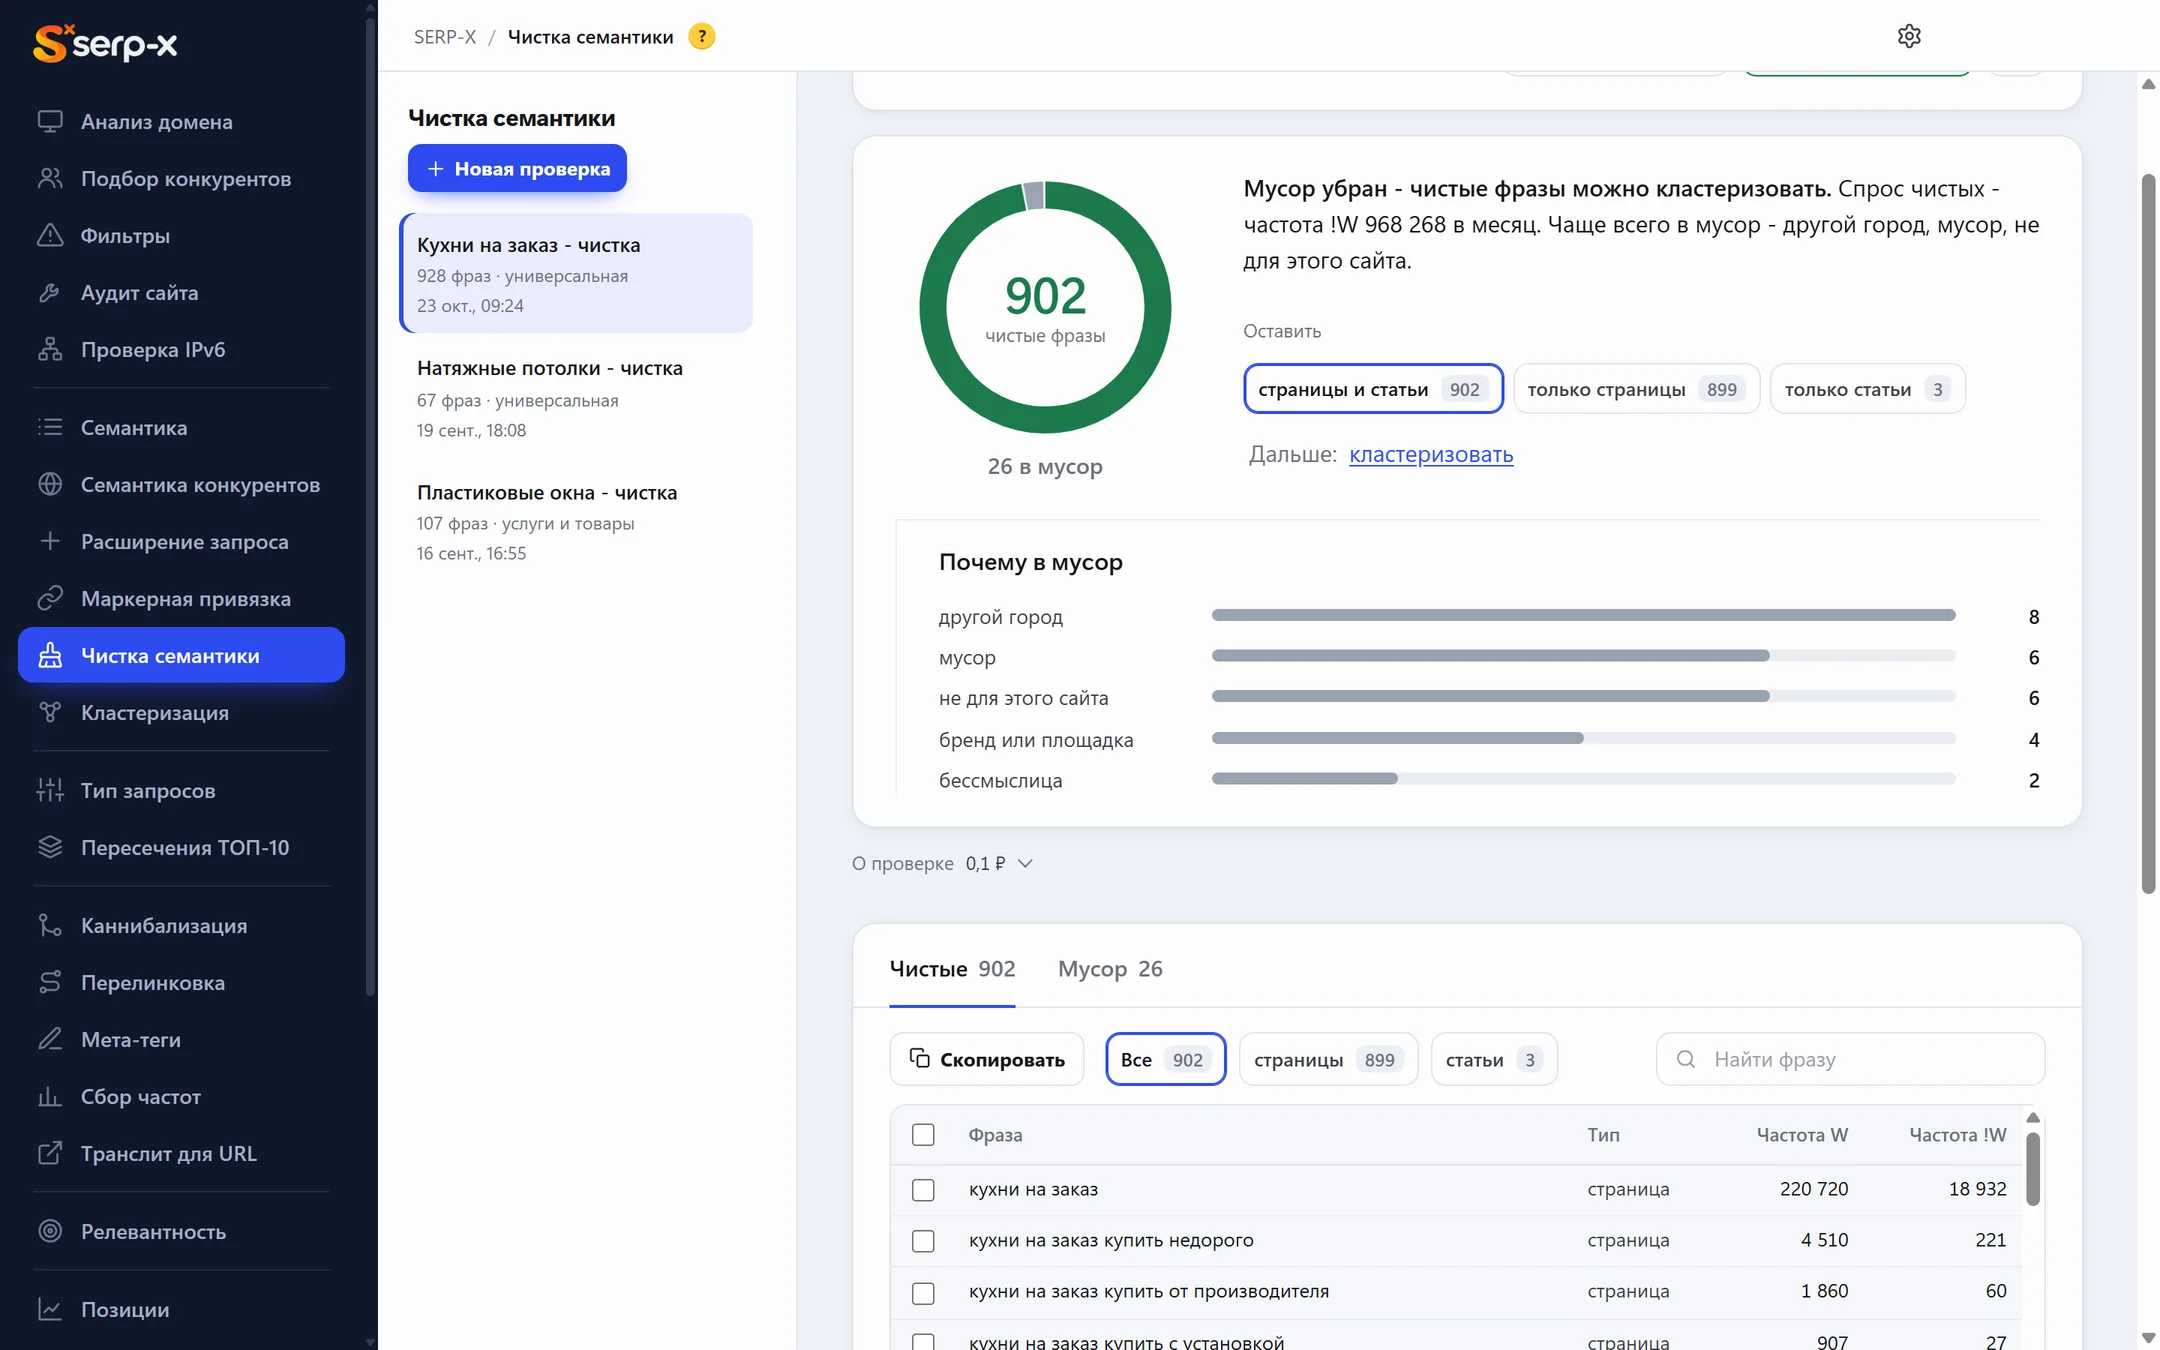
Сколько чистых и сколько в мусор, почему, и спрос чистых. «Оставить» - страницы и статьи, только страницы или только статьи: пересчёт сразу.
- «Оставить» - без новых запросов
- Причины мусора долями
- Дальше - кластеризовать
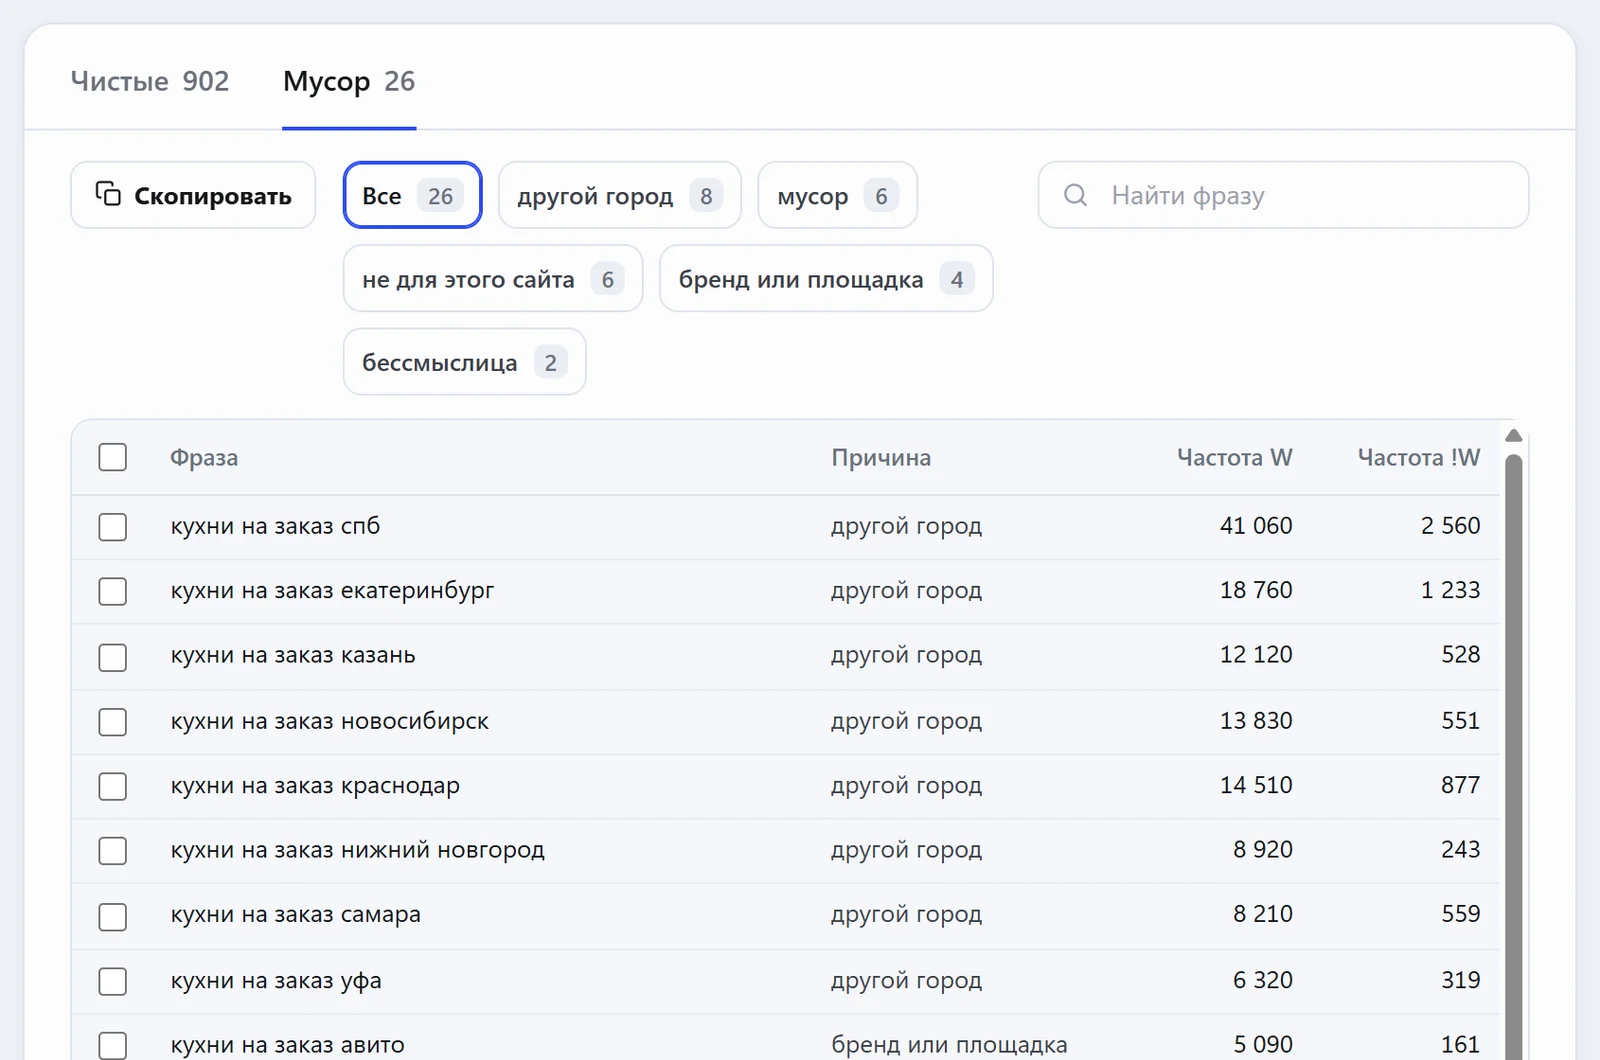
Мусор с причиной
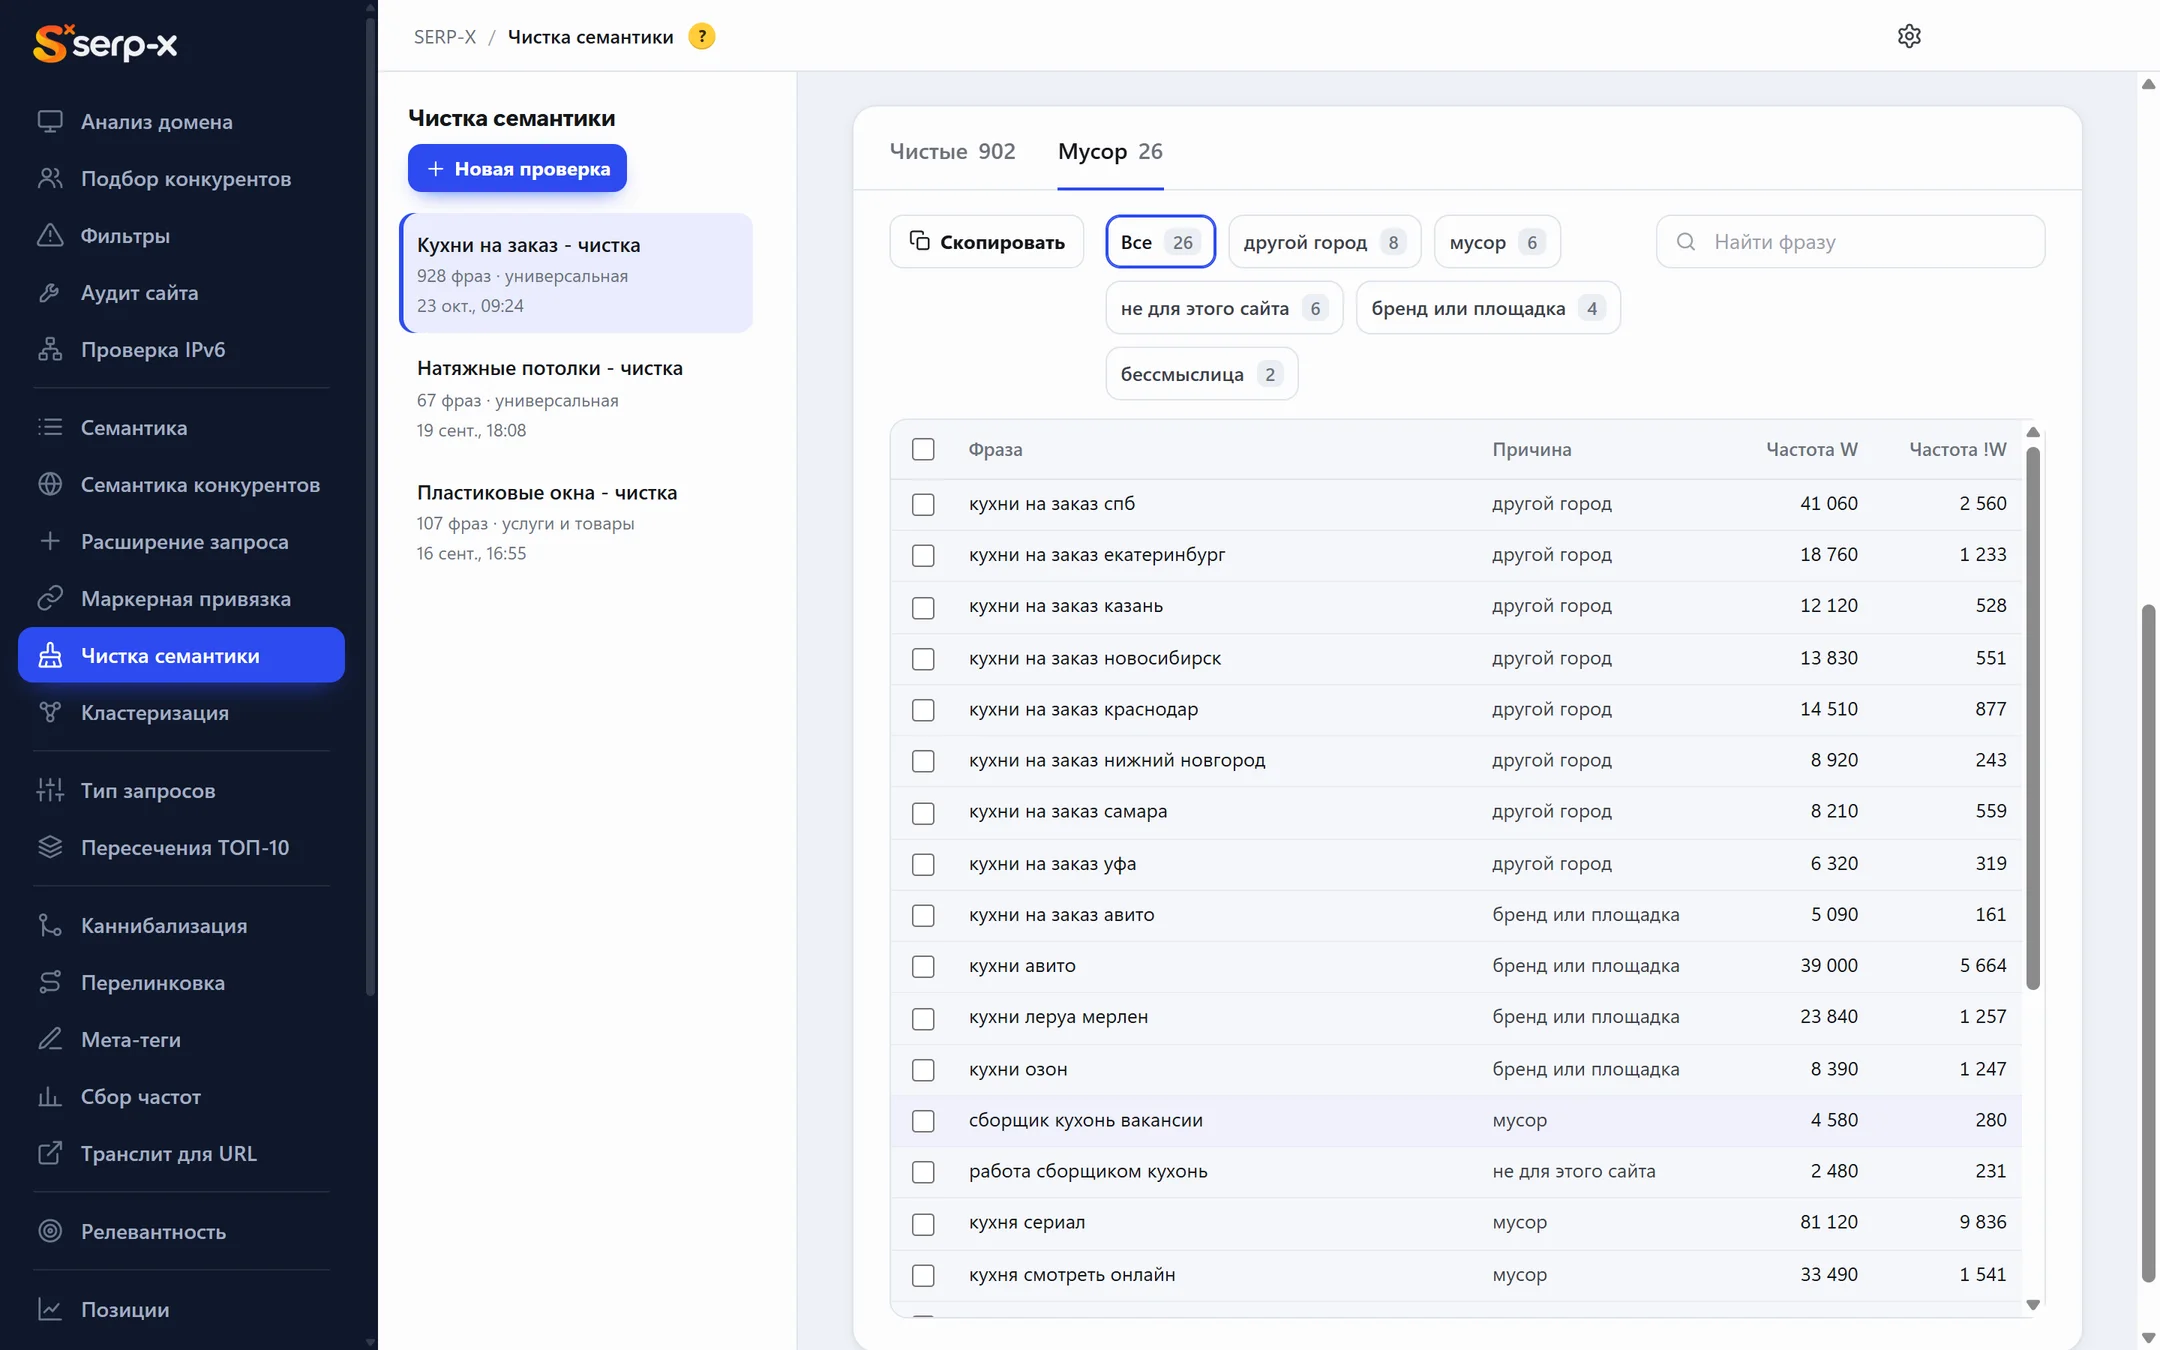
Не для этого сайта, чужая компания, другой город, площадка, обрывки - у фразы видна причина и её группа по топу Яндекса.
- Отбор по причине
- Вернуть фразу вручную
- Скопировать мусор
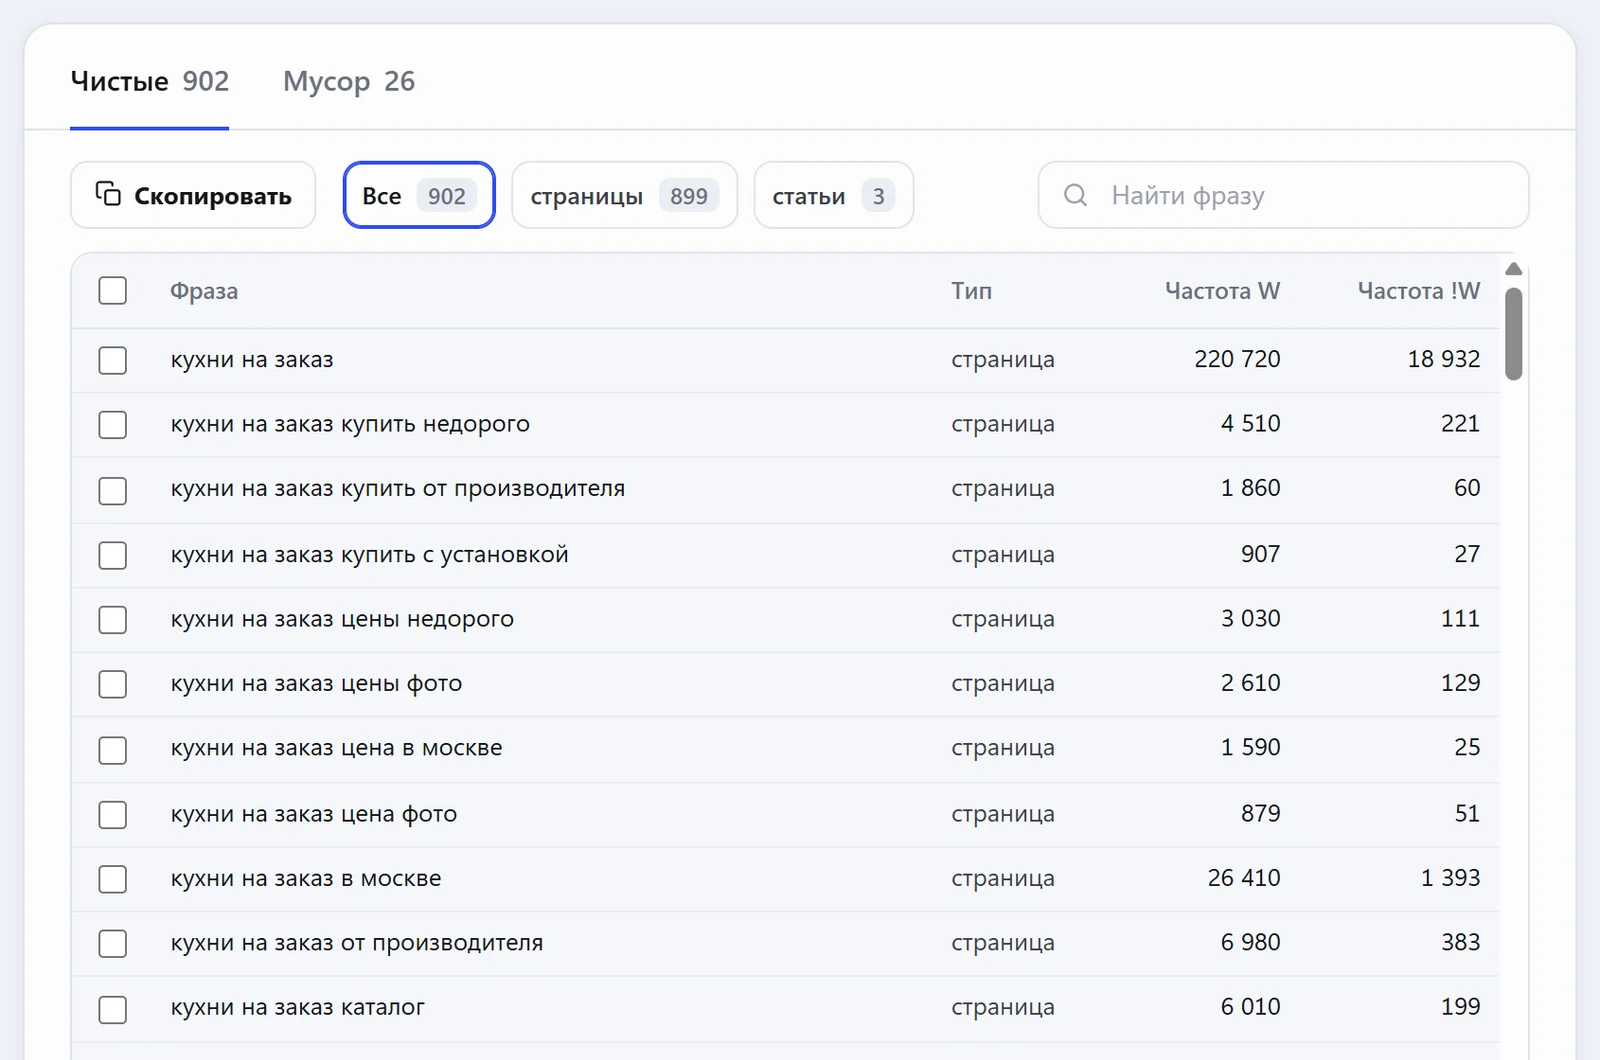
Чистые фразы
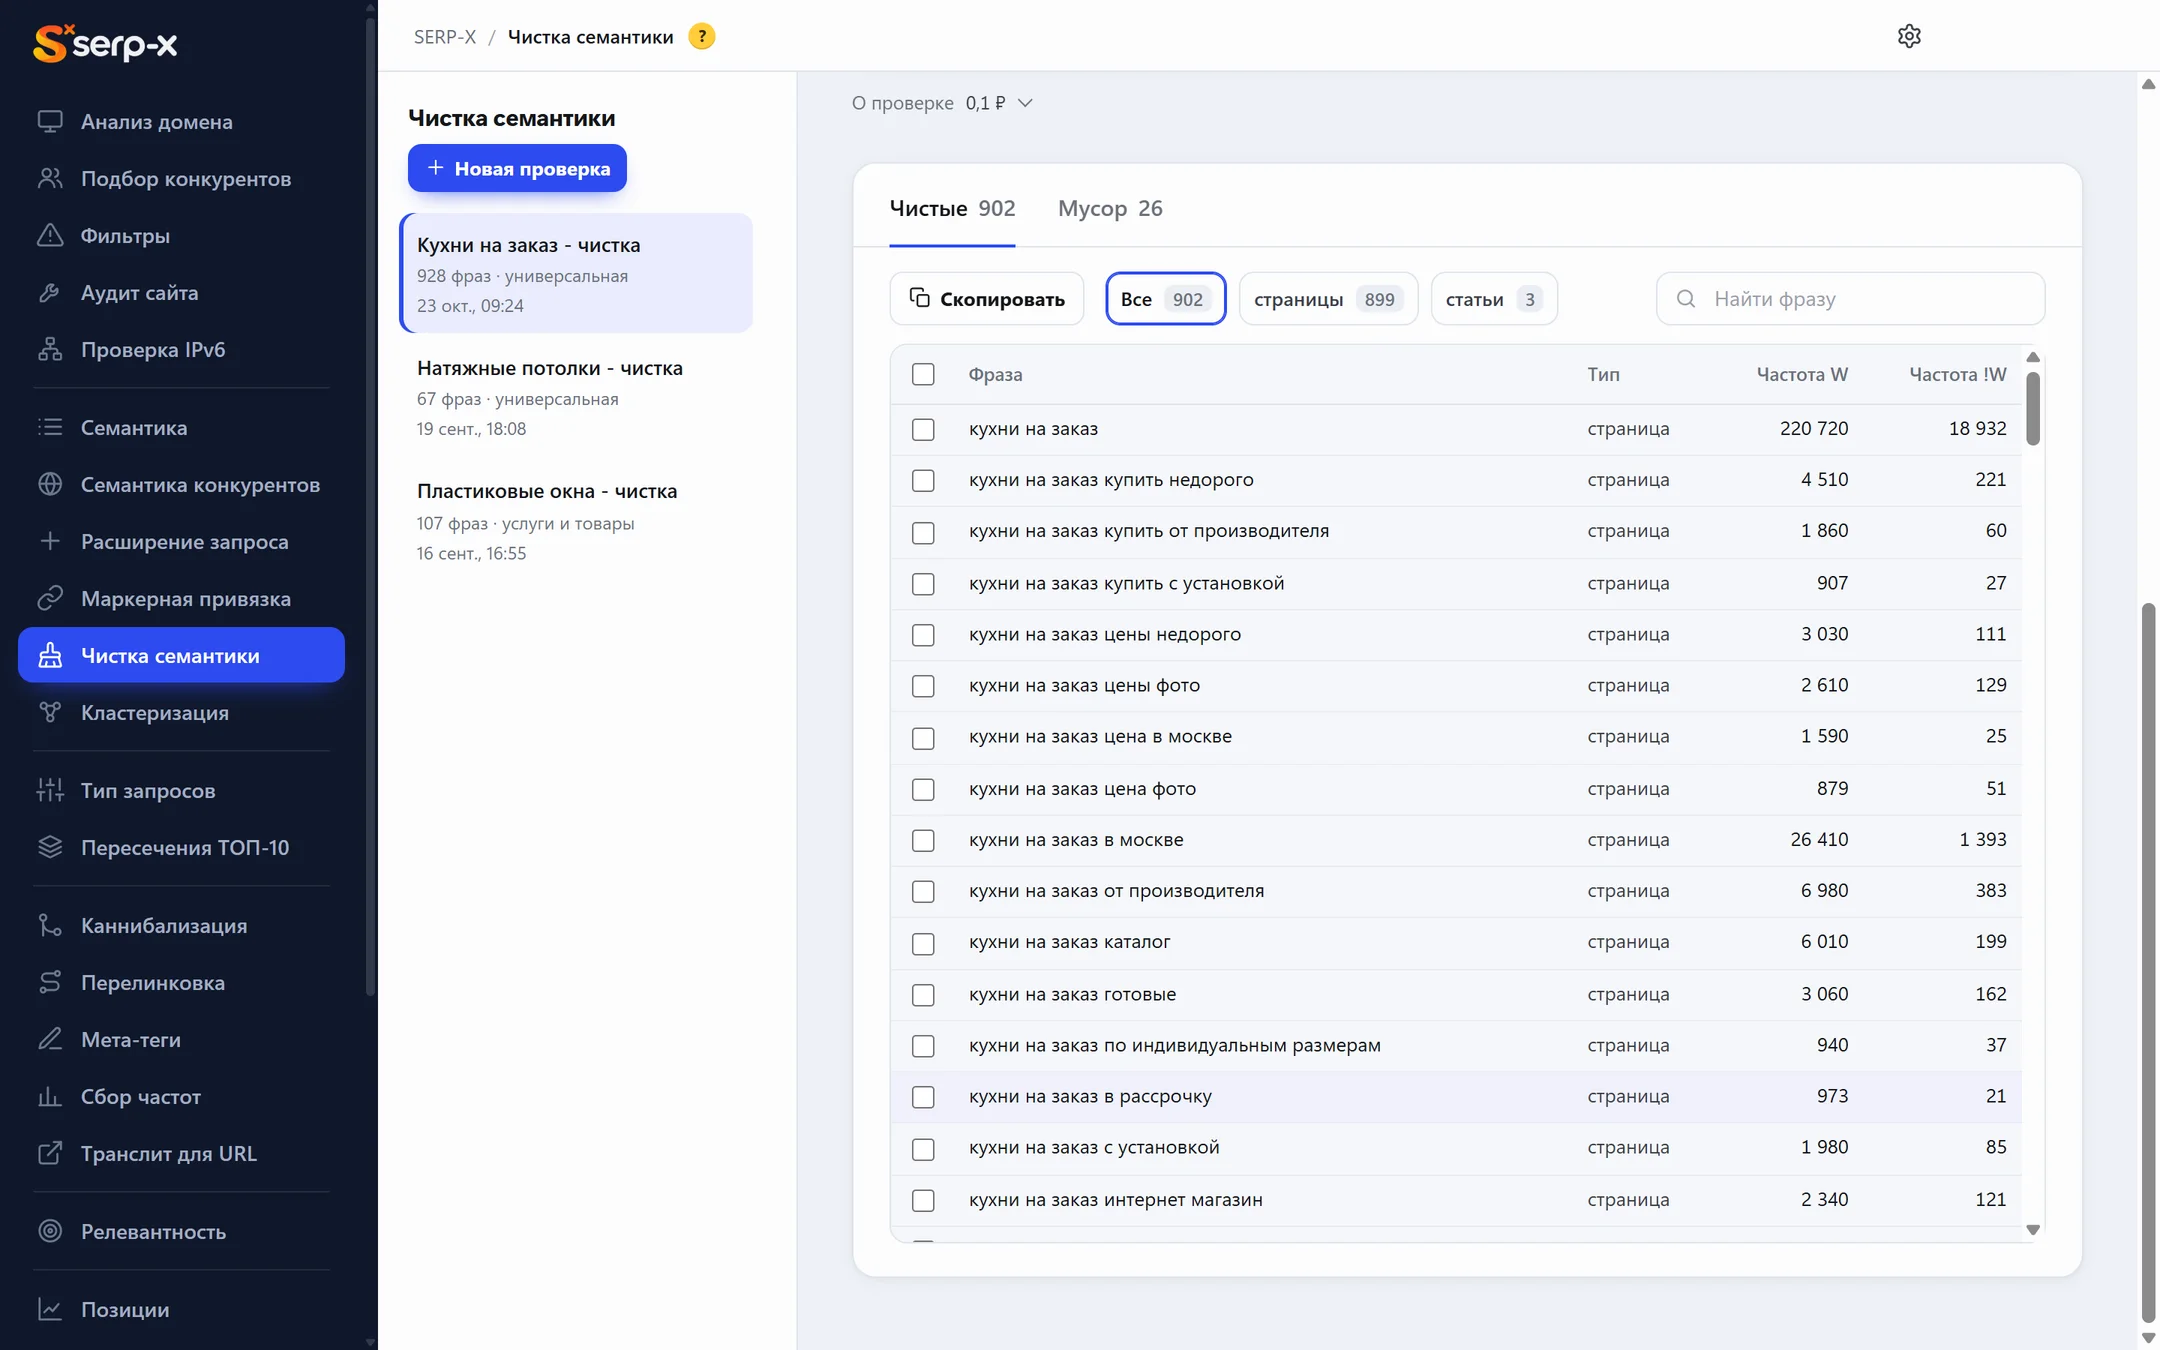
Что остаётся в ядре - страница или статья, с частотами.
- Убрать вручную
- Отбор: страницы и статьи
- Excel
Преимущества
Почему удобно чистить семантическое ядро в SERP-X
Смысл, а не стоп-слова
«Русская кухня» - другая тема для мебельного магазина, хотя слово то же.
Как в «Семантике»
Тот же алгоритм: правила, группы по топу Яндекса и решение нейросети о группе.
Причина у каждой фразы
Видно, почему фраза в мусоре, - легко вернуть нужное.
Дёшево
Сначала бесплатные правила, нейросеть - копейки за сотни групп.
Свой город
Фразы с чужими городами и регионами - в мусор, как в «Семантике».
Кластеры как есть
«Кластер ⇥ Запрос» - кластеры становятся разделами сайта, нейросеть их учитывает.
Подробно
Чистка семантического ядра: что убирать и как
Чистка семантического ядра - этап, на котором из собранного списка ключевых слов убирают всё, что не приведёт на сайт целевых посетителей: чужие бренды, другие регионы, запросы про работу и учёбу, фразы без спроса. После расширения в списке обычно тысячи ключевых фраз, и заметная их часть сайту не нужна. Если этот этап пропустить, нецелевые запросы попадут в структуру, тексты и рекламные кампании.
Ниже - зачем она нужна, какие запросы считать лишними, какие удалять не стоит, какие способы существуют и как проверить результат.
Зачем нужна очистка ядра
Семантическое ядро задаёт структуру сайта, тексты, мета-теги и перелинковку. Любой лишний ключ в нём превращается в работу: под него планируют страницу, пишут текст, ставят запрос на съём позиций. Трафик по нецелевым запросам не даёт заявок: пользователи уходят, не найдя того, что искали, и это портит поведенческие факторы, а продвижение по таким запросам съедает бюджет.
В контекстной рекламе цена ошибки ещё выше: нецелевые ключевые слова в рекламных кампаниях Яндекс Директа и Google Ads тратят деньги на клики, после которых ничего не покупают. Поэтому для рекламы отсеянные фразы не выбрасывают, а берут из них минус-слова.
Очистка среди этапов сбора семантического ядра
Сбор семантического ядра - процесс из нескольких этапов, и очистка - третий из них:
- Маркеры. Основные запросы тематики: что продаёт бизнес, какие услуги оказывает.
- Расширение и частотность. Подбор ключевых слов вокруг маркеров (поисковые подсказки, базы, запросы конкурентов) и сбор частотности по данным Вордстата для своего региона.
- Очистка. Удаление нерелевантных, пустых и дублирующих запросов.
- Кластеризация. Группировка ключевых фраз: запросы с общими сайтами в ТОП-10 продвигают одной страницей.
- Разбивка по страницам. Кластеры получают свои адреса в структуре сайта: категории, услуги, статьи блога.
Почистить список до кластеризации важно: иначе нецелевые запросы соберутся в собственные кластеры, и в структуре появятся страницы, которые сайту не нужны. Частотность лучше собрать заранее: по этим данным сразу видно пустые запросы.
Какие запросы убирать
- Пустые. Запросы с нулевой точной частотой (!W): базовая частотность набрана чужими хвостами, а сам запрос никто не вводит.
- Другие регионы. Пример: для магазина из Москвы «купить диван в Казани» - нецелевой запрос, хотя тематика та же.
- Чужие бренды и площадки. Названия конкурентов, маркетплейсов, досок объявлений («диван купить авито»): человек ищет конкретную площадку, а не товар.
- Не тот интент. «Скачать», «своими руками», «вакансии», «реферат» - если сайт продаёт услуги, такие запросы клиентов не приведут.
- Другой смысл слова. «Ягуар» - и автомобиль, и животное. Без проверки смысла такие ключевые слова попадают в ядро целыми группами.
- Дубли и обрывки. Одна и та же фраза с другим порядком слов, опечатки, оборванные хвосты из подсказок.
Что удалять не стоит
Ошибка в обратную сторону обходится дороже: лишний ключ можно удалить в любой момент, а потерянный спрос сам не вернётся. Поэтому спорные запросы лучше сохранить и решить по ним отдельно.
- Информационные запросы. «Как выбрать», «что лучше», «сколько служит» - это темы для статей блога. Их отделяют от коммерческих вроде «купить» и «заказать», а не удаляют.
- Низкочастотные. Запрос с точной частотой 5-10 в месяц приводит целевых посетителей, а продвинуть его проще, чем общий запрос.
- Смежные товары и услуги. Если бизнес может их добавить, такие ключи пригодятся при расширении структуры.
- Свой регион в разных формах. «Купить диван в Москве», «диваны Москва», «мск», районы и ближайшее Подмосковье - всё это целевые запросы.
Способы очистки: вручную, по стоп-словам, нейросетью
Существует три основных способа, и сервисы для работы с семантическим ядром обычно их сочетают.
Вручную в Excel. Ключевые слова собирают в таблицу, сортируют, отмечают нецелевые и удаляют. Для проекта на несколько сотен запросов это реально, но на десятках тысяч ключевых слов ручная очистка не масштабируется: уходят дни работы, а результат зависит от внимательности специалиста.
По стоп-словам. Списки минус-слов - города, бренды, «скачать», «реферат» - и фильтры Key Collector или других сервисов быстро убирают очевидное. Слабая сторона - контекст: слово «ремонт» для автосервиса целевое в запросе «ремонт подвески» и нецелевое в запросе «ремонт квартиры».
По ТОП-10 и с помощью нейросети. Запрос проверяют по результатам поиска Яндекса или Google: если в топе сайты другой тематики, он не ваш. Нейросеть читает запросы вместе с заголовками топа, то есть видит то же, что пользователь в поиске, и решает, нужны ли они сайту. Так очистка семантического ядра идёт быстро и точно даже на больших проектах. Задача специалиста - правильно описать сайт (что продаёт, чего нет, в каком регионе работает) и разобрать спорные случаи.
Как проверить результат
- Просмотрите отсеянное: нет ли там своих услуг, своего региона и информационных запросов, нужных блогу.
- Сравните количество запросов и спрос до и после: если ушла большая часть суммарной частоты, какое-то стоп-слово сработало слишком широко.
- Откройте поиск по нескольким частотным запросам из итогового списка: в ТОП-10 должны стоять сайты вашей тематики.
- Убедитесь, что не осталось дублей и фраз с нулевой точной частотой.
Готовое семантическое ядро после очистки - это список целевых ключевых запросов с частотностью и типом: коммерческие уходят на страницы каталога и услуг, информационные - в статьи. Дальше его раскладывают по страницам с помощью кластеризации.
В SERP-X чистка семантического ядра идёт тем же алгоритмом, что в «Семантике». Сначала словари убирают очевидное: площадки, бренды, топонимы. Затем фразы со спросом (!W от 1) складываются в группы по топу Яндекса - по одной на словоформу, и нейросеть решает о группе целиком по её фразам и заголовкам топа: страница, статья, чужая компания или не для этого сайта. На выходе - целевые ключевые слова с частотами и типом, отсеянные с объяснением и выгрузка в Excel; любой запрос можно вернуть вручную. Если частот в списке нет, их удобно снять заранее в сборе частот.
Вопросы
Частые вопросы
Можно чистить без нейросети?
Да: «Только правила» - бесплатно и сразу: словари мусора, площадки, бренды, топонимы.
Как решается, что мусор?
Фразы со спросом снимаются в выдаче Яндекса и складываются в группы, как в «Семантике»; нейросеть смотрит на всю группу и заголовки топа. Прежний способ - оценка каждой фразы от 0 до 100 - остался в настройках.
Можно вернуть фразу из мусора?
Да, вручную - в один щелчок.
Сколько стоит?
Нейросеть - копейки за сотни групп, выдача - запросы к Яндексу через ваши прокси; правила - бесплатно.
Что такое чистка семантического ядра?
Удаление из списка ключевых слов нецелевых, пустых и дублирующих запросов: чужих брендов, других регионов, слов с другим смыслом. После неё в ядре остаются запросы, которые приводят клиентов и читателей.
Когда проводить чистку ядра?
После расширения списка и сбора частотности, до кластеризации. Повторять - при любом обновлении ядра и перед запуском новых рекламных кампаний.
Удалять ли информационные запросы?
Нет, если на сайте есть или планируется блог: «как выбрать» и «что лучше» - темы для статей. В SERP-X выбор «только страницы», «только статьи» или оба типа пересчитывает итог сразу.
Чистить ядро для SEO и для Директа - одно и то же?
Нет. Для SEO нецелевые запросы убирают, а информационные отдают статьям. Для контекстной рекламы отсеянное становится минус-словами, чтобы объявления не показывались по таким запросам.
Ещё в разделе «Семантика»
Чистка семантики - в программе SERP-X
Все инструменты в одной программе для Windows. Начать можно бесплатно.