Проверка robots.txt
Проверка robots.txt: не запретил ли файл нужные страницы, какие из них открыты для Яндекса и Google и какое правило решает. Черновик файла можно проверить до выкладки на сайт.
- Яндекс и Google отдельно
- Свой черновик robots.txt
- До 1 000 адресов из карты
Как работает
Какое правило закрывает страницу - видно сразу
Впишите сайт
И URL или пути; пусто - программа возьмёт до 1 000 страниц из sitemap.xml.
Проверьте черновик
Вставьте новый robots.txt - страницы проверятся по нему, а не по файлу на сайте.
Смотрите итог
Сколько закрыто, расходятся ли Яндекс и Google, есть ли ошибки в файле.
Что получите
Закрыто ли нужное - и кто закрыл
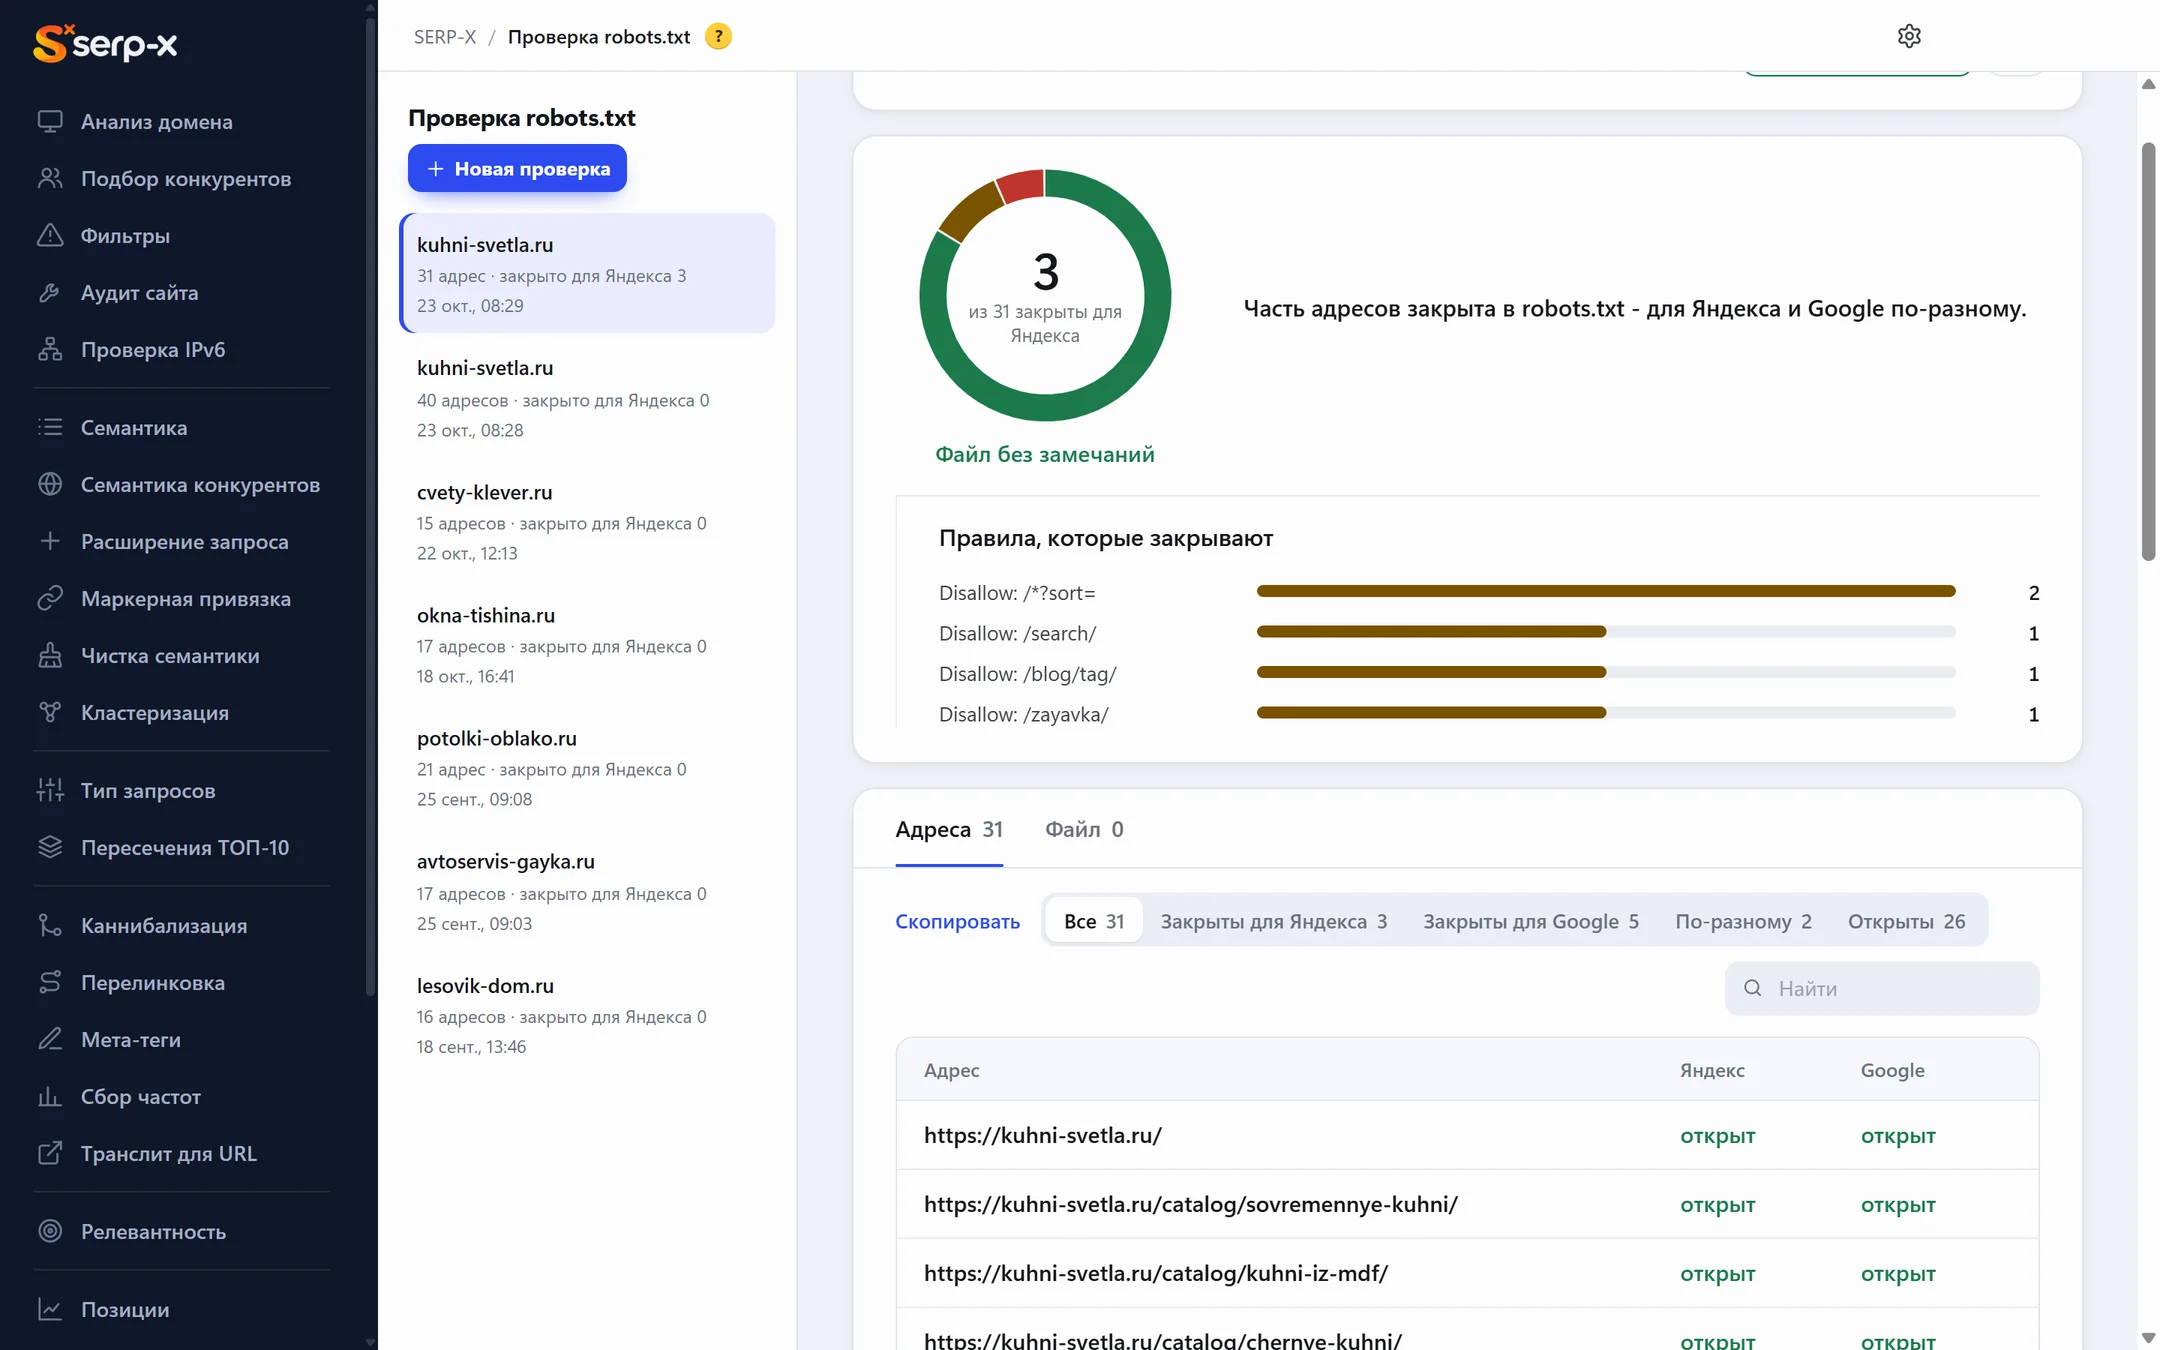
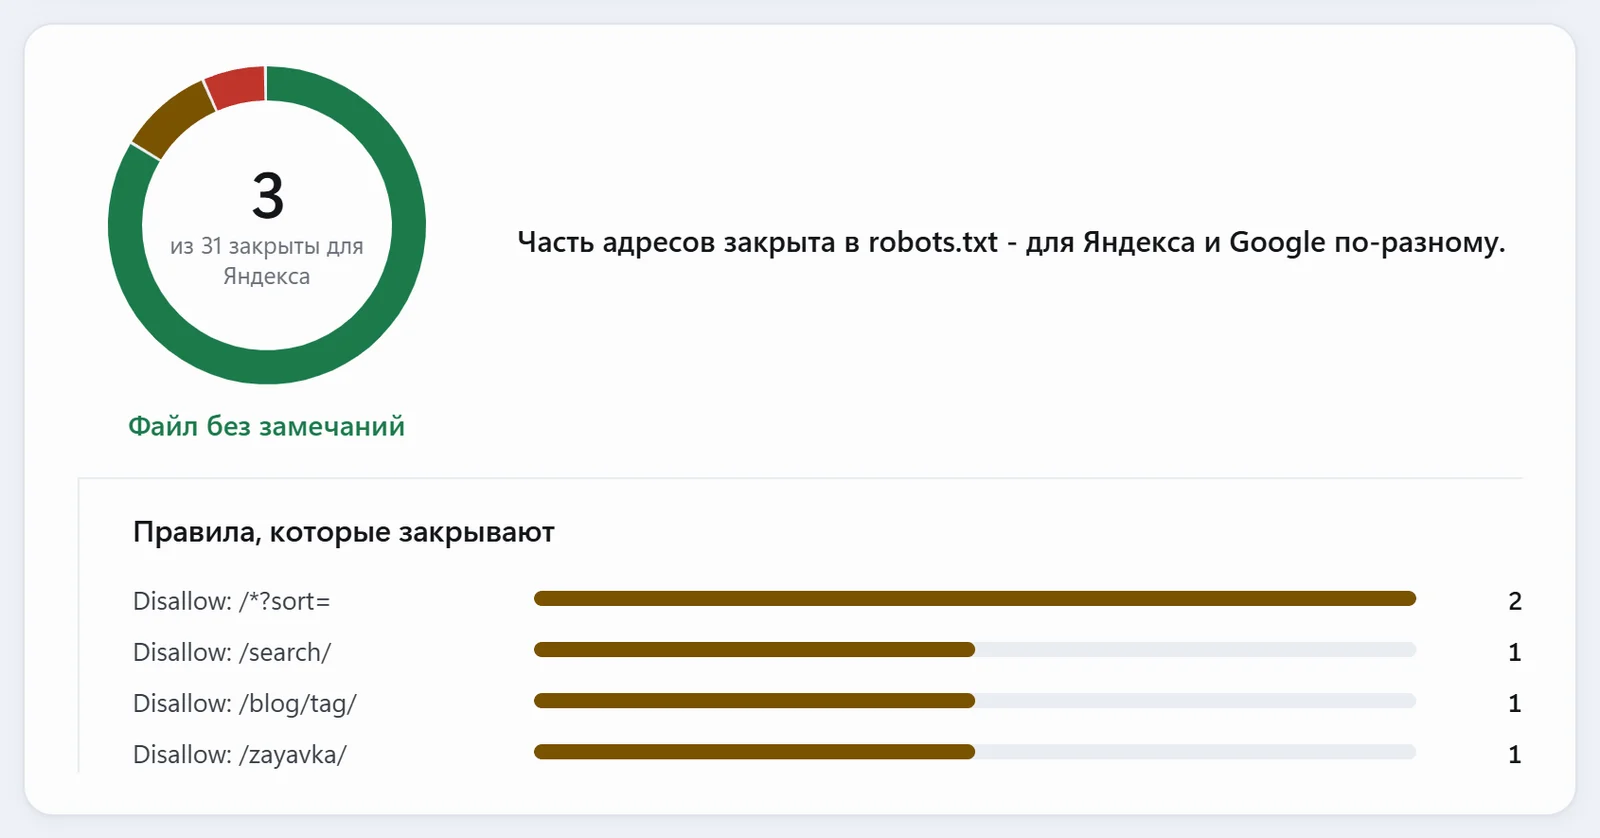
Итог и правила
Кольцо закрытых адресов и вывод. Справа - правила файла и сколько адресов закрывает каждое.
- Disallow по числу закрытых
- Ошибки в самом файле
- Clean-param для Яндекса
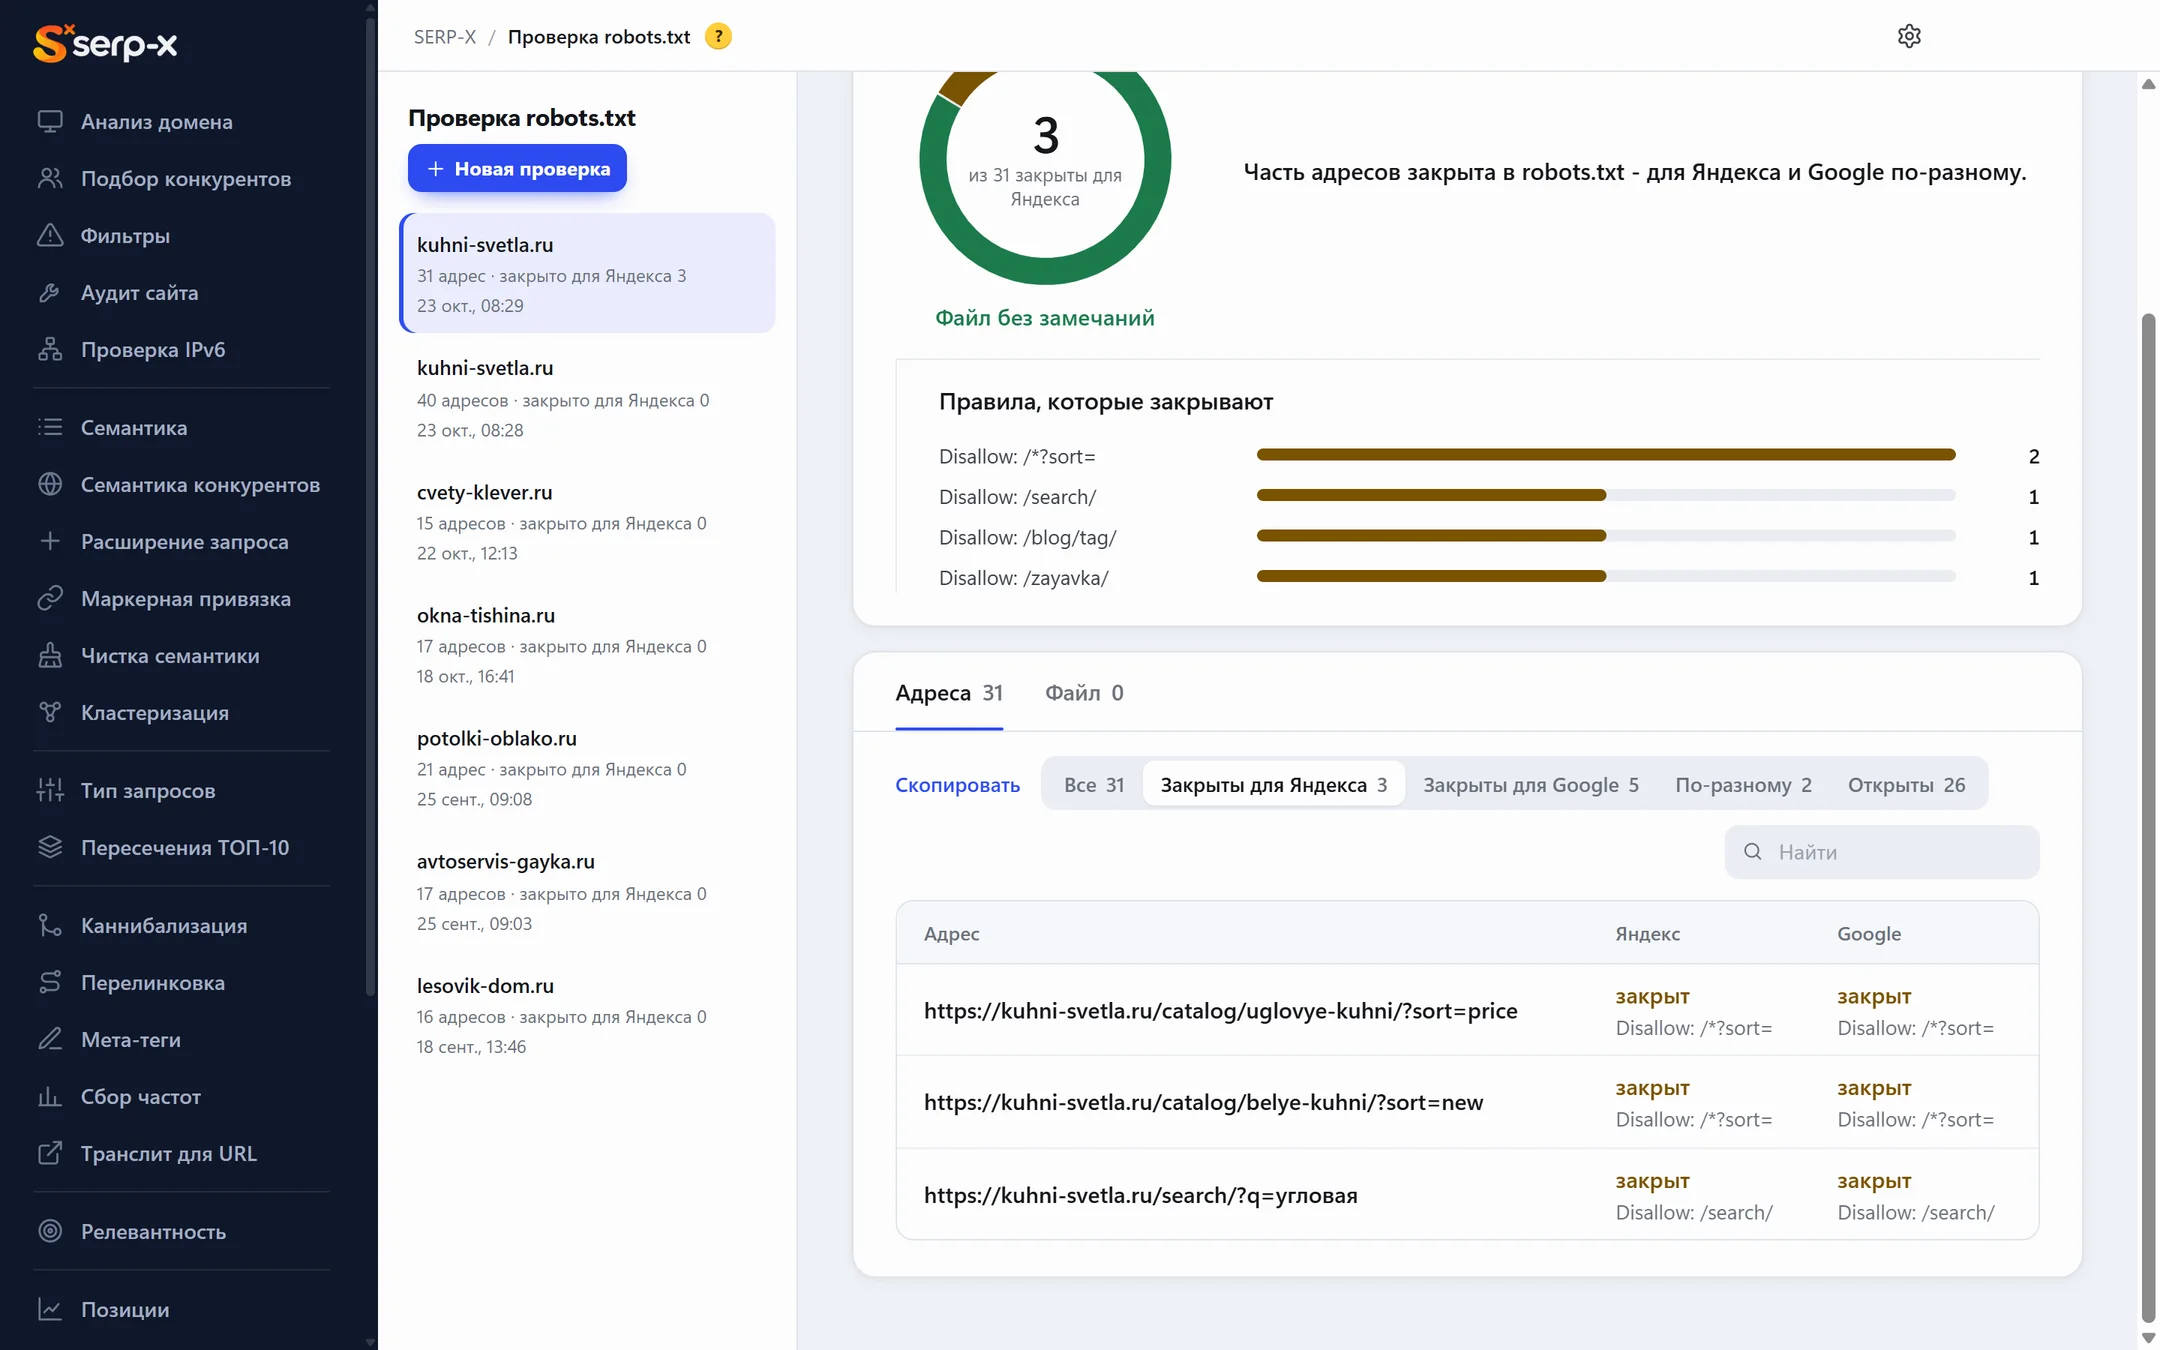
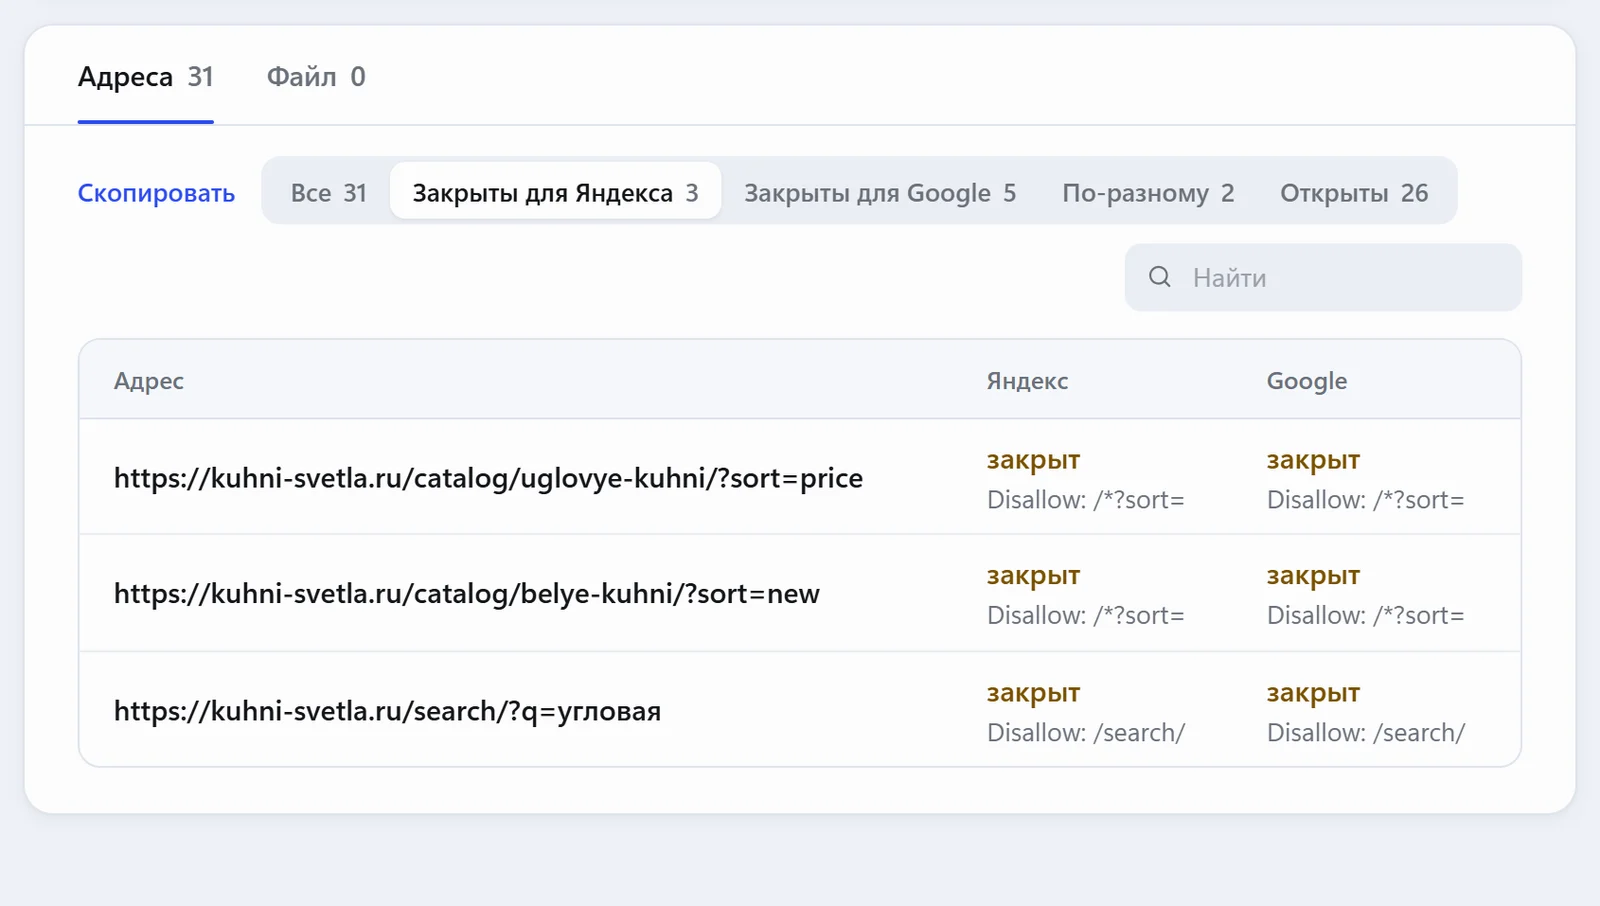
Закрыто для Яндекса
Отбор показывает адреса, которые Яндекс не будет индексировать, и правило, из-за которого.
- Правило в каждой строке
- Сортировка с параметрами и служебные страницы
- Скопировать списком
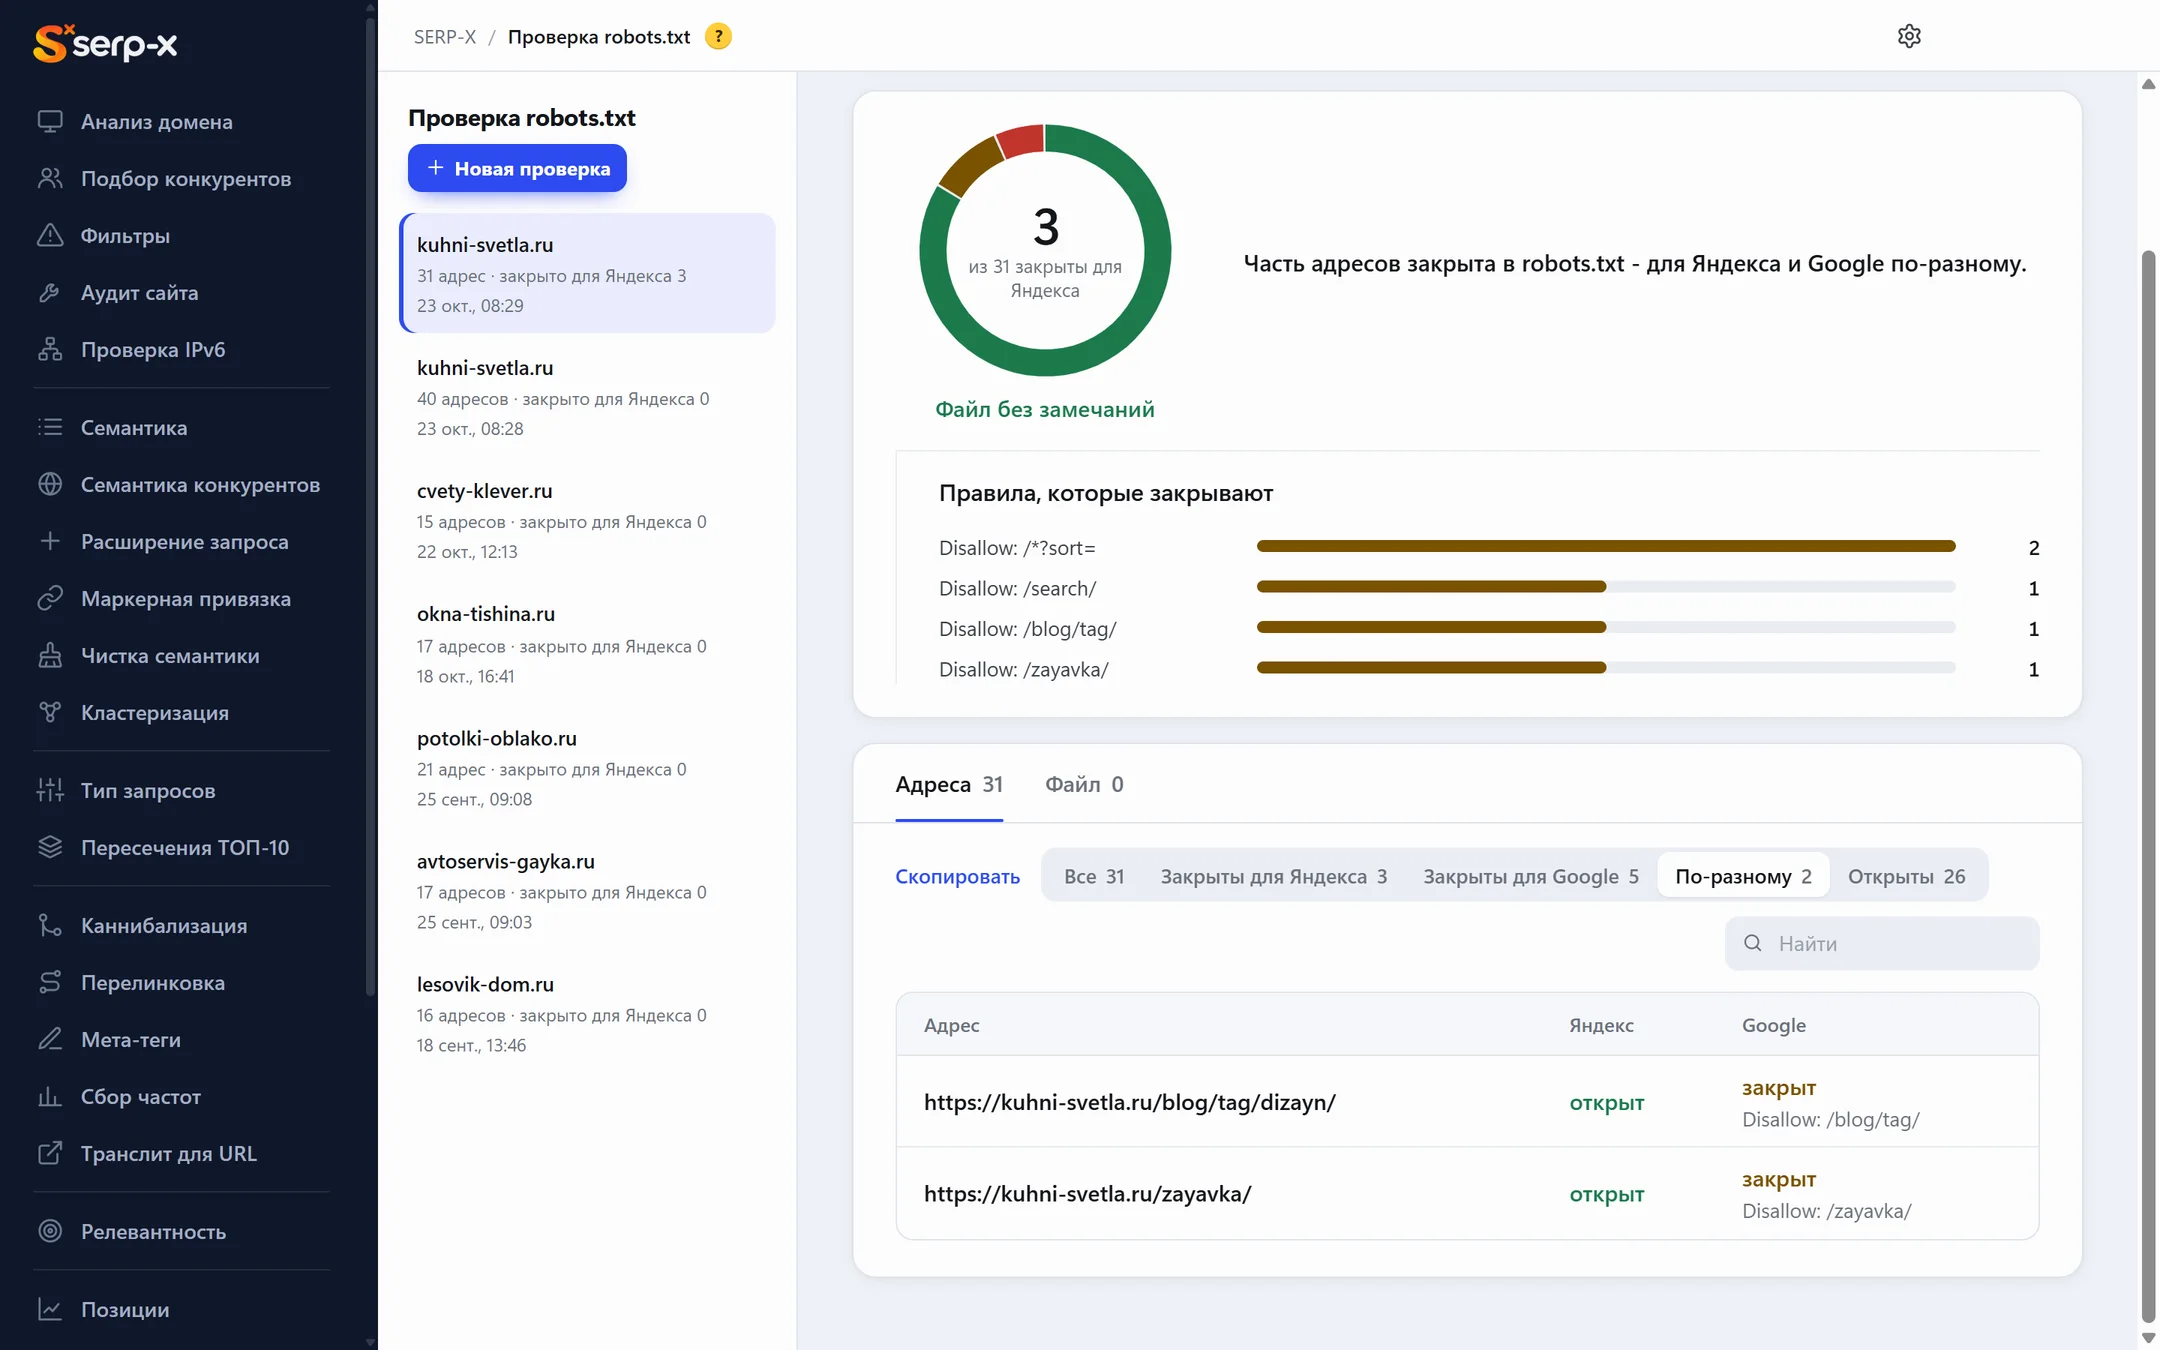
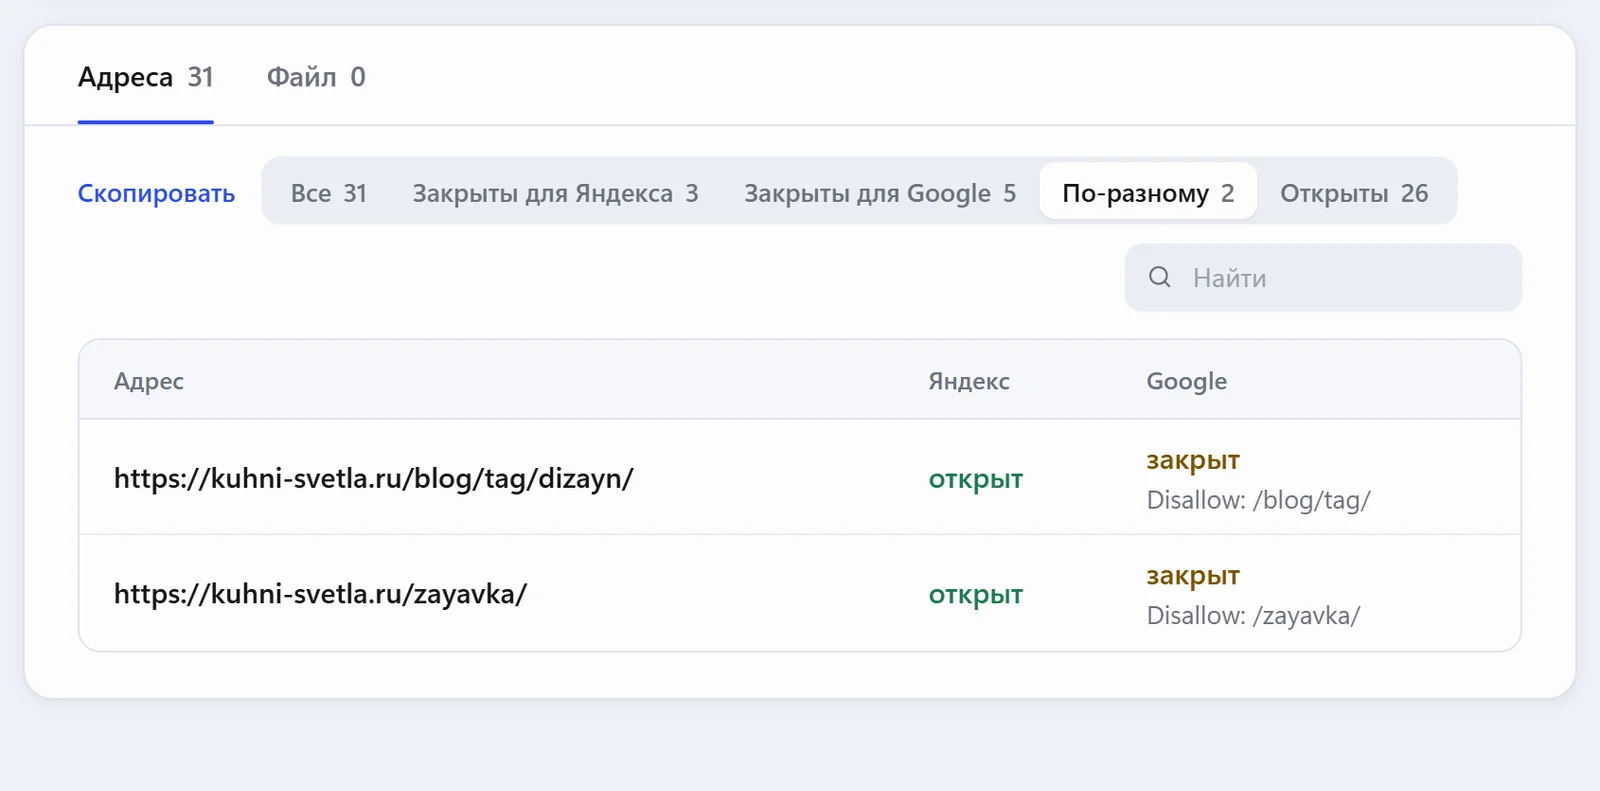
Яндекс и Google по-разному
Отдельные секции User-agent закрывают для одного поисковика то, что открыто для другого. Здесь это видно без чтения файла.
- Открыт или закрыт - для каждого
- Вкладка «Файл» - с номерами строк и замечаниями
- Excel
Преимущества
Почему удобно проверять robots.txt здесь
Два поисковика
Правила для Яндекса и Google разбираются отдельно, как это делают сами роботы.
Черновик до выкладки
Проверьте новый файл на реальных адресах, прежде чем он попадёт на сайт.
URL из sitemap.xml
Не нужно собирать список вручную - до 1 000 страниц возьмутся сами.
Какое правило решает
У каждого адреса - строка файла, которая его закрыла.
Ошибки файла
Замечания по синтаксису - на вкладке «Файл» с номерами строк.
Excel
Все адреса с решением для обоих поисковиков.
Подробно
Проверка robots.txt: как роботы читают правила
Robots.txt - текстовый файл в корне сайта (https://example.com/robots.txt) с правилами обхода для поисковых роботов: какие разделы можно сканировать, а какие нет. Ошибка в одной строке способна убрать из поиска каталог или весь ресурс, поэтому проверка robots.txt нужна после каждой правки файла, переезда, смены CMS и запуска новых разделов.
Основные директивы
- User-agent - для какого робота секция: * - для всех, Yandex или Googlebot - для конкретного поисковика.
- Disallow - запретить обход пути: Disallow: /search/ не пустит робота в результаты внутреннего поиска.
- Allow - разрешить путь внутри запрещённого: Allow: /blog/ вместе с Disallow: / оставит доступным только блог.
- Sitemap - где лежит sitemap.xml: Sitemap: https://example.com/sitemap.xml.
- Clean-param - директива Яндекса: какие GET-параметры, например utm-метки или сортировка, не меняют содержимое.
Символ * заменяет любую последовательность знаков, $ фиксирует конец строки. Директивы Host и Crawl-delay устарели: главное зеркало теперь задают 301-редиректом, а скорость обхода - в настройках Вебмастера.
Как робот выбирает правило
Робот ищет секцию со своим именем и только при её отсутствии берёт общую - User-agent: *. Правила общей секции на робота со своей секцией не действуют: если в секции Googlebot нет запрета на /admin/, Google туда пойдёт, даже когда в общей секции запрет есть.
Внутри секции побеждает самое длинное подходящее правило, а при равной длине оба поисковика выбирают Allow. Поэтому в сложном файле полезно видеть для каждого URL ту строку, которая решила дело.
Частые ошибки в robots.txt
- Disallow: / остался после разработки - сайт целиком недоступен для обхода.
- Запрещены папки с CSS и JavaScript: Google не может отрисовать страницу и хуже понимает её контент.
- Страница есть в sitemap.xml, но запрещена в robots.txt - роботы получают противоречивые сигналы.
- Через Disallow пытаются убрать страницу из индекса. Но запрет касается обхода, а не индексирования: URL, на который ведут ссылки, может остаться в поиске без описания. Для удаления используйте noindex и не запрещайте такую страницу в файле, иначе робот не увидит метатег.
- Опечатки и регистр: /Catalog/ и /catalog/ для робота разные пути.
- Файл отдаёт 404, 5xx или редирект: тогда поисковик действует по своим правилам, вплоть до остановки обхода всего сайта.
Как проверить файл
Синтаксис проверяют валидаторы: анализ robots.txt в Яндекс Вебмастере и отчёт о файле в Google Search Console показывают ошибки в строках и позволяют проверить отдельный URL. Но надёжнее прогнать через правила полный перечень важных страниц - карточки, категории, статьи блога - и убедиться, что ни одна из них не попала под запрет. Новые правила разумно проверять на черновике, до выкладки, а не на работающем сайте.
В SERP-X проверка robots.txt идёт по сайту и перечню URL или путей; если поле пустое, берутся до 1 000 страниц из sitemap.xml. Вместо файла с сайта можно вставить свой черновик и проверить его на реальных страницах до публикации. Для каждого URL видно, открыт ли он для Yandex и Googlebot и какая строка файла это решила. В итоге - правила с числом заблокированных страниц, на вкладке «Файл» - robots.txt с номерами строк и замечаниями, Clean-param тоже учитывается. Результат выгружается в Excel, а инструмент работает онлайн и бесплатно, в личном кабинете. Дальше можно собрать новую sitemap.xml и проверить индексацию.
Вопросы
Частые вопросы
Учитывает ли Clean-param?
Да, директивы Яндекса разбираются так же, как их понимает Яндекс.
Можно проверить файл до публикации?
Да. Вставьте черновик robots.txt - адреса проверятся по нему.
Откуда берутся адреса?
Из вашего списка или, если оставить пустым, - до 1 000 адресов из карты сайта.
Что если правила для Яндекса и Google расходятся?
Отбор «По-разному» покажет такие адреса и правила обеих секций.
Где должен лежать robots.txt?
В корне домена: https://example.com/robots.txt. У каждого поддомена и протокола свой файл, а сервер должен отдавать его с кодом 200.
Убирает ли Disallow страницу из поиска?
Не гарантирует: запрет касается обхода, а не индекса. Чтобы исключить страницу из поиска, используйте метатег noindex и не запрещайте её в robots.txt.
Проверка robots.txt - онлайн, бесплатно
Без установки и без карты - в личном кабинете SERP-X. Инструменты с выдачей и нейросетью - в программе для Windows.