Сбор частотности запросов
Частотность запросов - сколько людей на самом деле ищут фразу. Сбор частот берёт её из Wordstat сразу для всего списка: базовую, фразовую и точную, с регионом и устройствами, чтобы не тратить силы на запросы без спроса.
- Пять видов частот
- Регион и устройства
- Отбор по частоте
Как работает
Частотность списком - за минуты
Вставьте фразы
Списком или файлом; регион Wordstat и устройства.
Выберите частоты
W, "W", "!W", [W], "[!W]" - любые сразу.
Получите таблицу
Весь спрос, отбор по частоте, «Дособрать» пустые, Excel.
Что получите
Весь спрос - и где он
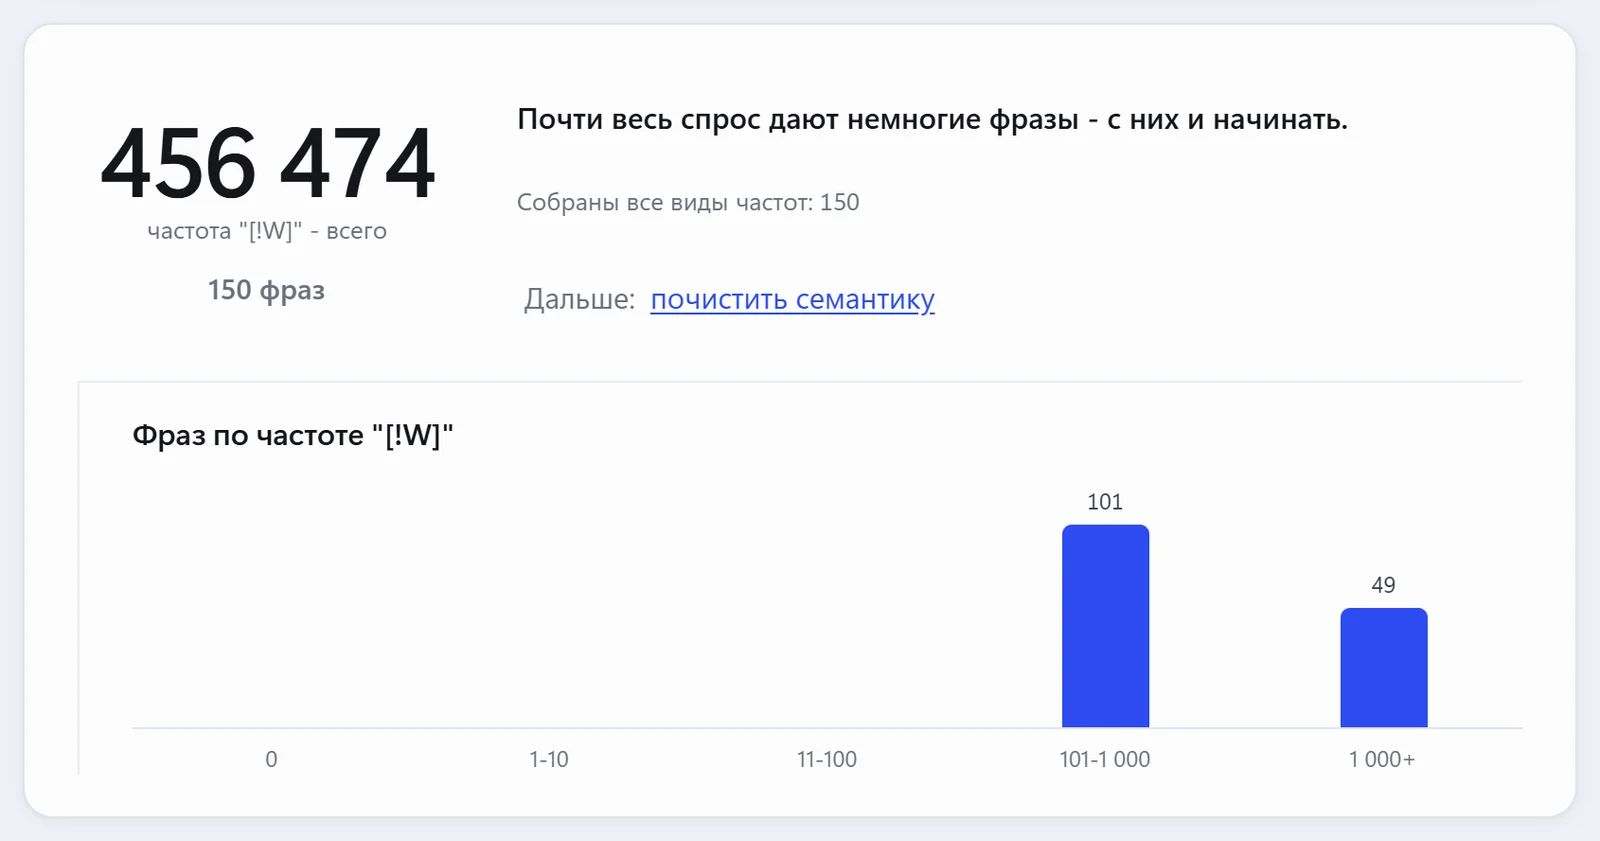
Итог
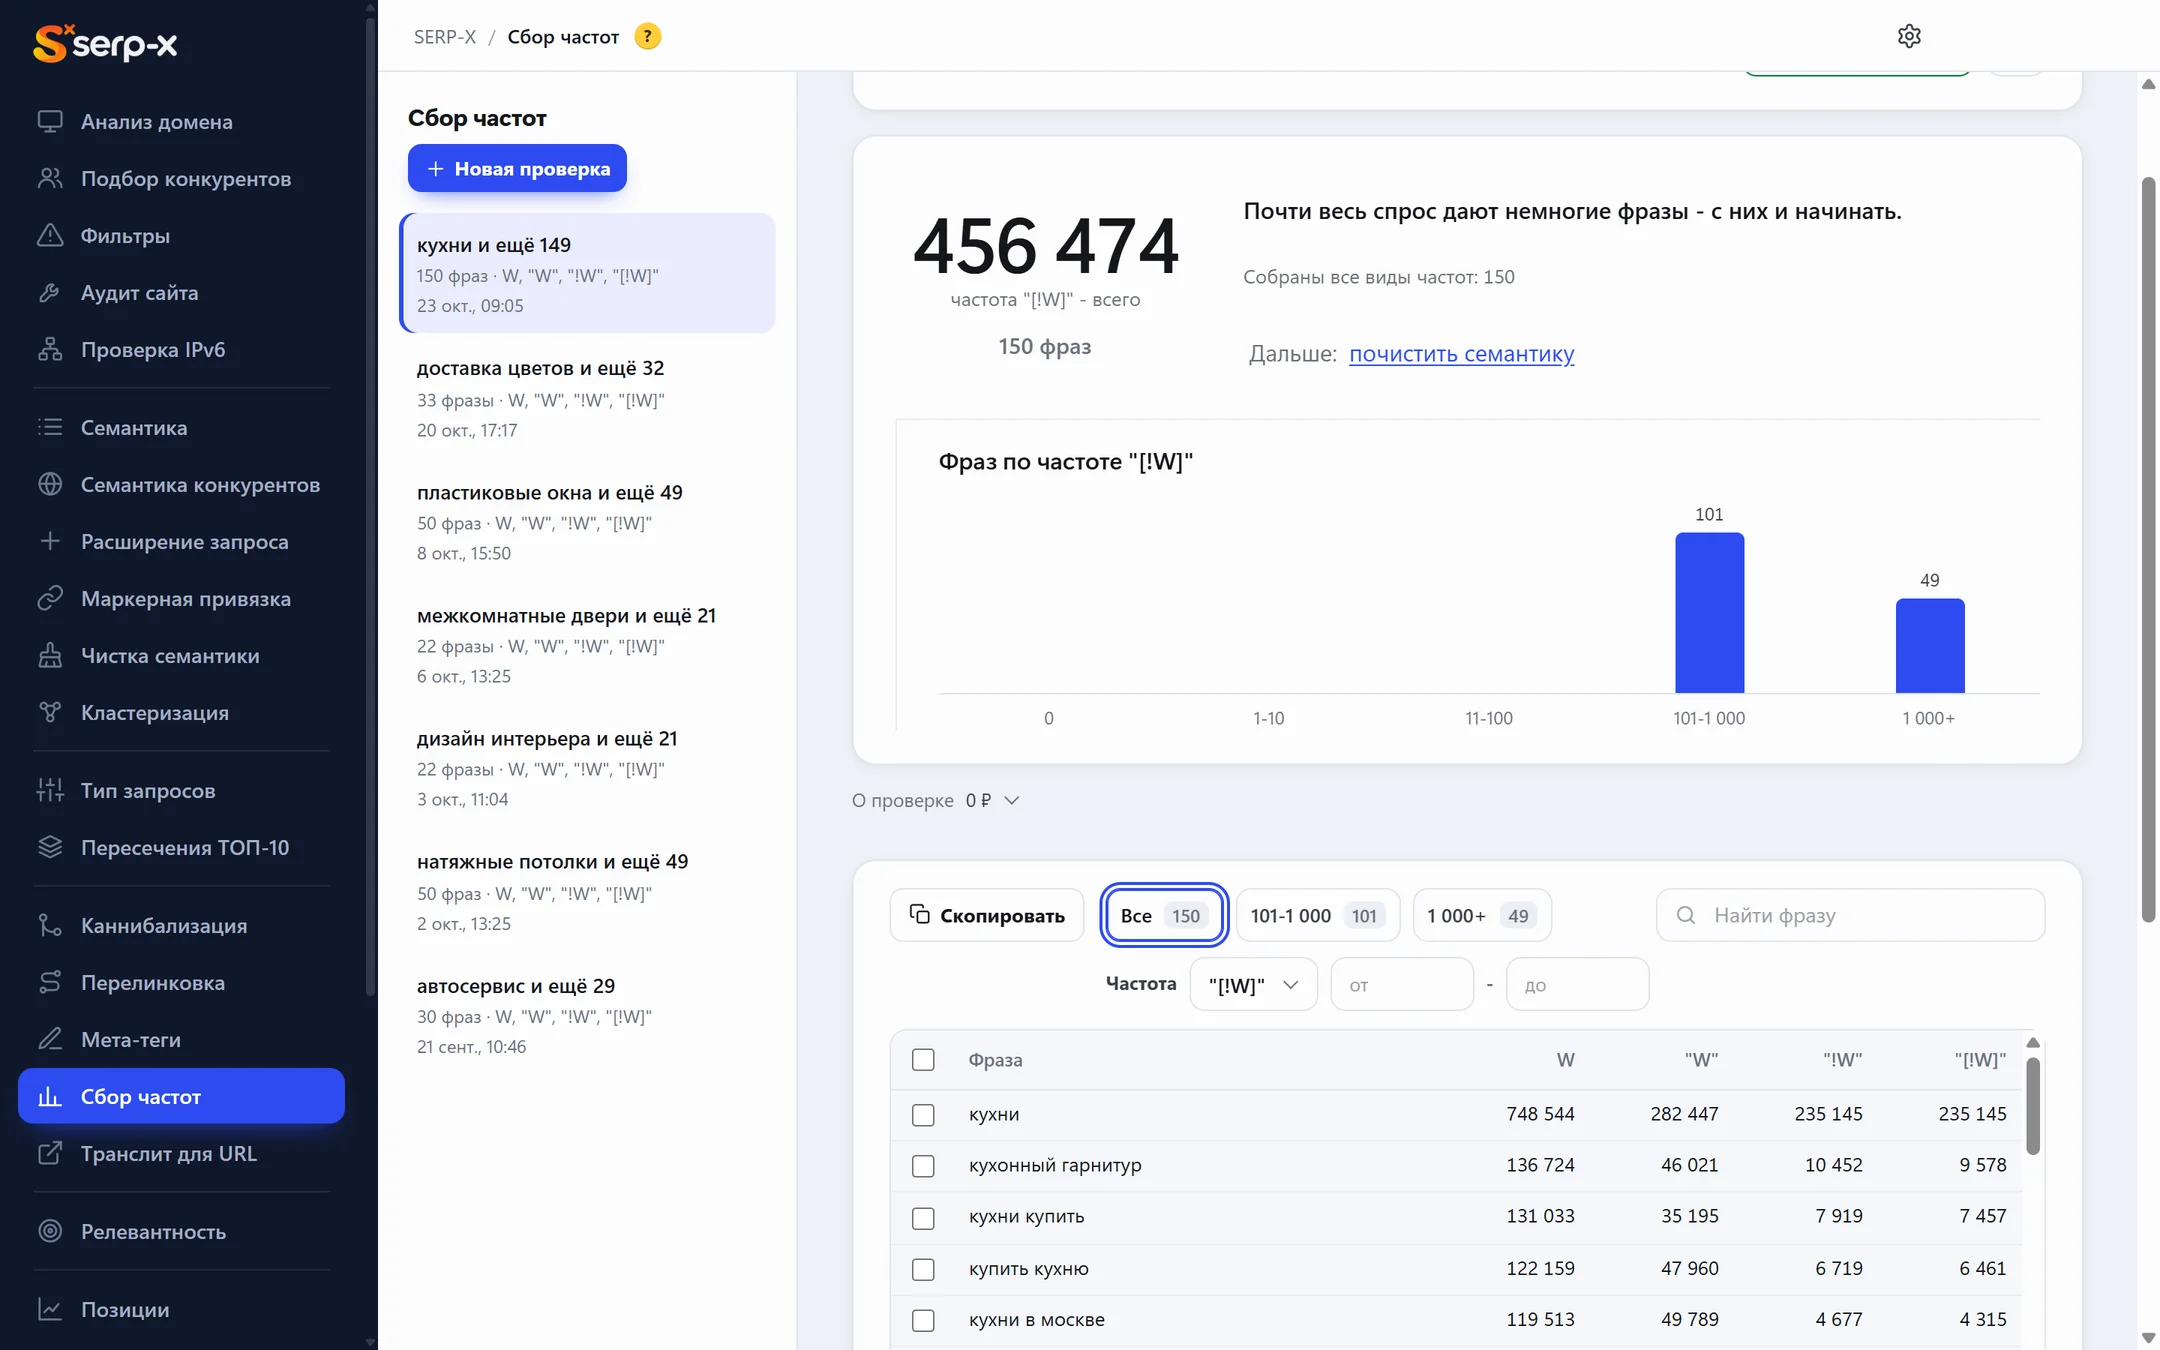
Весь спрос по точной частоте, сколько фраз дают основной спрос; справа - фразы по частоте столбиками.
- Сумма по точной частоте
- Распределение фраз
- Дальше - чистка семантики
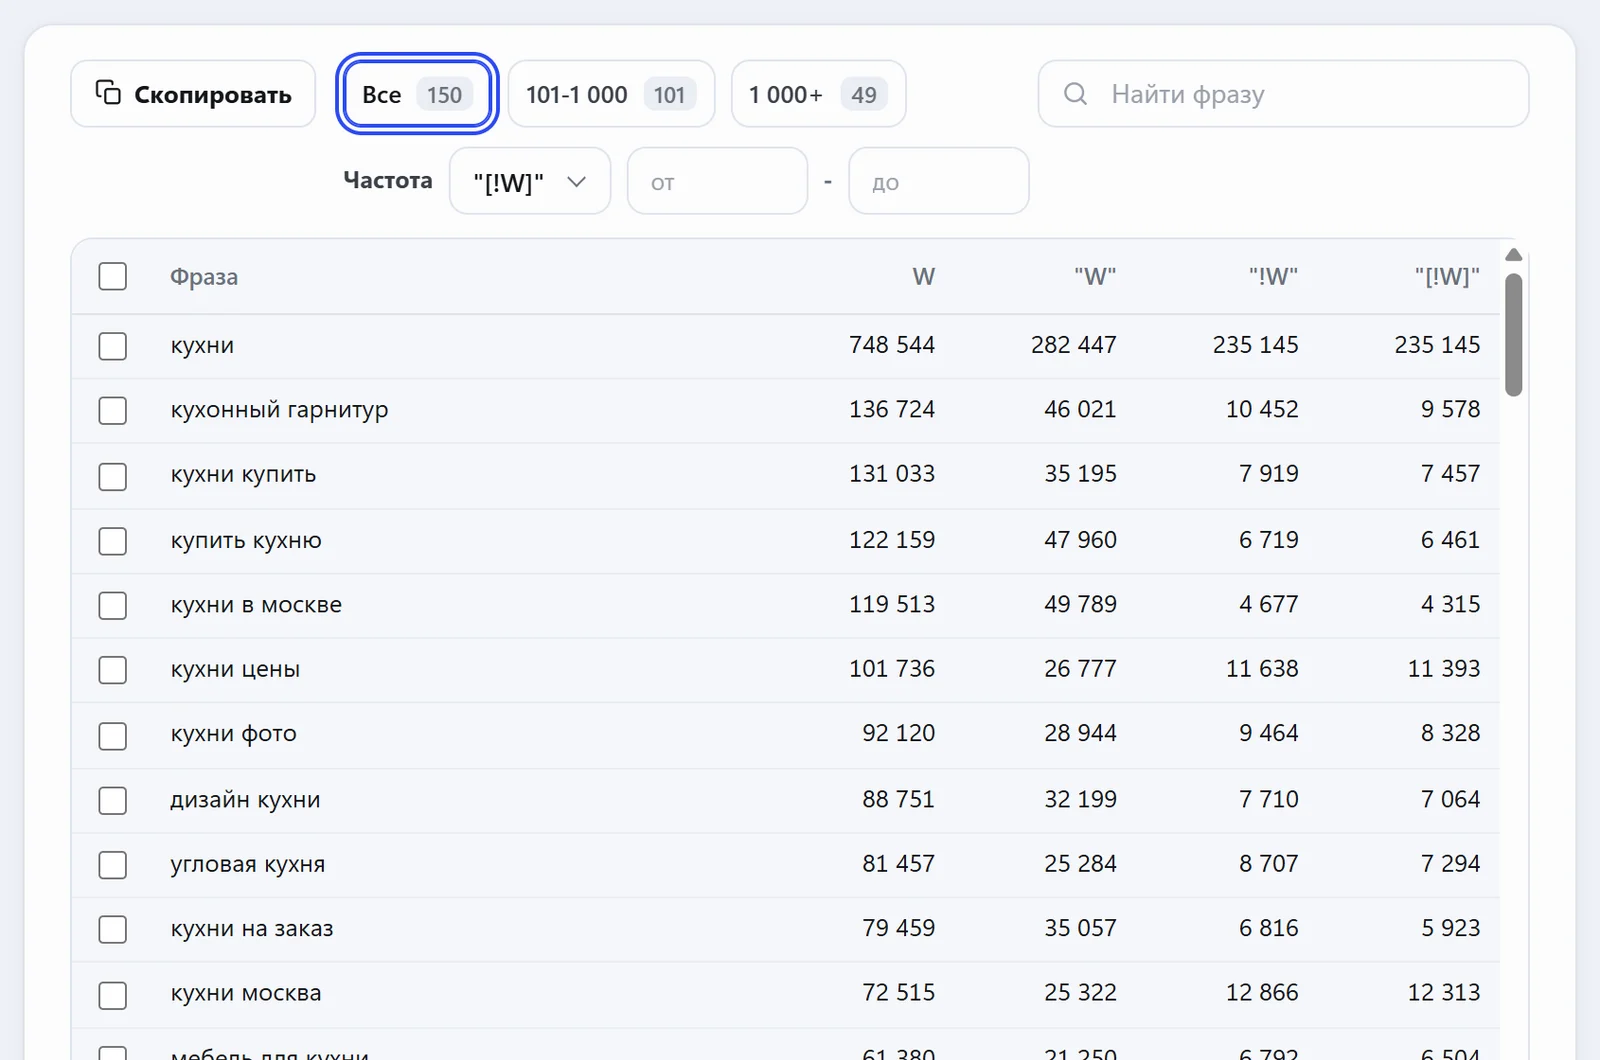
Пять видов частот
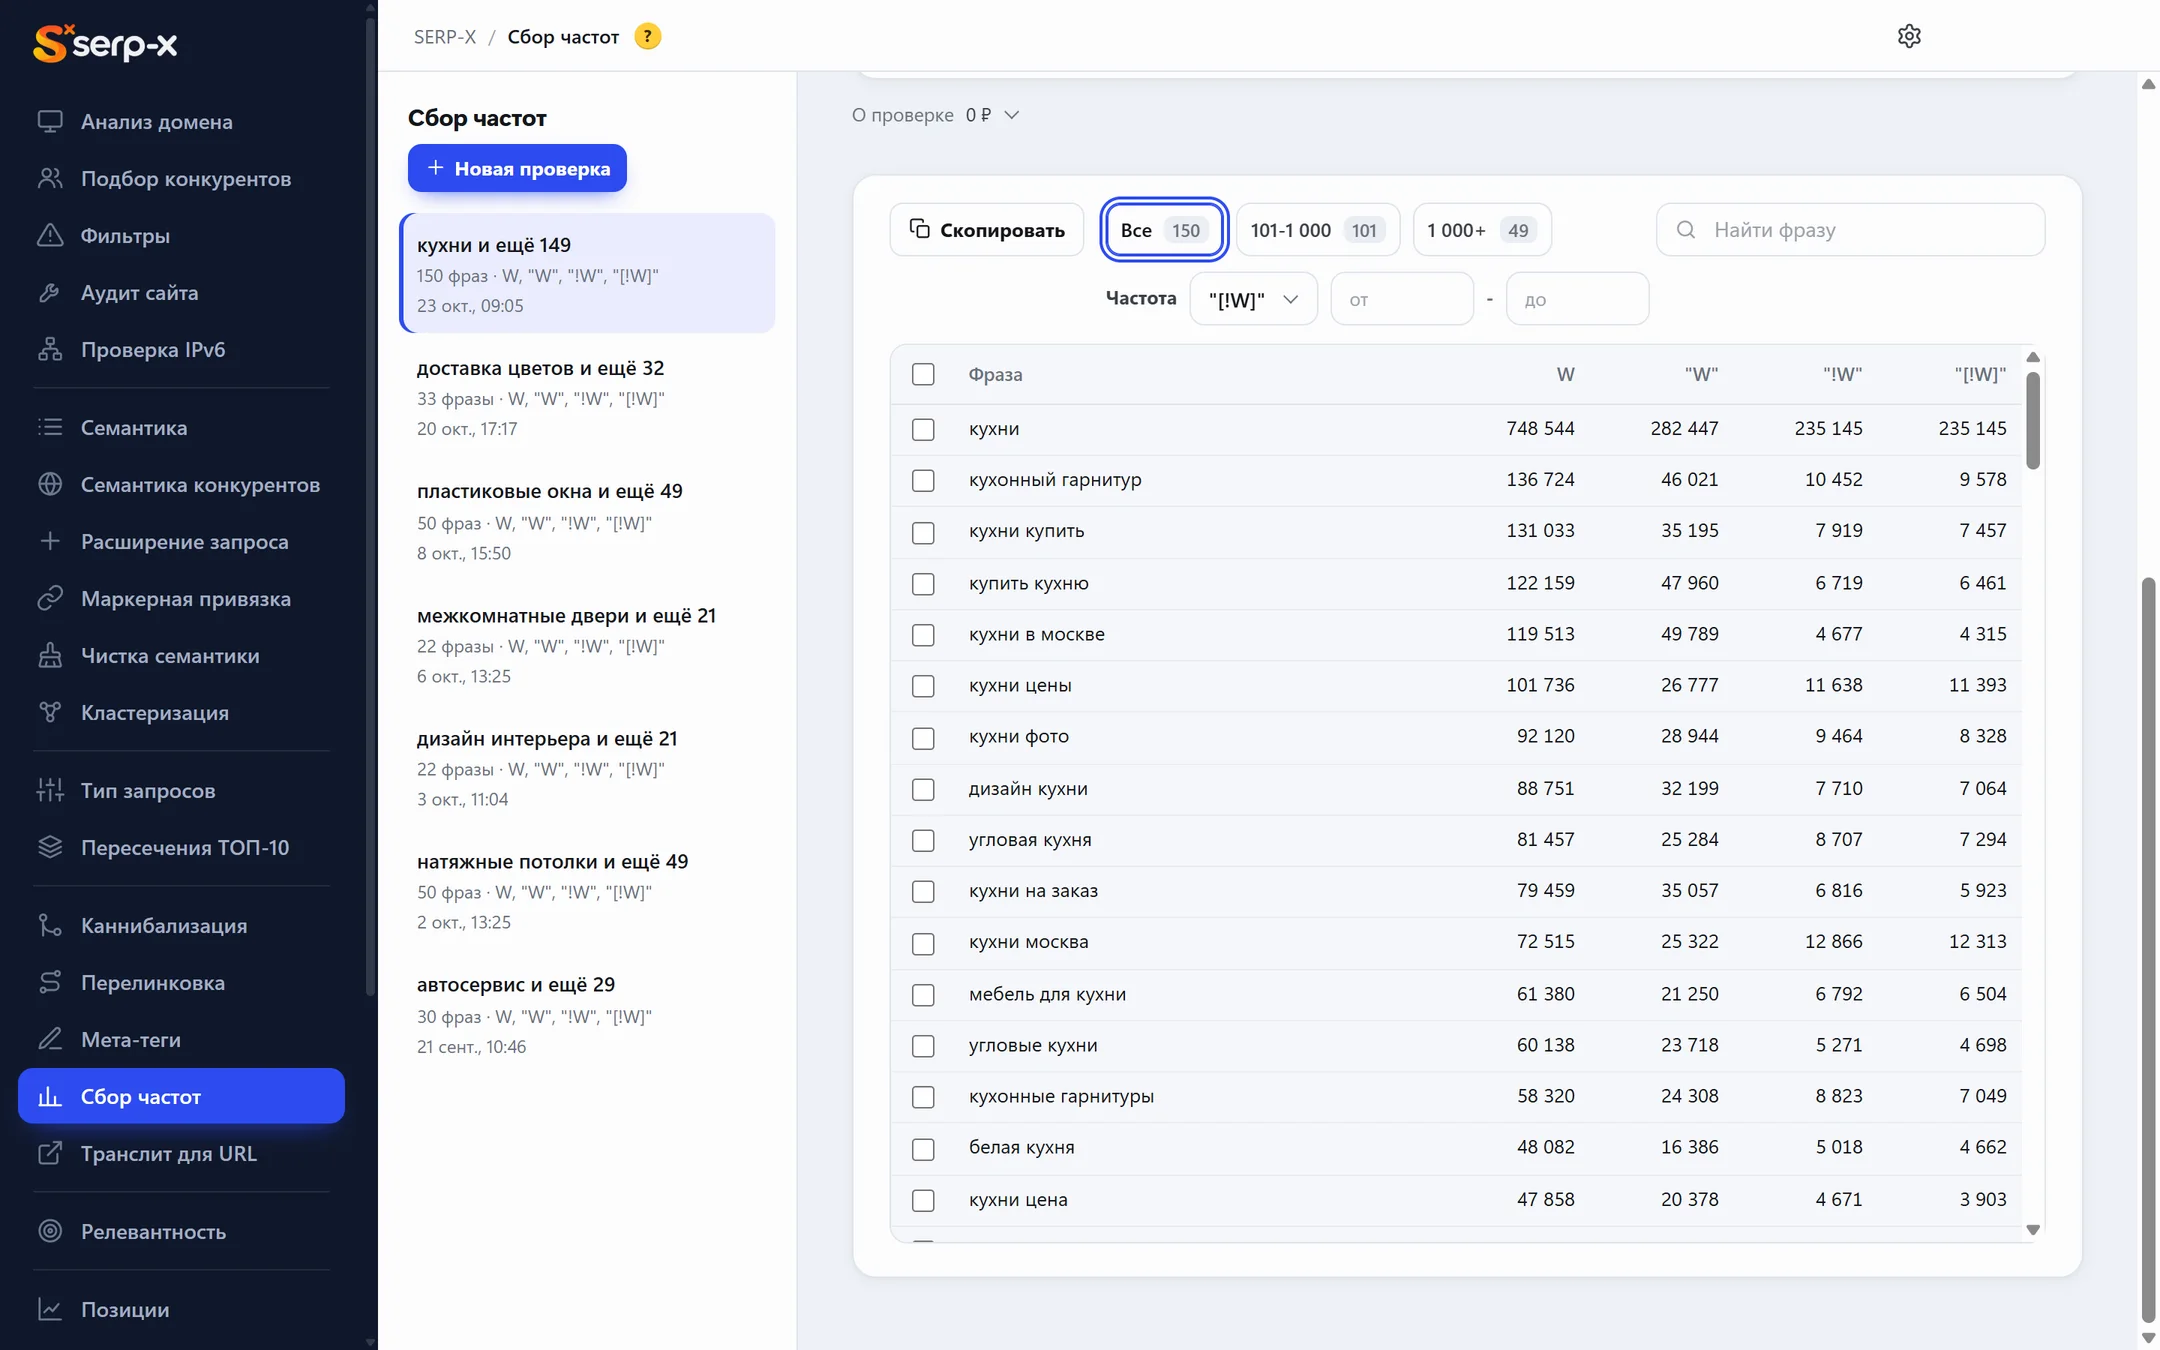
Каждая фраза - W, "W", "!W", [W], "[!W]": видно, где спрос реальный, а где набран чужими хвостами.
- Весь список прокруткой
- Сортировка по частоте
- Скопировать
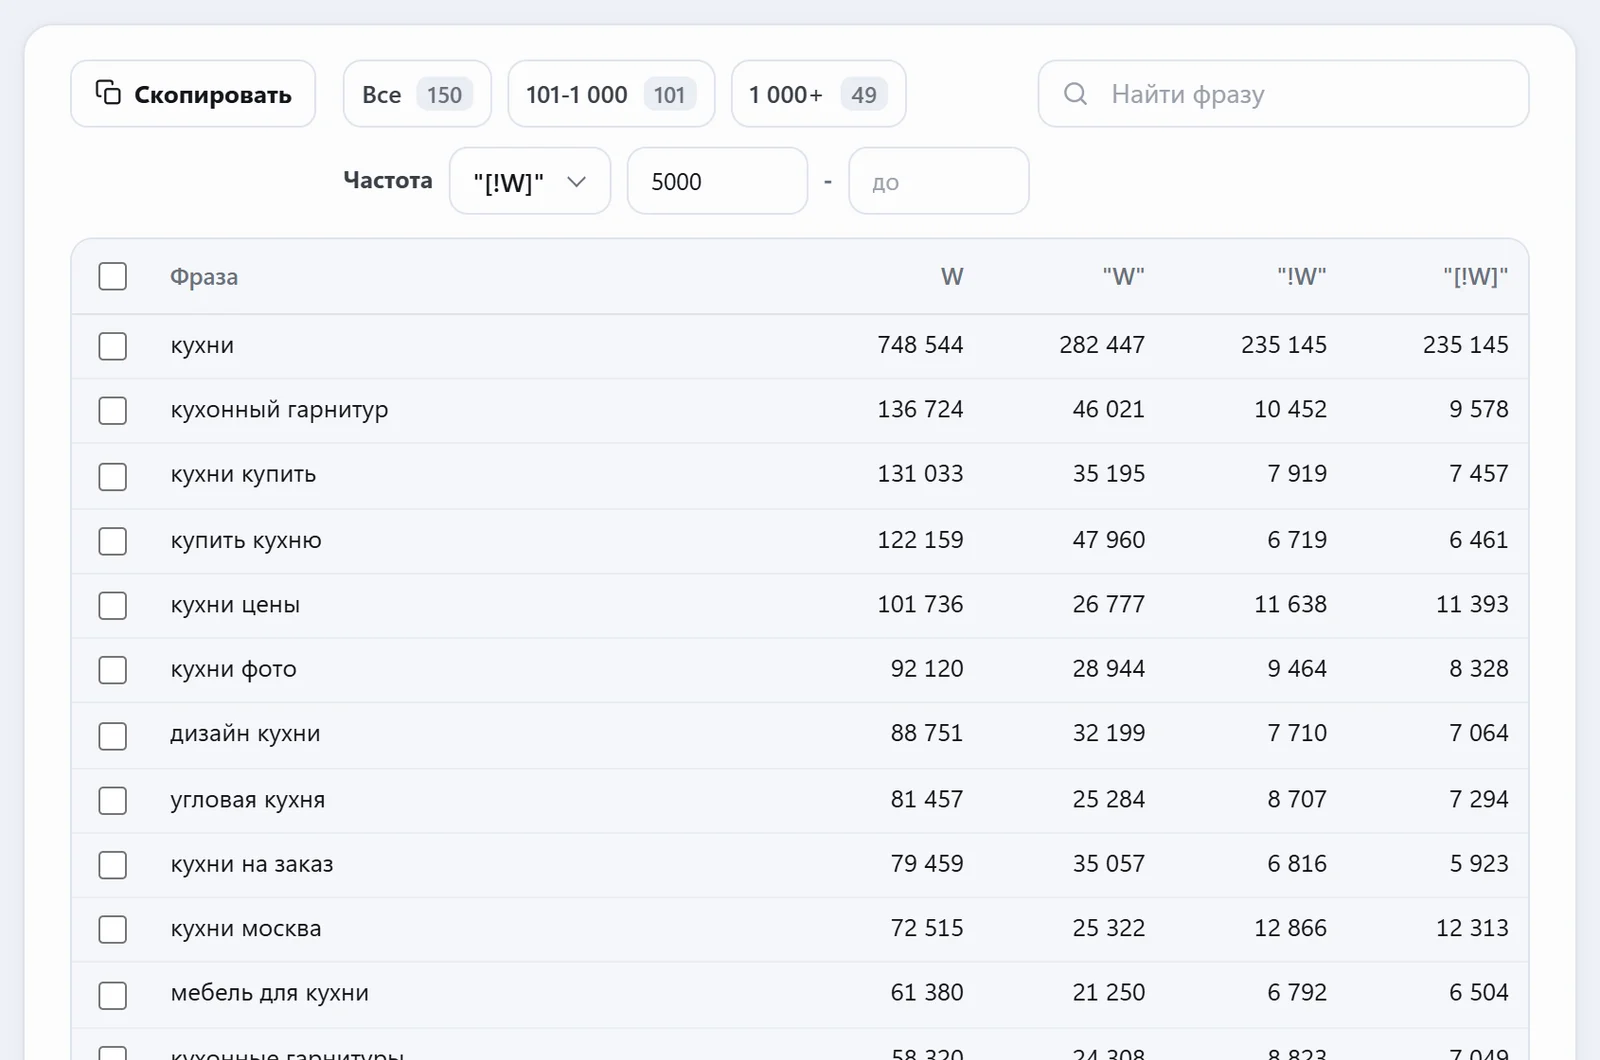
Отбор по частоте
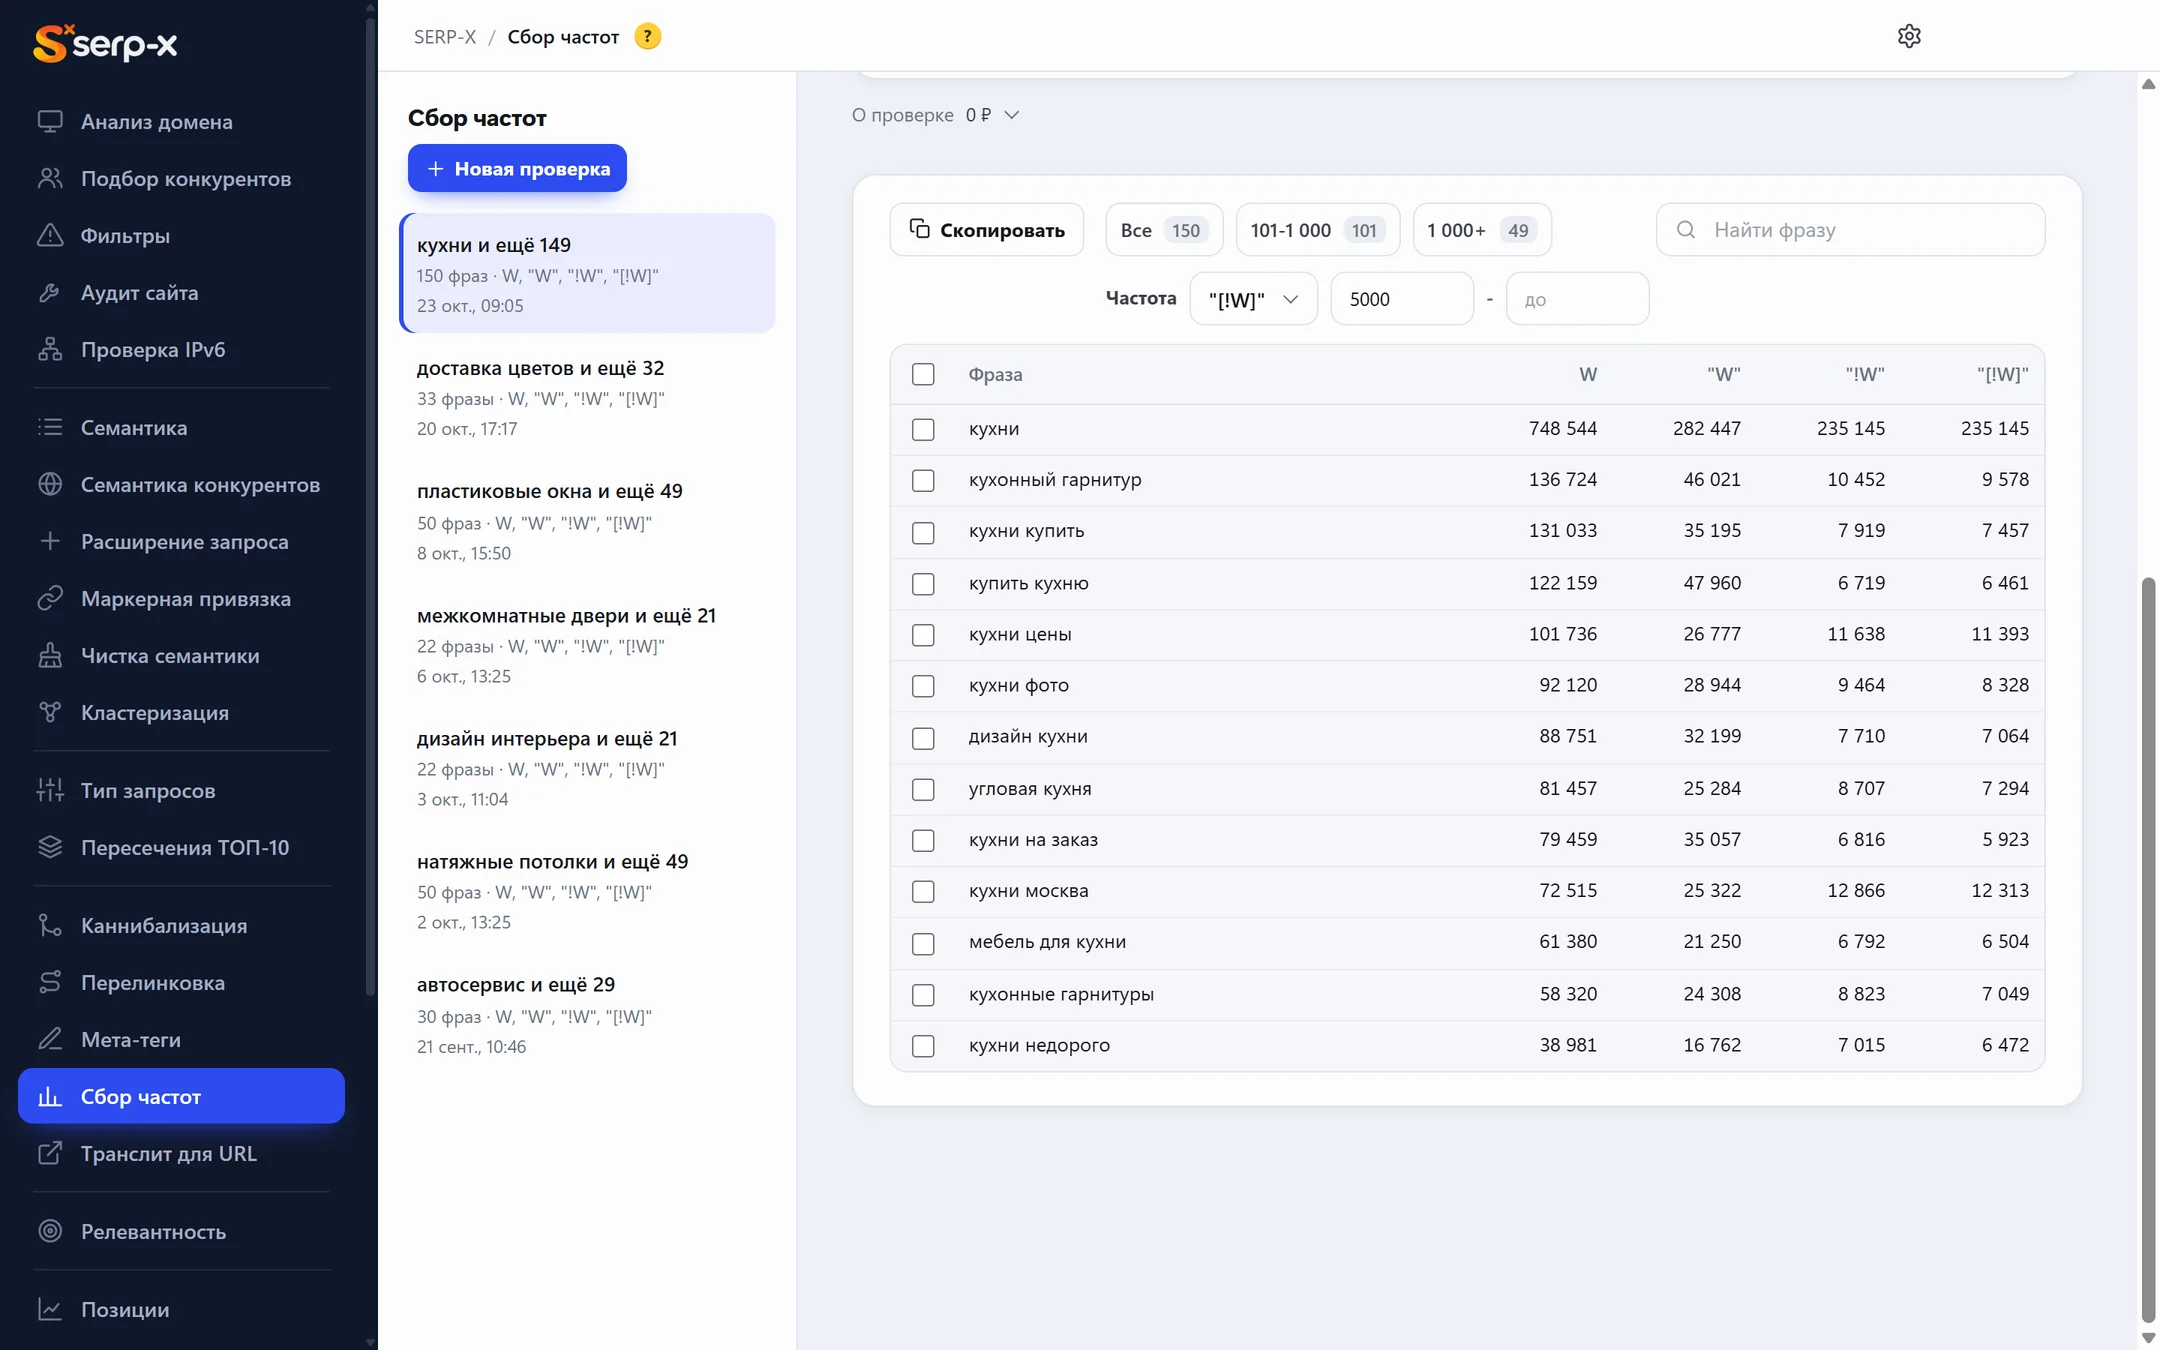
Частота «от» и «до» по любому виду - и в таблице остаются нужные фразы.
- Отборы 101-1 000 и 1 000+
- Поиск по фразе
- Excel
Преимущества
Почему удобно собирать частотность запросов в SERP-X
Все виды частот
W, "W", "!W", [W], "[!W]" - за один запуск.
Регион и устройства
Регион Wordstat на выбор; компьютеры, телефоны, планшеты.
Отбор по частоте
От и до - по базовой, фразовой или точной частотности.
Быстро
Много потоков; пауза при ограничении - сама.
Дособрать
Пустые частоты - одной кнопкой.
Excel
Фразы со всеми частотами.
Подробно
Частотность запросов: что это и как её проверить
Частотность запросов - это количество показов поисковой выдачи по фразе за месяц, то есть сколько раз пользователи ввели её в поисковой системе. По частотности выбирают ключевые слова для семантического ядра, оценивают будущий трафик и решают, под какие запросы делать отдельный раздел сайта, какие отдать статьям, а какие убрать.
Главный источник данных о частоте запросов в Яндексе - Вордстат (Wordstat). Он показывает статистику за последний месяц и историю по месяцам, с выбором региона и устройства.
Что показывает проверка частотности в Вордстате
Вордстат выдаёт два списка. В первом - все запросы, в которых есть слова из поля поиска, с базовой частотой: это источник новых ключевых фраз и хвостов. Во втором - похожие запросы, которые пользователи вводили вместе с вашим: другие названия товара и смежные темы. Ещё есть история по месяцам и распределение по регионам - эта информация нужна для определения сезонности и регионов, где запрос ищут чаще.
Типы частотности: базовая, фразовая и точная
Одна и та же фраза в Вордстате даёт разные числа в зависимости от оператора. Пример для запроса «купить диван»:
- Базовая (W) - без операторов. Учитывает все запросы, в которых есть эти слова, в том числе в других формах: «купить диван угловой», «где купить диван недорого» и сотни других хвостов. Подходит для оценки ниши, но завышает популярность самой фразы.
- Фразовая ("W") - фраза в кавычках. Только запросы из этих слов, без добавочных, но с другими формами и порядком.
- Точная ("!W") - кавычки и восклицательный знак перед словами: без добавочных слов и только в этой форме, «купить диван» без «купить диваны». Её смотрят, когда решают, нужна ли фраза в ядре.
- С порядком слов ([W] и "[!W]") - квадратные скобки закрепляют порядок: «диван купить» и «купить диван» считаются отдельно.
Разница между базовой и точной частотой бывает огромной. Если W измеряется тысячами, а !W - единицами, фразу почти не вводят саму по себе: её показатель набран за счёт чужих хвостов.
Как проверить частотность запросов
Вручную в Вордстате. Введите фразу в поле поиска, задайте регион и устройства, при необходимости добавьте операторы. Для десятка запросов этого достаточно, но ядро из нескольких тысяч фраз так проверять долго: операторы приходится писать руками, а результаты переносить в таблицу.
Массовая проверка. Key Collector, онлайн-сервисы и XML-интерфейсы снимают частотность для списка автоматически: вы загружаете список ключевых фраз файлом, выбираете параметры (регион, устройства, типы частот) и получаете результаты таблицей. Без такой обработки не обойтись при сборе семантического ядра и регулярной работе с большими проектами.
Google. Планировщик ключевых слов в Google Ads показывает среднее число запросов в месяц, а при небольших рекламных бюджетах - диапазоны. Для продвижения в Яндексе ориентир - Вордстат.
Высокочастотные, среднечастотные и низкочастотные запросы
По частотности ключевые запросы делят на ВЧ, СЧ и НЧ. Границы зависят от ниши: в массовой тематике высокочастотным считают запрос от 10 000 показов в месяц, а в узкой B2B-нише и 500 показов - много. Поэтому делить стоит относительно своей ниши, а не по общей таблице.
- Высокочастотные - общие запросы вроде «диваны». Дают большой трафик, но конкуренция за них самая высокая; их продвигают главной или категориями.
- Среднечастотные - уточнённые запросы вроде «угловой диван-кровать», основа для подкатегорий.
- Низкочастотные - длинные хвосты с маркой, размером, городом. Каждый даёт немного трафика, но вместе они приносят заметную часть заказов, а продвинуться по ним проще.
Регион, устройства и сезонность
Частотность зависит от региона: запрос «доставка цветов» в Москве и в Казани - это разные цифры и разные конкуренты. Для локального бизнеса частоту снимают по своему городу, а не по всей России, иначе в ядро попадут фразы, которые в вашем регионе почти не ищут.
Устройства тоже важны: в одних тематиках большая часть запросов идёт с телефонов, в других - с компьютеров. Сезонность видна в истории по месяцам: интерес к кондиционерам летом и зимой отличается в разы, и решение по фразе, принятое по одному месяцу, может оказаться ошибкой.
Как использовать данные о частотности
- Отсеять пустые ключевые фразы, у которых точная частота нулевая или почти нулевая.
- Выбрать главный запрос раздела - самый частотный по точной частоте в своём кластере.
- Расставить приоритеты: сначала разделы с наибольшим суммарным спросом.
- Оценить целевой трафик: частотность умножают на долю кликов, которую даёт ожидаемая позиция.
- Спланировать рекламу: по частотности прикидывают количество показов и бюджет в Директе.
Частые ошибки
Смотреть только на базовую частотность и строить ядро на ключевых фразах, которые никто не вводит. Снимать частоту по всей России для сайта, который работает в одном городе. Принимать решения по одному месяцу без учёта сезона. Доверять резким всплескам: скачок без видимой причины часто означает накрутку ботами, а не живой интерес.
В SERP-X частотность запросов собирает инструмент «Сбор частот» - из Wordstat через XMLRiver: ключ подключается в «Сервисах», оплата - по тарифу XMLRiver. Фразы вставляют списком или файлом, выбирают регион Wordstat, устройства и нужные типы частот - все пять за один запуск. Сбор идёт во много потоков и сам встаёт на паузу при ограничении. В итоге видно, сколько фраз дают 80% всего спроса и сколько нулевые; есть отбор «от» и «до», «Дособрать» для пустых и выгрузка в Excel. Дальше список удобно почистить и разложить по кластерам.
Вопросы
Частые вопросы
Чем "!W" отличается от "[!W]"?
"!W" - только эти слова в этой форме, "[!W]" - ещё и в этом порядке. Это самая точная частота фразы.
Откуда частоты?
Из Wordstat Яндекса через XMLRiver - ключ подключается в «Сервисах».
Сколько фраз за раз?
Тысячи - фразы можно вставить файлом.
Что делать с нулевыми?
«Дособрать» соберёт пустые заново; нулевые по точной частоте - кандидаты на удаление.
Что такое частотность запросов?
Число показов выдачи по фразе за месяц: сколько раз её ввели в поиске Яндекса. В Wordstat частотность смотрят по региону и устройствам.
Какую частотность смотреть при сборе ядра?
Точную (!W): она показывает, сколько раз ищут именно эту фразу. Базовая годится для оценки ниши, но завышает популярность длинных фраз.
Как часто обновлять данные о частотности?
Перед сбором ядра и при его обновлении. В сезонных нишах - заранее, до сезона: в истории Вордстата видно, в какие месяцы запросы растут.
Почему частотность не равна трафику?
Частотность - это показы, а не клики: часть людей уходит в рекламу, Карты и ответы прямо в поиске. Трафик зависит от позиции сайта, сниппета и того, что стоит над ним в выдаче.
Ещё в разделе «Структура и страницы»
Сбор частот - в программе SERP-X
Все инструменты в одной программе для Windows. Начать можно бесплатно.